5.4 写放大与写停顿排错实录
5.4 写放大与写停顿排错实录:一次停顿风暴的完整对账
本节摘要:本节是一份完整的排错卷宗:某订单服务的批量回填任务引爆写停顿,写入延迟从毫秒级恶化到数十秒。我们按审计流程走完全程——取证哪些指标、第一直觉为什么错了、真正的根因藏在哪、纠正分几步落地、每一步数字怎么变化,最后把复盘沉淀成一张可复用的诊断决策树。前三节的所有机制,都会在这份卷宗里现出原形。
凌晨一点十七分的连环告警
先交代背景。某电商订单服务用 RocksDB 存订单索引,日常写入每秒五万笔上下,点查为主,P99 写延迟两毫秒,运行大半年一直太平。某个周四凌晨,数据团队启动历史订单回填任务——把三年前的存量订单从老系统搬进来,预计两天灌入四亿条。任务上线四小时后,线上写入延迟告警:P99 从两毫秒跳到三百毫秒;又过一小时,恶化到十秒以上,客户端开始大面积超时重试,正常业务写入也被殃及。凌晨一点十七分,值班群炸了。
现场第一步是止血而非找因:回填任务先暂停,写入延迟两分钟内回落到十毫秒级——虽然仍不正常,但业务恢复了。这一步同时给出了最重要的线索:病灶与回填强相关,且系统处于「欠账未清」状态,因为止血后延迟没有立刻回到基线。
取证:把四组证据摆上桌
止血之后开始正式对账。按本章建立的账目顺序,依次取了四组证据。
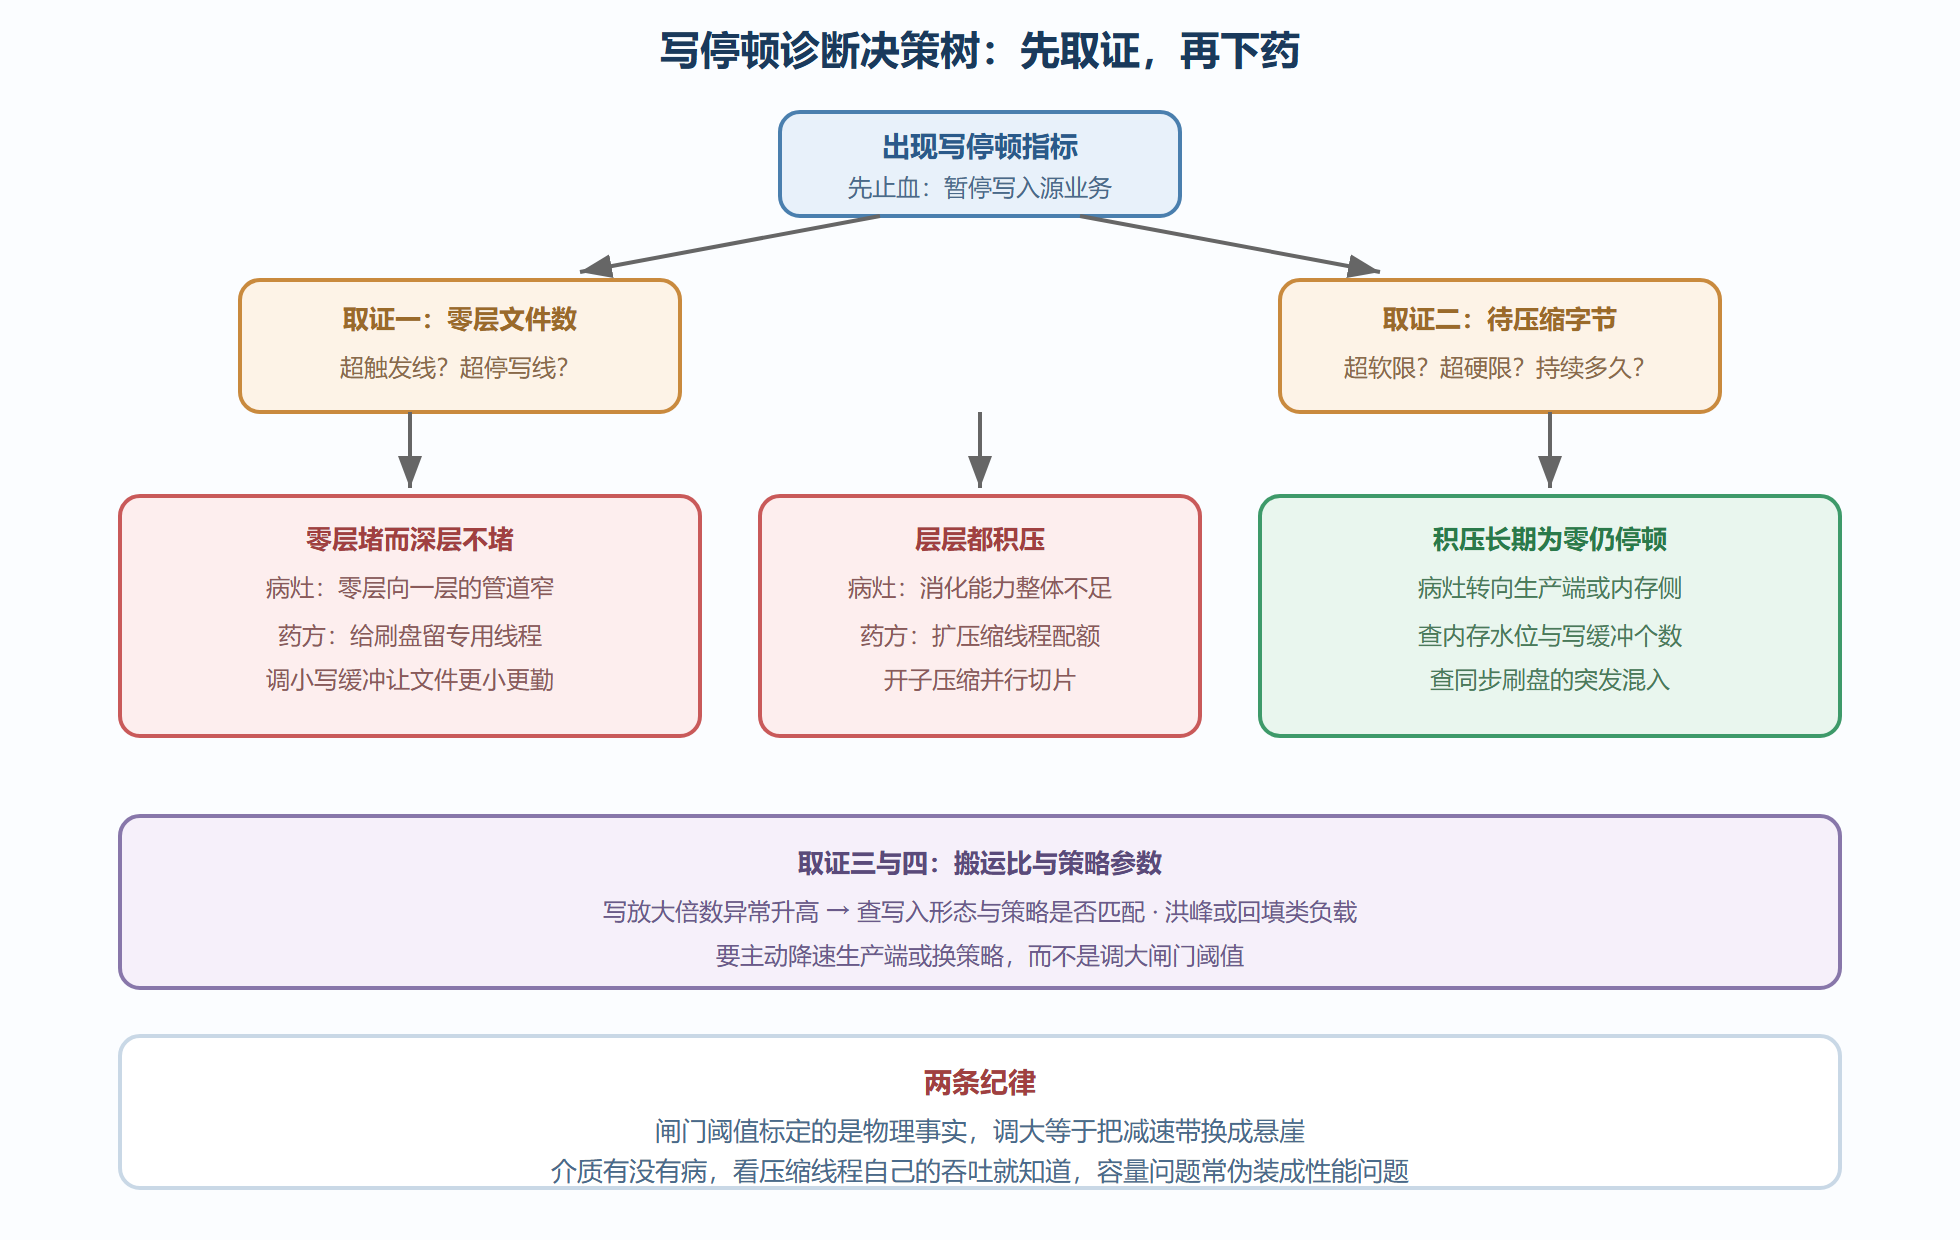
第一组,零层文件数。曲线显示回填期间从个位数一路爬到三十六——正好是写入被完全叫停的默认红线。也就是说,停顿风暴的主犯是「零层文件数超限」这第二道闸门:刷盘产出的零层文件,比压缩往一层搬运的速度快,堆到红线,引擎干脆把前台写入整个摁住。
第二组,待压缩字节。回填期间长期维持在两百 GB 以上,远超软限——这说明不只是零层堵,深层管道整体积水。压缩写入速率的曲线同步显示:压缩线程其实一直在满负荷跑,没有偷懒。
第三组,写放大系数。用压缩与刷盘的写入字节除以业务写入字节,回填期间实测十四倍——比日常的三点五倍翻了四番。搬运比失控印证了积压的来源:每灌一笔数据,引擎要额外搬运十几笔。
第四组,最容易被忽略的一组:压缩策略与参数清单。这台实例用的默认层级式压缩,零层触发归并的阈值是四个文件,压缩后台线程是默认配额两个。回填任务的写入形态是「均匀、无洪峰、持续大吞吐」——理论上是压缩系统最擅长消化的形状,却把默认配置打穿了。
误诊弯路:两个昂贵的错误直觉
卷宗里必须如实记录两条弯路,它们比根因本身更有教学价值。
第一条弯路:调大闸门阈值。值班同学的第一反应是「把零层停写阈值从三十六调到八十,先让回填跑完」。结果更糟:零层堆到六十多个文件,点查延迟先崩了——第 4 章讲过,零层文件数直接决定点查要翻多少个文件。这就是「把减速带换成悬崖」的现场版:闸门的阈值不是随手定的数字,它标定的是「读路径能容忍多少零层文件」这个物理事实,调大它等于宣布读路径可以牺牲。
第二条弯路:怀疑介质性能。延迟飙到十秒后,有人提出「磁盘是不是坏了」,差点启动换盘流程。证伪只需要一步:看压缩线程自己的写入吞吐——它稳定吃满了介质带宽的四分之三以上,介质没问题,只是账目积压太多、任何一笔新写入都要排长队。容量问题伪装成性能问题,是存储排错里最常见的易容术。
图5-3 写停顿诊断决策树
根因与分步纠正
四组证据拼出的根因并不复杂:这是一场「生产端形态变化 × 消化端默认配置」的合谋事故。回填把写入吞吐拉高六倍,而压缩侧还是给日常负载配的默认家底——两个线程的消化能力、按日常负载校准的触发阈值,全都对不上新形态。引擎的停顿机制全程按设计工作,真正的问题是我们让引擎背着日常负载的装备去打回填的仗。
纠正分四步落地,每步都单独验证。第一步,回填任务限速:把灌入速率压到压缩消化能力之下,这是最便宜的解——生产端降一档,胜过消化端扩三档。第二步,扩消化端:压缩后台线程从两个提到六个,刷盘单独留一个专用线程;待压缩字节积压峰值从两百 GB 降到四十 GB 以内。第三步,调整文件节奏:写缓冲调小一档,零层文件来得更小更勤,单次归并的输入更轻,零层文件数稳定压回触发线以内。第四步,给回填任务加「压缩健康度联动」:脚本每分钟看待压缩字节,超过一百 GB 自动降低灌入速率——让生产端自己学会看后台的账。
复跑回填的结果:灌完四亿条总耗时比第一次尝试多花百分之九,但全程写入延迟稳定在毫秒级,线上业务零感知,停顿告警一次未响。用百分之九的时间换零事故,这笔账怎么算都划算。
变式与自查清单
把这次卷宗的经验推到同类场景。变式一,夜间批量任务的通用配方都一样:先测消化能力上限,再定灌入速率,让生产端始终跑在消化端的百分之七十以内。变式二,如果你的负载长期像「回填」——持续大吞吐写入是常态而非偶发,那要动的就不是参数而是策略:按 5.2 节的报价单,通用式压缩对这类负载更合适,这台实例后来也确实迁到了通用式,写放大常态值从三点五降到一点八。变式三,多列族实例要按列族分别对账:一个列族的回填会占满全局压缩线程,把别的列族一起拖进停顿,隔离手段是给关键列族单独的线程池配额。
最后沉淀一份停顿自查清单,按序执行:一看停顿发生在哪道闸门(内存、零层、待压字节,三选一);二看积压水位与持续时间;三看压缩线程自己的吞吐定介质嫌疑;四看写放大倍数定策略匹配度;五查最近有没有写入形态变化(回填、新业务上线、活动流量)。五步走完仍无头绪,才轮到深挖引擎内部的非常规手段——按这份卷宗的经验,百分之九十的停顿在前三步就现形了。
把复盘沉淀为三项巡检
卷宗归档前,把教训转成机器可执行的巡检项,这才算真正闭环。其一,回填类任务上线前的强制项:测算消化端上限并声明灌入速率,脚本写入任务模板,没有速率声明不允许启动批量写入。其二,「最老积压年龄」告警:待压缩字节持续非零的时长设红线,超过即通知值班——它比「积压量」早数小时预报停顿。其三,闸门阈值纳入变更审计:任何调大停顿阈值的变更必须附带「读路径容忍度」的论证材料,无论证不审批。三项巡检上线的那个季度起,这台实例再没有出现过同一形态的停顿风暴。
本节要点
- 停顿风暴的标准病灶是「生产端形态变化 × 消化端默认配置」的合谋,引擎机制本身往往无辜;
- 取证顺序固定四步:零层文件数、待压缩字节、写放大倍数、策略与参数清单;
- 调大闸门阈值是最危险的「止血」:它标定的是读路径的物理容忍度,不是随便的报警线;
- 容量问题常伪装成性能问题,压缩线程自己的吞吐是鉴别介质嫌疑的第一证据;
- 纠正的优先级:先降生产端速率,再扩消化端配额,然后调文件节奏,最后才考虑换策略。