3.2 长期记忆:向量检索的参数与工程账
3.2 长期记忆:向量检索的参数与工程账
本节摘要:长期记忆的默认形态是"向量库 + 元数据":条目被嵌入成语义坐标,检索时按相似度取回。本节走通写入与检索的完整链路,逐个讲清嵌入模型、top_k、相似度阈值、元数据过滤这些参数的影响与建议值,最后算一笔常被漏算的工程账。
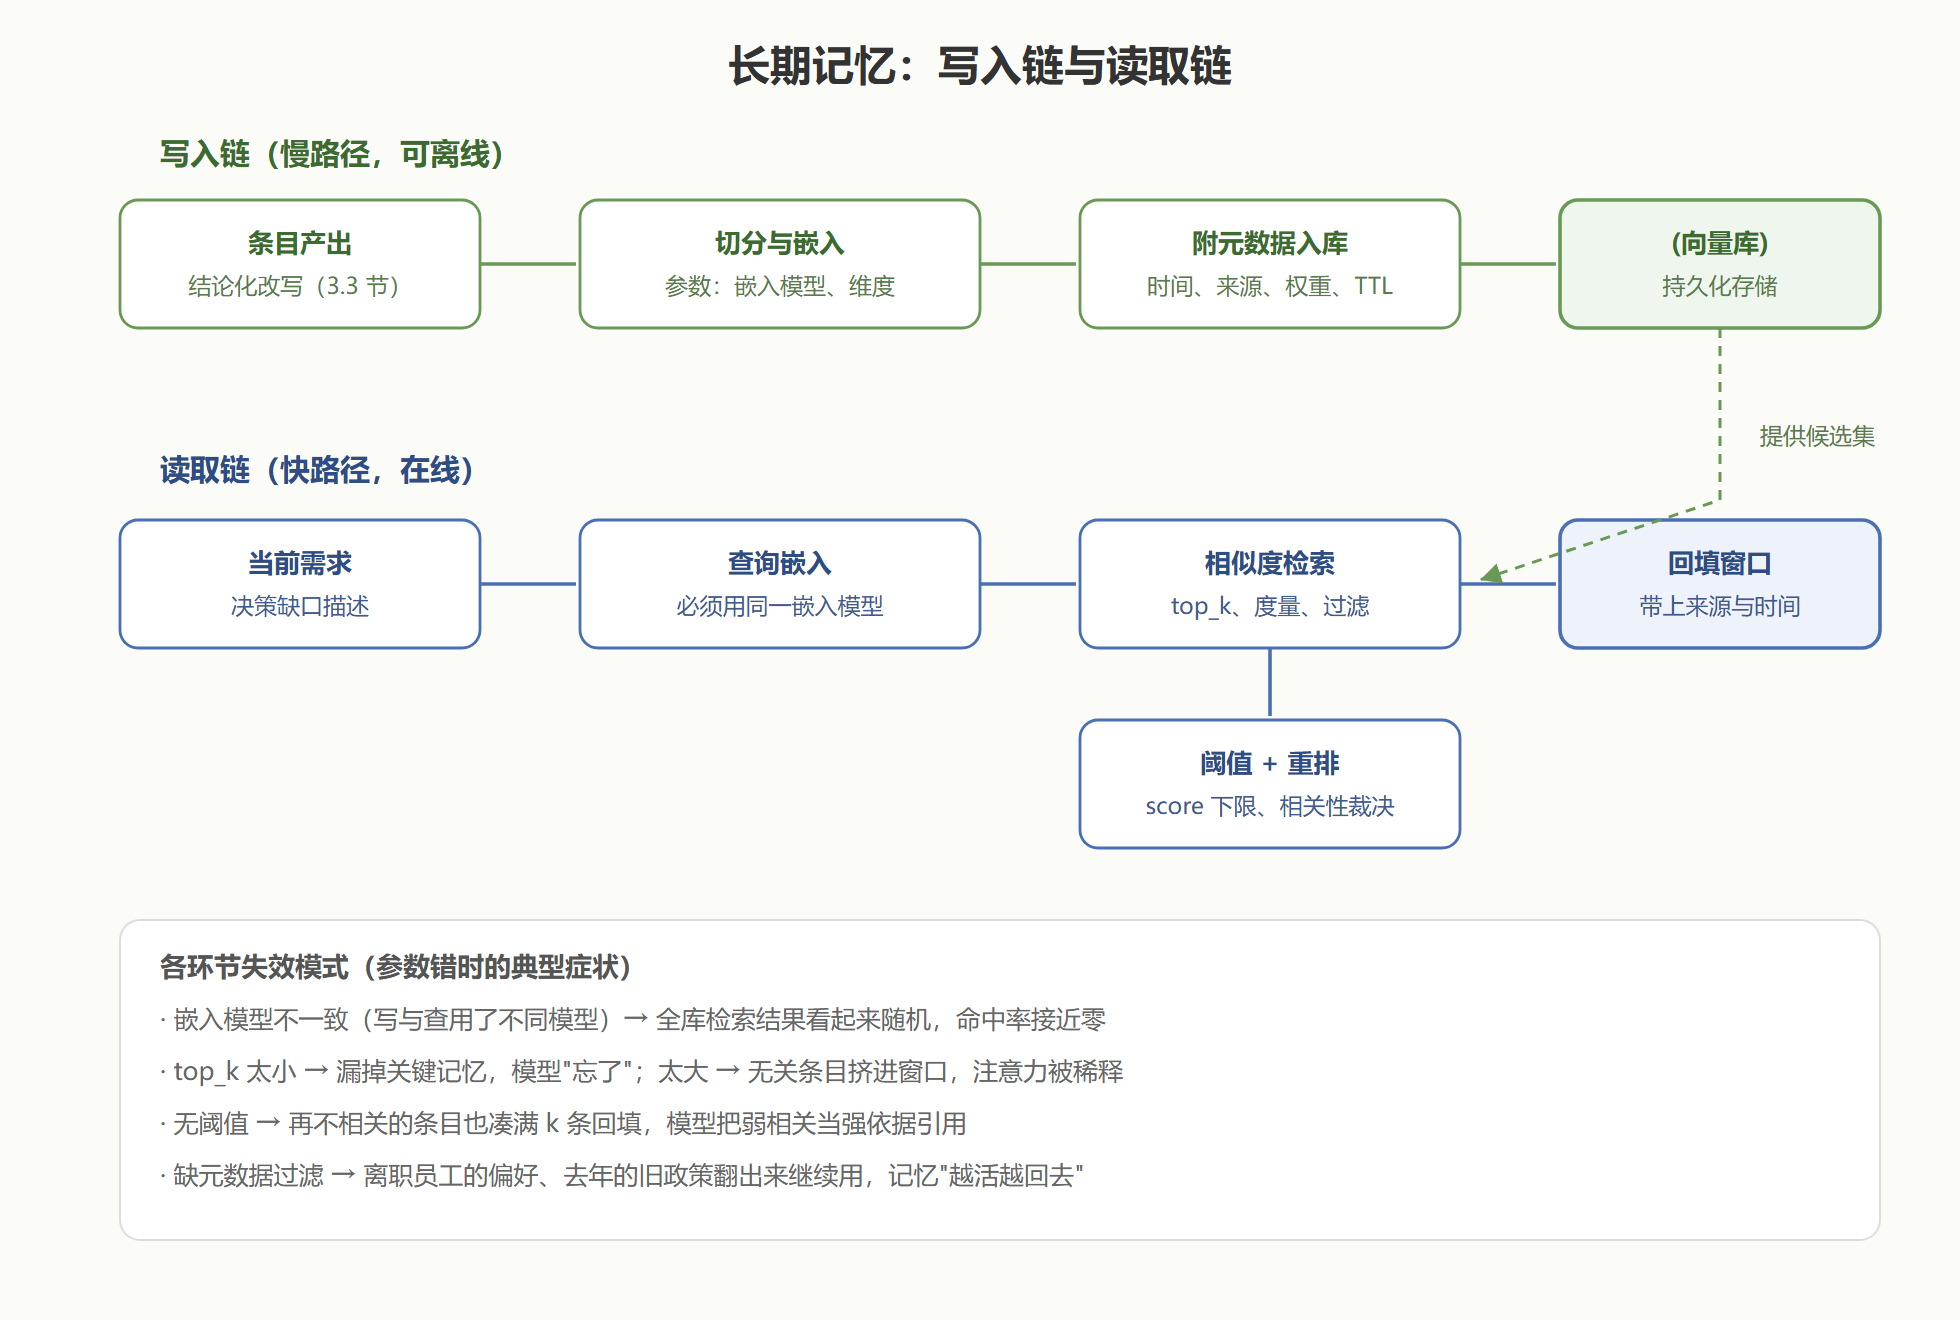
上一节的窗口解决"当下",本节的向量库解决"曾经"。链路本身不复杂:写入时把文本转成向量(嵌入)连同元数据存库;读取时把当前需求也转成向量,找最近的若干条回来。复杂度全在参数里——同样一份记忆库,参数调对和调错,检索命中率能差出一倍。
图:长期记忆检索链路——每个环节的参数与失效模式
检索代码:参数都藏在哪里
def search_memory(query: str, *, top_k: int = 5, min_score: float = 0.75, filters: dict | None = None, diversify: bool = True) -> list: """按语义检索长期记忆。四个参数各有明确的职责边界。""" qvec = embed(query, model=EMBED_MODEL) # 与写入必须同模型 cond = filters or {} # metadata 过滤先行:把"绝不该回来"的条目挡在排序之前 # 例:{"user_id": "u1001", "type": "preference", "expired": False} candidates = vector_db.search(qvec, top_k=top_k * 3, where=cond) # 先宽取 hits = [(h, cosine(qvec, h.vec)) for h in candidates] hits = [h for h in hits if h[1] >= min_score] # 阈值砍掉弱相关 if diversify and len(hits) > top_k: # MMR:相关且不重复 hits = mmr_select(hits, top_k, lambda_div=0.4) return [{"text": h.text, "score": round(s, 3), "meta": h.meta, "age_days": days_since(h.meta["ts"])} for h, s in hits[:top_k]]
参数逐个过堂
嵌入模型与维度。写入与查询必须用同一个模型,这是整条链路里唯一"错一个字全盘皆输"的约束——模型不同,向量空间不同,相似度数值全然没有意义。维度越高表达越细,但存储与计算成本同步上涨;业务上选主流的中等维度模型即可,别为维度焦虑。
top_k 与 min_score(此消彼长的一对)。top_k 决定"最多取几条",min_score 决定"多不相关就不要"。实践口径:窗口预算紧就 k=3 加高阈值,预算松可 k=8 配低阈值;先宽取(3 倍候选)再筛,比直接取 k 条更能扛住排序抖动。判断调没调好的标准不是检索指标,而是下游回答质量——垃圾条目回填越多,模型编得越自信。
元数据过滤。向量相似只管"说得像不像",不管"该不该出现"。用户隔离(甲的记忆绝不给乙用)、条目类型(偏好/事实/结论)、时效(过期的政策)这三类边界必须用元数据硬过滤,交给相似度去"顺便"区分等于没有防线。
MMR 多样化。相似检索的天性是取回一堆近亲(五条几乎一样的"喜欢简洁风格")。MMR 在相关性与彼此差异之间权衡,让 k 个名额覆盖不同侧面。代价是排序计算变多,对 k 很小的场景可以不开。
案例:一次检索调参的全过程
背景:内部 IT 助理上线两周,用户抱怨"问报销标准,它总引用作废的老制度"。
操作:抽查检索记录发现问题不在嵌入而在元数据——制度文档入库时没带生效日期,新旧版本按文本相似度同台竞技,旧版措辞与新问题更接近,屡屡胜出。
结果:给知识类条目补 effective_date 与 superseded_by 两个字段,过滤条件加 superseded: false,同时把知识类条目的 TTL 与制度更新周期对齐。错误引用一周内归零。
解读:这类问题的迷惑性在于它长得像"检索不准",实际是库的治理问题。诊断口诀:结果看起来随机查嵌入模型,结果旧而错查元数据与 TTL,结果雷同查 MMR 与切分。
变式:条目量上了百万级,暴力检索延迟撑不住时才需要引入向量索引(如 HNSW 类结构),用一点召回率换百倍速度。大部分业务在十万条以内,直接量距离即可,别过早优化。
⚠️ 常见坑:把相似度分数直接当"可信度"讲给用户。0.87 的相似度只说明文本像,不说明事实对——对外展示置信度前,先过第 7 章的验真与引用机制。
本节要点回顾
- 链路两半:写入链(改写、嵌入、元数据、入库)与读取链(嵌入、过滤、检索、阈值、回填),参数各管一段。
- 同模型铁律:写入与查询的嵌入模型必须一致,这是全链路唯一的全局性硬约束。
- 过滤先于排序:用户隔离、类型、时效用元数据硬过滤,不要指望相似度顺便解决。
- 宽取严筛:候选取 k 的三倍再按阈值与 MMR 筛选,比一步到位更抗抖动。
存取机制齐了,还差最后一环:什么该写进库、什么时候该删、怎么防止记忆库慢性肥胖——下一节的写入策略与反思机制收这个口。
被漏算的工程账:三笔隐性成本
向量检索的单次查询成本很低,容易让人忽略库的三笔长期开销。
重建成本。更换嵌入模型、调整切分策略这类"上游决定",都意味着全库重嵌——百万级条目的重嵌是真金白银的算力账,还要考虑重嵌期间的读写一致性。防线是元数据里记录每个条目的嵌入模型版本与切分版本,重建可以按版本灰度推进、按版本回滚,而不是一次豪赌。
一致性成本。知识会更新,向量库的条目不会自己跟上。制度文档改版后,旧条目还躺在库里等着被检索命中——3.2 的 TTL 管的是按时间的自然过期,管不了"上游改版"这种事件驱动的失效。成熟做法是给知识类条目挂上源文档标识,源文档更新时触发定向重嵌与旧条目退役,把一致性维护变成入库流程的一部分而不是事后人肉清扫。
治理成本。库越大,"这条记忆当初为什么被写入"越难回答。隐私审计、用户注销后的数据删除、错误的偏好记忆要人工清除——这些运营动作都需要元数据里的来源、时间、类型字段齐备才能执行。元数据字段在第一天就按"将来要被审计"的标准设计,是最便宜的治理投资。
三笔账的共同教训:向量库的选型与建模,看的不是"能不能存",而是"三年后还好不好管"。