6.2 RAG 工程参数:分块、嵌入、top-k 与重排
6.2 RAG 工程参数:分块、嵌入、top-k 与重排
本节摘要:RAG 上线容易调好难——检索质量的每一分都藏在参数里:块切多大、嵌入用哪个、top_k 给几、要不要重排。本节把这条参数链拆成四道关,给出每道关的失效症状与调整方法,并附一份可直接套用的调参实验记录格式。
上一节的最小链路能跑,但"能跑"与"好用"之间隔着参数鸿沟。同样是五百份文档的知识库,参数调对与调错,检索命中率可以差出50%以上。好消息是这条参数链只有四道关,每道关的职责单一、症状明确,逐关排查就能收敛。
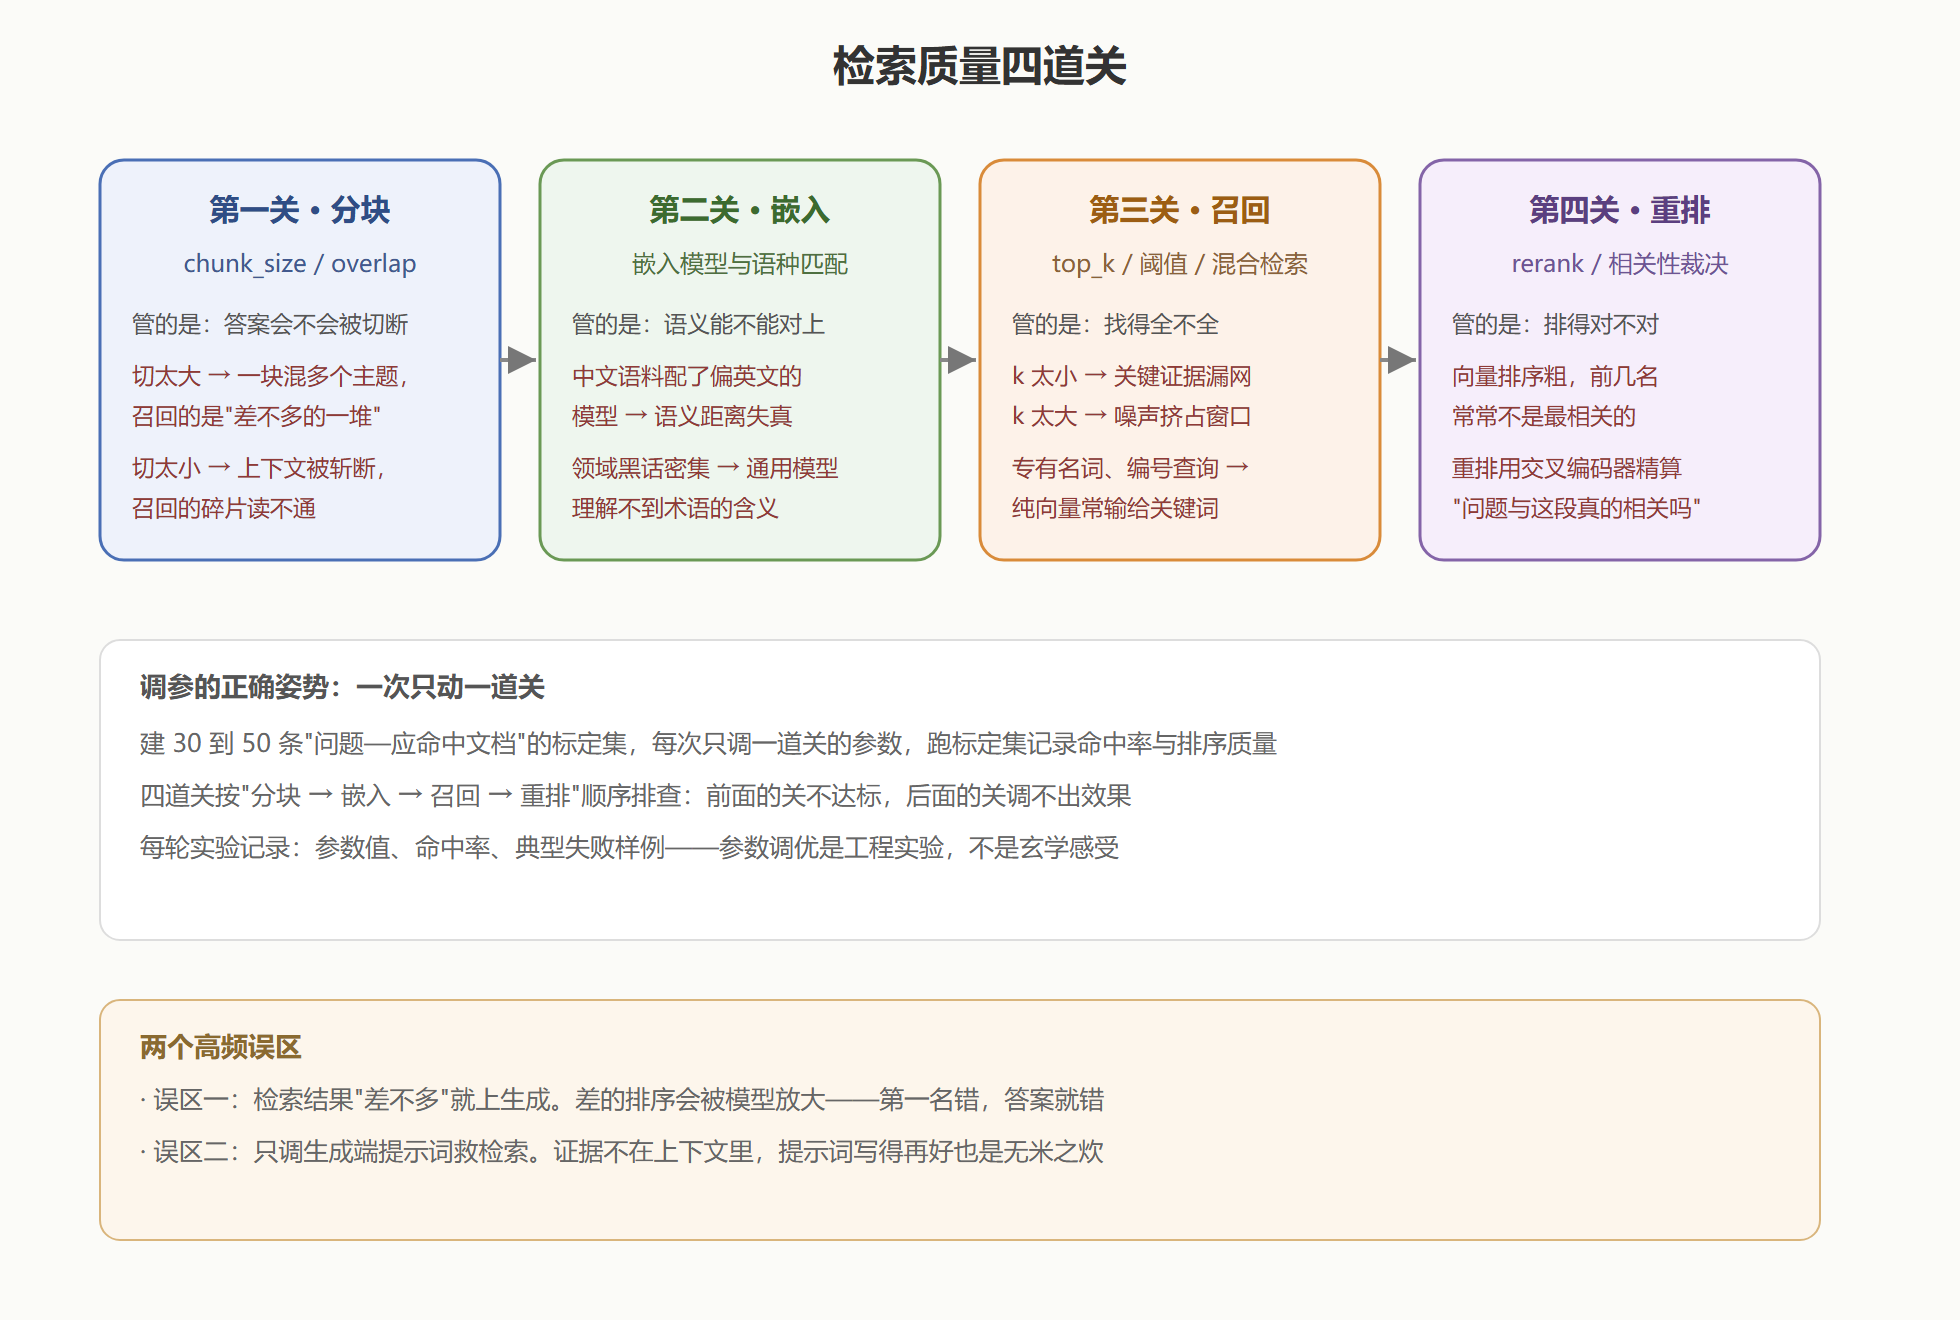
图:检索质量四道关——每道关管一件事,症状各不相同
参数速查:症状与调法
| 参数 | 症状(调错的信号) | 调法 |
|---|---|---|
| chunk_size | 召回块读不通/一块混多主题 | 从 300–500 token 起步,按文档结构切(标题、条款边界优先) |
| overlap | 答案在两块接缝处丢失 | 取块长的 10%–20%,保证边界句重复出现 |
| 嵌入模型 | 同义问题召回不稳定 | 换与语料语种、领域匹配的模型,全库重嵌 |
| top_k | 证据漏网或窗口被噪声灌满 | 4–8 起步,按窗口预算与命中率实验定 |
| score 阈值 | 弱相关材料混进提示 | 从 0.7 起调,观察"该拒答的拒了吗" |
| 混合检索 | 编号、专有名词查不到 | 向量加关键词(BM25 类)双路召回再合并 |
| 重排 | 前几名不是最相关 | 宽召回(k 的 3–4 倍)后接交叉编码器重排取前 k |
一份调参实验的完整记录
背景:制度问答库(两百份文档)上线后,"该拒答的问题答了,该答的问题答漏",团队决定系统调参。
操作:先建标定集——从历史提问里挑了四十条,人工标注每条应命中的文档与条款。第一轮只调分块:从固定五百 token 改为按条款边界切,命中率从六成升到七成五;第二轮只调混合检索:加上关键词召回,编号类问题(问具体条款号)的命中从五成升到九成;第三轮加重排:宽取十二条重排回五条,第一名正确率再升一成。每轮改动只碰一道关,命中率变化可归因。
结果:三轮后标定集命中率稳定在九成以上,"张冠李戴"类回答基本消失,剩余错误集中在文档本身缺失的情形——这类由拒答兜底接住。
解读:三个经验值得抄走。其一,按文档结构切优于按长度切——制度、合同这类文档天然有条款边界,尊重结构胜过任何魔法数字。其二,关键词与向量是互补不是替代——语义检索擅长"换个说法",关键词检索擅长"一字不差",编号与专名查询必须双路。其三,标定集是调参的地基——没有它,每次调整都是凭感觉,调好调坏全靠运气。
变式:文档更新频繁的库,重嵌成本需要纳入设计:变更只影响少数文档时按文档增量重嵌;全库重嵌(如更换嵌入模型)安排在低峰期并保留旧索引回滚。
⚠️ 常见坑:在标定集上调到满分直接上线。标定集来自历史提问,分布会漂移——每月用新鲜的真实提问补充标定集,参数才有持续的生命周期。
本节要点回顾
- 四道关各管一事:分块管完整、嵌入管对齐、召回管找全、重排管排对——顺序排查,前面的关不达标后面的白调。
- 结构切分优先:按标题、条款等文档结构切块,普遍优于按固定长度硬切。
- 双路互补:向量管语义、关键词管字面,编号与专名查询必须混合检索。
- 标定集驱动:三十到五十条"问题—应命中"的标定集,是所有参数决策的度量衡。
检索把"库里的知识"接上了,下一节换个方向:把"世界上的现成工具"接上——工具生态与 MCP 协议。
分块策略的进阶:结构感知与语义切分
固定长度切分是起点,生产上还有两级进阶。结构感知切分:利用文档自身的结构标记——标题层级、条款编号、表格边界、代码块——在结构边界处切块,让每块语义完整。实现上不必解析格式细节,多数文档转成 Markdown 后按标题层级递归切分,就能覆盖八成的结构收益。语义切分:对结构不明显的长文本(访谈记录、流水日志),按句子嵌入的相邻相似度找"语义断层",在断层处切块。它比固定切分多一次全库嵌入的算力,适合内容价值高、结构感弱的语料,不必全库上马。
两级的共同原则:块的完整性优先于块的均匀性——一块读不通的均匀小块,不如两块读得通的略大块。
元数据:被低估的第二检索通道
6.1 的案例已经露出端倪:很多检索问题不是语义问题,是属性问题。"今年的预算制度"里,"今年"是时间属性;"华东区的价格政策"里,"华东区"是组织属性。这类约束靠语义匹配是碰运气的,靠元数据过滤是确定的。建库时给每块材料挂齐四类元数据:身份类(来源文档、章节、条款号——引用回溯的锚点)、时间类(生效日期、版本号——新旧裁决的依据)、范围类(部门、地区、产品线——权限与相关性的边界)、状态类(有效/作废/草稿——拒答与过滤的开关)。检索时元数据做硬过滤,向量做软排序,两条通道各干各的。这一节调参实验里补生效日期字段带来的提升,就来自这条被多数团队后置的通道——它不花算力,只花建模的心思。
拒答:检索不到也是检索结果
参数调优的终点不是"命中率百分之百",而是"该答的答对、不该答的认账"。拒答的触发要分层设计:最高分低于硬阈值——库里大概率没有,直接承认不知道;最高分尚可但断档(第一名远高于后续)——只有一条孤立证据,回答时声明依据有限;各条分数平庸且接近——主题可能只在库边缘,回答需附带"以下内容仅供参考"的降级话术。拒答率是健康指标而不是失败指标:一个从不拒答的问答系统,要么库无所不包(罕见),要么在替用户编造(常见)。把拒答率纳入 7.1 节的评测维度,与命中率一起看,才能判断检索系统真实的水位。
调参实验的记录模板
调参最怕调完就忘——三个月后没人记得当时的参数组合为什么有效。一份最简的实验记录只需要五列:改动项(一次只填一个:如"chunk 500 固定长 → 按条款边界")、假设(预期解决什么症状:如"召回碎片读不通")、标定集结果(命中率与第一名正确率的前后值)、副作用观察(平均块长变化对窗口占用的影响)、结论(采纳/回退/待观察)。这份记录的真正价值在半年后:当有人提议"把分块改回固定长度"时,你能翻出当时的假设与数据,而不是凭印象再吵一轮。参数治理和代码治理一样,没有历史记录的调参,注定被反复重调。