4.1 Deutsch-Jozsa:量子加速的第一课
4.1 Deutsch-Jozsa:量子加速的第一课
本节摘要:Deutsch-Jozsa 是教学意义上的"算法一号":问题几乎不值一提(判断一个函数是常数还是平衡的),但它是第一个被严格证明存在量子-经典查询复杂度差距的算法。本节把问题、oracle、相位回踢、末端干涉四步全部演算到位,你会亲眼看到错误答案的振幅如何精确归零——这是 3.4 节三段式骨架的第一次实弹射击。
问题:只需要回答"是/否"
设 f 是从 n 比特到一比特的函数,承诺它只有两种可能:常数(所有输入同值)或平衡(恰好一半输入得 0、一半得 1)。目标:判断它是哪一种。
经典算法必须调用 f 若干次。运气好两次就撞见不同输出(判定平衡);运气坏,读了 2^{n−1}+1 个输入全是同值,才能放心宣布常数——因为再读一个就有对半概率翻车。查询次数最坏情形是输入空间的一半多一点。
量子算法调用 f 一次,答案必得。2^n 种可能一次看完,这就是教科书里的"指数加速"。先泼冷水再上课:这个加速依赖"承诺"(函数只许是常数或平衡),现实中几乎没有问题天然长这样,所以 DJ 没有直接应用。它的价值是教学法:机器最小、账目最全,干涉加速的每个零件都裸露在显微镜下。
oracle:把函数装进线路
量子计算里函数不能直接调用,要包装成幺正线路 U_f,约定:
U_f |x⟩|y⟩ = |x⟩|y ⊕ f(x)⟩ x:输入寄存器,y:一位辅助位
x 原样保留,y 翻转与否取决于 f(x)。幺正性由"⊕ 是可逆运算"保证。关键一步在 3.4 节已经埋好:把辅助位固定在 |−⟩ 上,U_f 的作用变成纯粹的相位回踢:
U_f |x⟩|−⟩ = (−1)^{f(x)} |x⟩|−⟩ 逐项验证 f(x)=1: |x⟩|−⟩ = |x⟩(|0⟩−|1⟩)/√2 U_f 之后 = |x⟩(|1⟩−|0⟩)/√2 = −|x⟩|−⟩ ✓
辅助位毫无变化,信息全部转移到 x 的振幅符号上。f 从此"隐身"于相位——单次测量永远看不见它,这正是为下一步干涉准备的伏笔。
线路与全流程演算
x 寄存器(n 位): ──H──■──H──测量 │ y 辅助位(1 位): ──X──H────(全程 |−⟩,不测量) 首位 X 把 |0⟩ 变 |1⟩,再 H 得 |−⟩
逐步推演全态(n 位 x 寄存器初态 |0⟩^n,y 初态经 X、H 变 |−⟩):
第一步:x 寄存器全部铺 H |0...0⟩ → (1/√N) Σ_x |x⟩ ,N = 2^n 全态:(1/√N) Σ_x |x⟩ ⊗ |−⟩ 第二步:一次 U_f 调用(相位回踢) → (1/√N) Σ_x (−1)^{f(x)} |x⟩ ⊗ |−⟩ 第三步:x 寄存器再铺一层 H,看 |0...0⟩ 方向的振幅 H^{⊗n}|x⟩ 在 |0...0⟩ 方向的分量 = (1/√N)(−1)^{x·全零} = (1/√N) 故 |0...0⟩ 的总振幅 = (1/N) Σ_x (−1)^{f(x)}
第四步,分两种情况清点这个振幅:
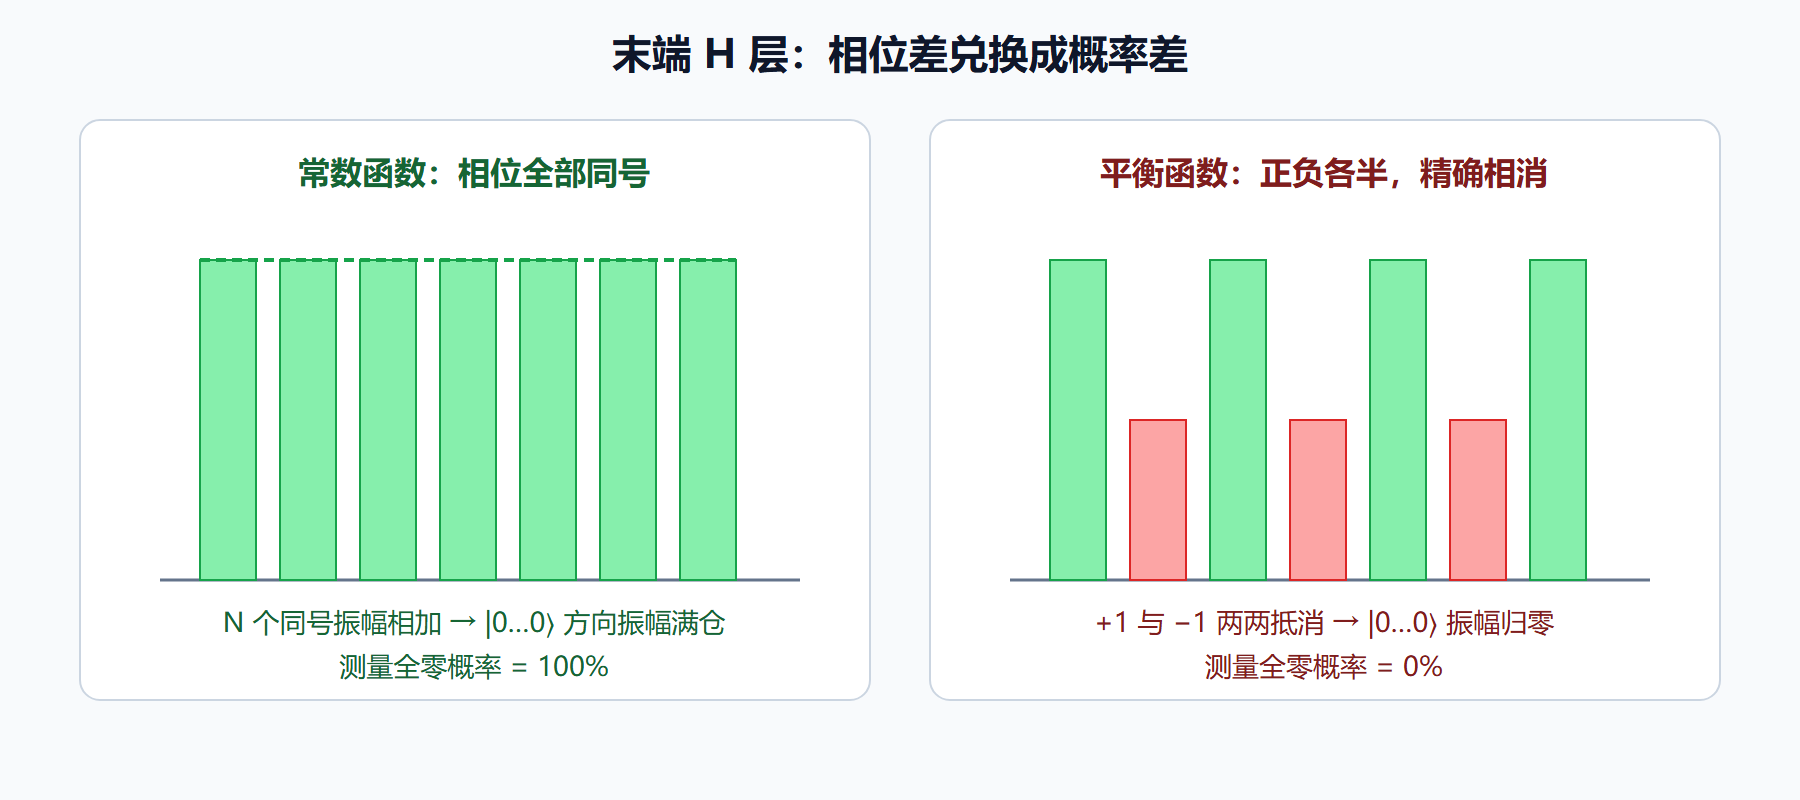
f 常数: Σ_x (−1)^{f(x)} = ±N → |0...0⟩ 振幅 = ±1 测得全零的概率 = 1(百分之百) f 平衡: 一半 +1 一半 −1,恰好抵消 → 振幅 = 0 测得全零的概率 = 0(颗粒无收)
结论干净利落:测一次,全零即常数、非全零即平衡,无任何歧义。经典需要 2^{n−1}+1 次查询的问题,量子一次了账。注意加速的实现方式:不是"同时算所有 f(x)"这种模糊魔法,而是精确的会计——常数函数的 N 个相位同号,加法膨胀成 1;平衡函数的 N 个相位对半相杀,归零。所有可能性都被处理了,但只有被干涉选中的结局能被看到。
图:两种函数的振幅归零与满仓
用代码复核一遍
纸上推完,机器对账(n=3,常数函数 f≡0 对比平衡函数 f(x)=x 的奇偶位):
import numpy as np n = 3 N = 2 ** n H1 = np.array([[1, 1], [1, -1]]) / np.sqrt(2) def measure_allzero(f): # x 寄存器铺第一层 H state = np.zeros(N) for x in range(N): # H^{⊗n} 作用在 |0…0⟩ 上:每个基态振幅 = 1/√N(H 的第一列全为 +1/√2) state[x] = 1 / np.sqrt(N) # 相位回踢 state = np.array([state[x] * (-1) ** f(x) for x in range(N)]) # 末端 H 层:计算 |0…0⟩ 方向的新振幅(H 第一行同样全 +1/√2) amp0 = np.sum(state) / N return amp0 ** 2 # 全零概率 f_const = lambda x: 0 f_bal = lambda x: (x.bit_count() % 2) # 位奇偶:一半 0 一半 1 print(measure_allzero(f_const)) # 1.0 print(measure_allzero(f_bal)) # 0.0(可能出 1e-30 量级的浮点残渣)
两行输出 1.0 与 0.0,与手算一致。顺带体会那组代码的分量:循环里 N 个振幅逐个进内存——经典模拟的代价随 n 指数膨胀,而 DJ 量子线路本身只有 2n+1 个门。模拟费内存、设备省线路,两头不对称正是这个领域的 economics。
这堂课真正教会的事
DJ 的收益不在问题本身,而在三个可迁移的零件。其一,相位回踢:把布尔信息写进 (−1)^{f(x)},这是 Grover oracle 用的同一手法。其二,H 层对偶:H 同时是最便宜的分束器和合束器,"铺开-回收"一次 H 层完成。其三,承诺问题的加速形态:量子加速常以"保证答案结构"为前提——先想清楚问题的承诺是什么,再谈加速。
至于"DJ 证明了量子计算全面超越经典"?没有。它证明的是存在人造的查询问题让量子少跑腿。真实世界的加速要看 Grover 与 Shor——一个把干涉循环化,一个把数学转化做到极致。
本节要点回顾
- 承诺问题:常数/平衡二选一的承诺,是 DJ 加速的前提。
- 相位回踢:辅助位固定 |−⟩,一次 oracle 把 f 写进 (−1)^{f(x)}。
- 两种结局:常数相位同号相长(全零概率 1),平衡相位对半相消(全零概率 0)。
- 零件可迁移:回踢与 H 层对偶直接进入下一节的 Grover。
DJ 只挥了一次干涉就收工。若问题没有"承诺"撑腰、答案也不止两种呢?下一节的 Grover 把干涉变成可以反复迭代的泵,一寸一寸把正确答案的振幅从均匀背景里顶出来。