1.4 同一副耳蜗两种打法:感知策略的分岔
1.4 同一副耳蜗两种打法:感知策略的分岔
本节摘要:AAC 与 Opus 共用同一套听觉生理学,但 AAC 把心理声学做成显式的 FFT 掩蔽分析模块,Opus 却大幅绕开这套机器,改用感知加权残差与频带能量约束。本节拆解分岔的技术原因(延迟、算力、码率区间),并给出两条路线各自的适用边界。
第 1 章的收束点:前两节建立了掩蔽阈值这条裁决线,本节让它照出两位主角的分岔。理解这次分岔,后面 AAC 的尺度因子循环(第 2 章)与 Opus 的加权残差(第 3 章)就不是两套孤立的技术,而是同一命题的两种解法。
分岔现场:一个模块的有与无
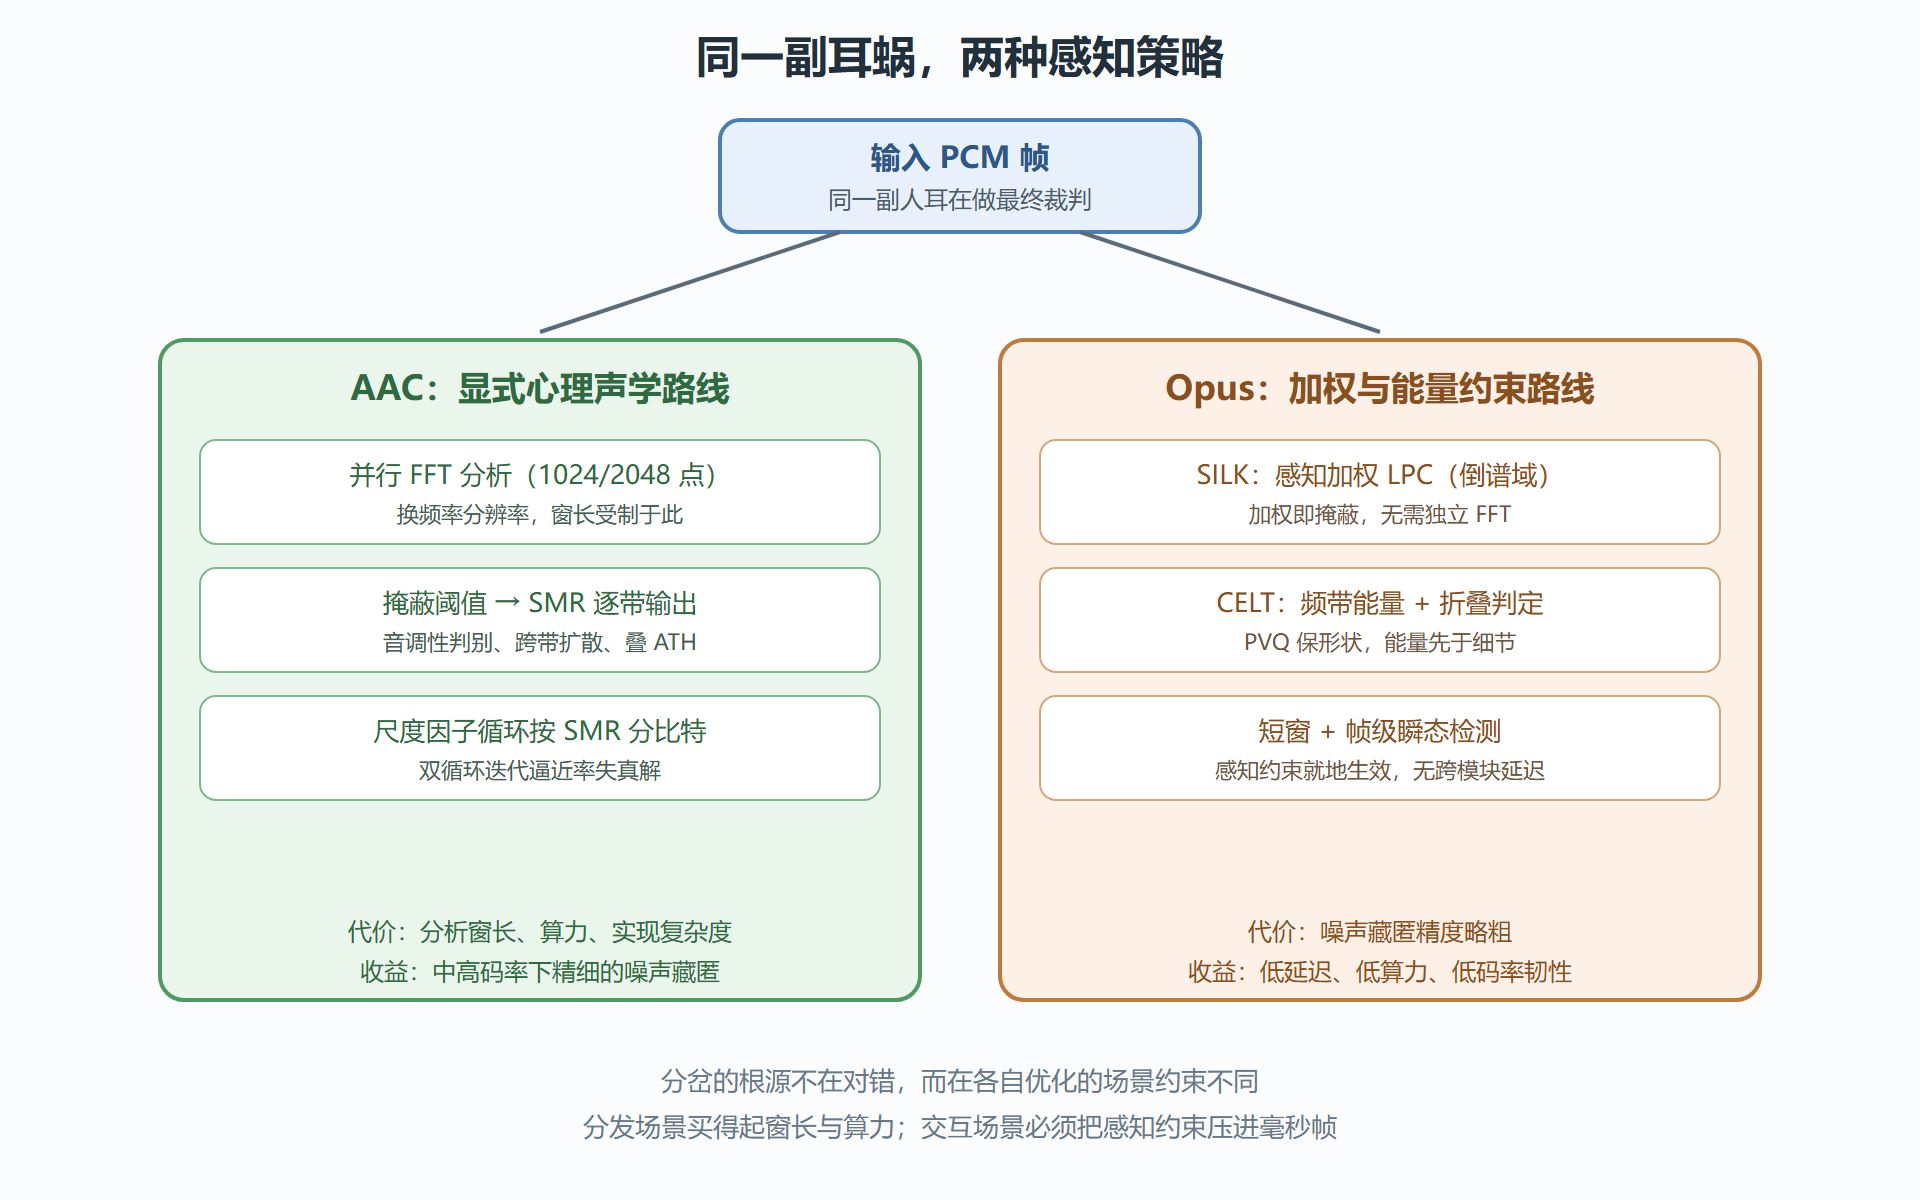
把两个编码器的信号流并排画出来,最显眼的差异是:AAC 的流水线里立着一个独立的"心理声学模型"模块——对输入做 FFT、算掩蔽阈值、输出 SMR,主链路的量化器听它指挥;Opus 的流水线里找不到对等物——感知约束被揉进了 LPC 加权滤波器(SILK 侧)与频带能量/折叠判定(CELT 侧),没有一个显式的阈值计算环节。
图:感知策略的分岔
为什么 Opus 敢绕开这套机器
三个约束共同促成了这次分岔。
延迟约束。 经典掩蔽计算要可靠的频率分辨率,而频率分辨率来自长窗——FFT 窗越短,谱线越糊,阈值越不可信。AAC 的心理声学分析绑在 1024 样本量级的帧上,毫秒级的通话帧根本装不下这套机器。Opus 从设计目标(RFC 6716 面向交互音频)出发,只能把感知约束改成"帧内即时可算"的形式:LPC 加权滤波器的系数从当前帧的线性预测分析直接导出,加权传递函数在共振峰处挖谷,让量化噪声自动避开人耳最敏感的谱峰区——掩蔽思想没变,实现从"算一条阈值曲线"变成"设计一个加权滤波器"。
算力约束。 完整模型的音调性判别、跨带扩散、能量域叠加每帧都是实打实的浮点开销,还要维护长 FFT 缓冲。Opus 要跑进手机与嵌入式设备的同时处理几十路通话(会议服务器场景),每个编码器的感知模块必须便宜。加权滤波与频带能量统计的计算量比完整 FFT 掩蔽分析低一个量级,且极易定点化、向量化。
码率区间约束。 完整心理声学模型的优势区在"预算够用、追求精致藏噪"的中高码率;当码率被压到 6 至 24 kbps 时,问题变成"先把语音骨架传过去"——精确的掩蔽阈值此时意义有限,LPC 残差里哪些脉冲必须保真才是主要矛盾。Opus 的主力战场恰在这个区间,工具选择跟着主战场走。
两条路线的适用边界
| 维度 | AAC 显式模型 | Opus 加权与能量约束 |
|---|---|---|
| 感知判据形态 | 频域掩蔽阈值曲线(逐带 SMR) | 加权滤波器 + 频带能量与折叠判定 |
| 依赖的变换 | 与 MDCT 并行的长窗 FFT | LPC 分析、短窗 MDCT,无独立感知变换 |
| 分析窗量级 | 1024/2048 样本 | 2.5 至 20 ms 帧,无长时前瞻 |
| 算力重心 | 双循环比特分配迭代 | 码本搜索与 PVQ 量化 |
| 优势码率区 | 约 64 kbps 以上 | 约 64 kbps 以下仍稳 |
| 典型失效 | 瞬态前的预回声(靠 TNS 补救) | 极高码率下噪声藏匿不如 AAC 精细 |
| 代表场景 | 音乐发行、广播、影视 | 通话、会议、互动直播 |
这张表也为第 4 章的正式对比埋下伏笔:延迟、算力、码率区间三项,正是两代编码器分野的全部坐标轴。
验证分岔的存在:两个可观察的证据
其一,看参考实现的代码结构。FFmpeg 的 AAC 编码器里有独立的心理声学模型单元(psy 模块),输入输出就是逐带阈值;而 libopus 的源码里搜索不到对等的"先算阈值再分配"的模块,感知逻辑分散在加权函数与频带量化参数里。其二,看工具行为:LAME(MP3 时代同款思路)提供心理声学模型的调参开关,能直观改变噪声分布;opusenc 的参数体系里则根本没有掩蔽阈值相关的旋钮,只有码率、复杂度、帧长等控制预算与搜索的选项——感知决策被封装在模式选择器内部。
分岔的历史注脚与两条自检线
这次分岔不是某次会议上的拍板,而是两条工程传统各自演进的自然结果。AAC 的心理声学模块直接继承自 MP3 时代的模型二谱系——ISO 标准把掩蔽计算写成了参考 annex,实现者照着算就是合规;SILK 的加权路线则承自电信语音编码(CELP 家族几十年的感知加权传统),那个世界从来没有为音乐考虑过长窗 FFT,加权滤波器就是它们全部的"听觉模型"。所以与其说 Opus "放弃"了心理声学模型,不如说它把电信世界的小巧方案带进了通用音频的主场,并证明了一件此前没人确定的事:在足够低的延迟约束下,这套简化方案不但够用,还有余量。
两条自检线可以防止读者把这个对比绝对化。其一,分岔不等于鸿沟:AAC 在低码率区间也会退化感知精度(比特不够时阈值算得再准也没用),Opus 在高码率区间也有精细的噪声整形(CELT 的频带折叠判定本质是掩蔽思想的变体)——两端是渐变的过渡带,不是悬崖。其二,实现差异小于标准差异:具体编码器版本的质量差距(比如不同 AAC 实现之间)经常大于两个标准之间的理论差距,这也是 4.2 节坚持"测了再说"的原因。
三个快速问答收束本节。问:既然 Opus 的做法算力更省,AAC 为什么不改?答:改不了——显式模型的优势在中高码率的精细藏噪,那是 AAC 的主场;为低码率重写感知模块等于变成另一个编码器,且要放弃二十年的调校积累。问:心理声学模型的输出能离线查看吗?答:能,多数开源编码器有调试开关可打出逐带阈值(LAME 系的 debug 输出是经典),对照频谱图看阈值曲线是理解 1.3 节最快的路径。问:未来两边会合流吗?答:正在发生——神经增强的心理声学(6.1 节)本质是用数据学出更准的"阈值",两种实现传统可能在"学习的掩蔽模型"上重新会师。
两种实现的细节对照表
把分岔落成一张实现级的对照表,供后续章节随时回查:
| 对照项 | AAC 显式模型 | Opus 加权路线 |
|---|---|---|
| 感知计算载体 | 独立 FFT 加掩蔽分析模块 | LPC 加权滤波器与频带能量统计 |
| 频率坐标 | Bark 尺度临界频带 | 近似方差的频带划分(CELT) |
| 音调性处理 | 显式判别(纯音/噪声样分别对待) | 隐式(加权系数随谱形自适应) |
| 时域掩蔽 | 帧间阈值平滑与前瞻 | 短帧本身 + 瞬态检测切换 |
| 输出形态 | 逐带 SMR 交给比特分配 | 加权残差直接进量化 |
| 可调性 | 模型版本与参数少量可调 | 无独立感知旋钮,随码率/复杂度联动 |
表里最值得记住的是最后一行:AAC 的感知行为有独立旋钮(部分实现允许调心理声学参数),Opus 的感知行为与预算旋钮深度绑定——这解释了为什么调 Opus 时"感知问题"总是通过码率与复杂度间接影响,而 AAC 可以直接动感知层。两种设计没有对错,但调参心智模型完全不同。
💡 关键直觉:AAC 是"先算出人耳的账本,再按账本花比特";Opus 是"把人耳的偏好编进花钱的手势里"。前者账本精确但翻页慢,后者手势粗糙但出手快——两代编码器的全部性格差异,都能从这一处分岔推导出大半。
第 1 章到此收束。带着这条分岔线进入第 2 章:先看 AAC 如何把显式模型路线打磨成一套完整的频域机器,从标准谱系一路拆到码流封装。