第 1 章 · 02 Semantica 编排器与八段管线
第 1 章 · 02 Semantica 编排器与八段管线
本节摘要:本节拆开整台机器的总门面:
core/orchestrator.py里的Semantica主编排类——一个聚合所有子模块的门面(facade),用惰性 property 按需初始化各个引擎;看清 ARCHITECTURE.md 里八段管线的完整 Mermaid 图(ingest→parse+normalize→split+extract→conflict+dedup→kg→polyglot 存储→reasoning→context 决策),以及build_knowledge_base如何把源码级流水线跑起来;学会用PipelineBuilderDSL 声明式地搭管线;最后盘点 5 个程序入口(CLI/server/worker/explorer/mcp)与「无 key 跑通」的可运行性设计。
内容来源:原项目源码 semantica/core/orchestrator.py、semantica/pipeline/pipeline_builder.py、ARCHITECTURE.md、pyproject.toml、semantica/cli.py
⚠️ 注意:
Semantica编排器的各模块属性是惰性的——第一次访问framework.graph_builder才会真正 import 并构造GraphBuilder。这意味着构造编排器本身几乎零开销,但也意味着依赖缺失只会在第一次使用时爆出来,而不是构造时。
学习目标
- 理解
Semantica编排器的门面模式:一个类聚合全部子模块入口。 - 掌握惰性 property 初始化的实现套路与好处。
- 读懂八段管线 Mermaid 图,说清每段的输入输出与三个高点。
- 读通
build_knowledge_base主流程:校验源→建管线→逐源执行→建图→嵌入。 - 会用
PipelineBuilder的 add_step/connect_steps/build 三板斧声明式搭管线。 - 认识 5 个入口与
semantica doctor自检,能在无 key 环境跑通第一个示例。
一、Semantica 编排器:聚合所有子模块的门面
orchestrator.py 只有 1026 行,却是 27 个子模块的总开关。Semantica 类的构造函数(orchestrator.py:58)先立起三根管理柱子:
def __init__(self, config=None, **kwargs): self.logger = get_logger("semantica") self.config_manager = ConfigManager() # 按三种形态装配置:Config 对象/dict/kwargs if isinstance(config, Config): self.config = config elif isinstance(config, dict): self.config = self.config_manager.load_from_dict(config) else: self.config = self.config_manager.load_from_dict(kwargs or {}) # 初始化核心组件 self.lifecycle_manager = LifecycleManager() self.plugin_registry = PluginRegistry() ... self._modules: Dict[str, Any] = {} # 模块缓存池 self._initialized: bool = False # 惰性初始化开关
三个细节:其一,配置支持 Config 对象、dict、kwargs 三种形态,最终统一走 ConfigManager;其二,provenance 的存储路径在这里做全局配置(orchestrator.py:98 一处 config.get("provenance.storage_path") 就能同时命中顶层与嵌套两种写法);其三,self._modules 是模块缓存池——所有子模块都从这里按需取。
真正的门面魔法在惰性 property。以 graph_builder 为例(orchestrator.py:154):
@property def graph_builder(self) -> Any: if "graph_builder" not in self._modules: try: from ..kg import GraphBuilder self._modules["graph_builder"] = GraphBuilder( config=self.config.get("kg", {}) ) except (ImportError, OSError) as e: raise ProcessingError(f"KG module not available: {e}") return self._modules["graph_builder"]
第一次访问才 import、才构造、才报错,之后直接命中缓存。同款 property 还有 embedding_generator、reasoner、document_parser、file_ingestor、pipeline_builder 六个,各自从 config 里抠出本模块的配置段(如 config.get("kg", {}))。这种「门面+惰性缓存」的组合,让编排器可以安全地被当作全局单例持有,而不用担心启动重量与可选依赖。
二、八段管线:从数据源到决策的全景图
ARCHITECTURE.md 用一张大 Mermaid 图给出了官方数据流。压缩掉节点细节后,主干正是本书的八段主线:
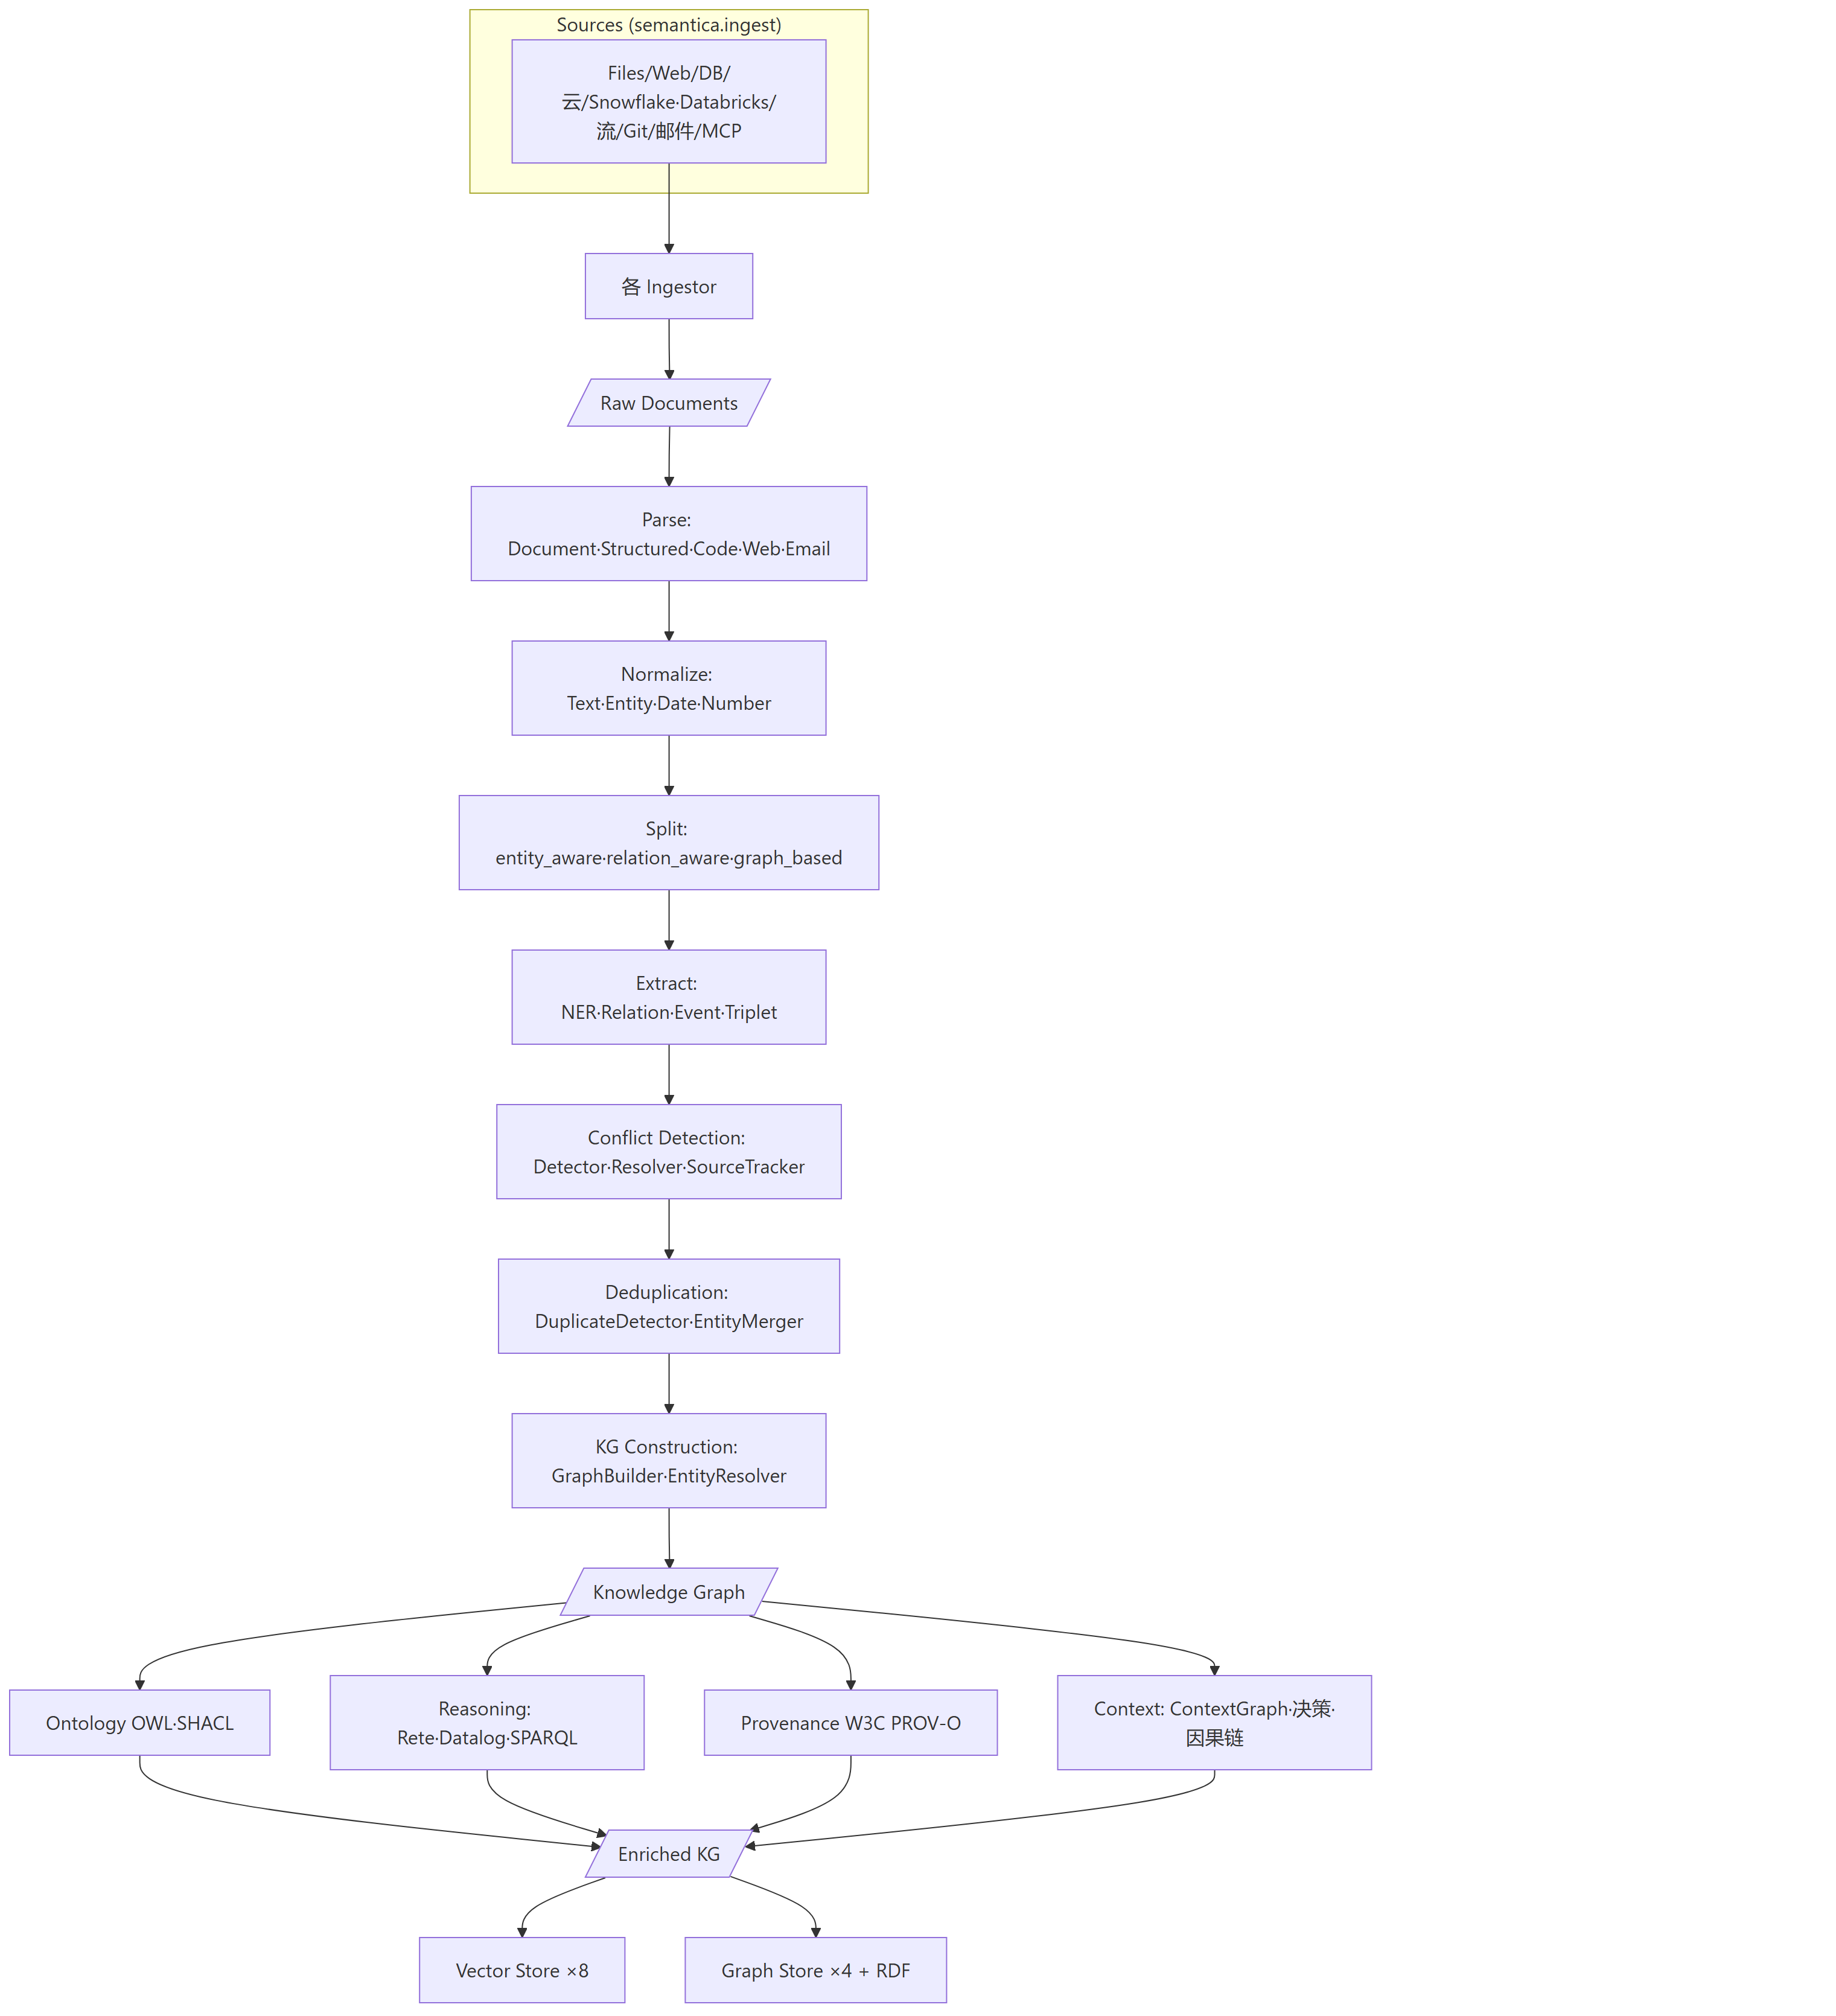
对照本书章节:第①段 ingest(第 2 章)、第②段 parse+normalize(第 2 章)、第③段 split+extract(第 2、3 章)、第④段 conflict+dedup(第 4 章)、第⑤段 kg(第 3 章★)、第⑥段 polyglot 存储(第 8 章)、第⑦段 reasoning(第 5 章★)、第⑧段 context 决策(第 6 章★)。
编排器里的 build_knowledge_base(orchestrator.py:281)是这条管线的程序化入口,主流程五步:
validated_sources = self._validate_sources(sources) # 1.校验:文件存在或 http(s) URL pipeline = self._create_pipeline(pipeline_config) # 2.按配置建管线 for idx, source in enumerate(validated_sources, 1): result = self.run_pipeline(pipeline, source) # 3.逐源执行,进度条跟踪 ... if kwargs.get("graph", True): knowledge_graph = self._build_knowledge_graph(results) # 4.汇总实体关系建图 if kwargs.get("embeddings", True): embeddings = self._generate_embeddings(results) # 5.批量生成嵌入
容错策略值得注意:单个源失败默认只记日志继续跑(orchestrator.py:381 的 fail_fast 参数默认 False),最后用 success_rate 汇报成功率——批量摄取场景里「一张坏文件拖死全批」是不可接受的。
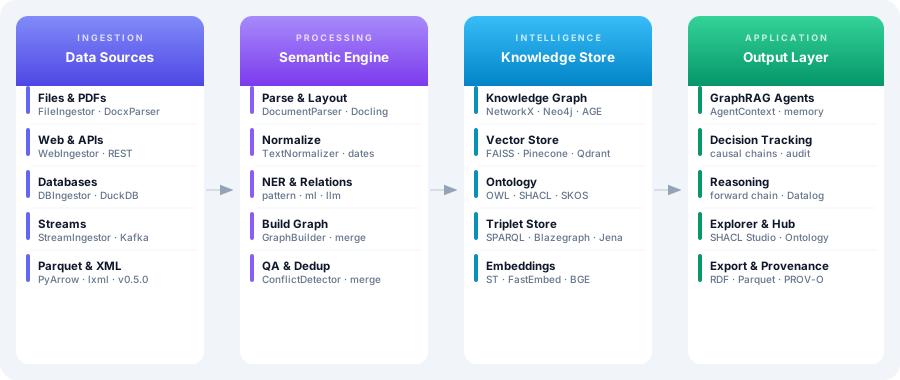
三、PipelineBuilder DSL:声明式搭管线
不想用默认管线?pipeline/pipeline_builder.py 提供了一套声明式 DSL。第一步是数据结构(pipeline_builder.py:55):
@dataclass class PipelineStep: name: str step_type: str config: Dict[str, Any] = field(default_factory=dict) dependencies: List[str] = field(default_factory=list) handler: Optional[Callable] = None status: StepStatus = StepStatus.PENDING ... @dataclass class Pipeline: name: str steps: List[PipelineStep] = field(default_factory=list) config: Dict[str, Any] = field(default_factory=dict)
第二步是三个链式方法(pipeline_builder.py:119、151、188):add_step(名字, 类型, **config) 声明一个步骤;connect_steps(上游, 下游) 把上游名字塞进下游的 dependencies 列表,从而支持 DAG 拓扑而不只是直线;build(名字) 在构建前先过 PipelineValidator 校验(环检测、依赖存在性),校验失败直接抛 ValidationError。执行交给 ExecutionEngine.execute_pipeline(execution_engine.py:113),它按依赖关系调度步骤、记录每步的 status/result/error,还有 parallelism_manager 支持并行度设置。
四、五个入口与可运行性:无 key 跑通
pyproject.toml 第 259 行声明了五个 console 入口,对应五种使用姿势:
[project.scripts] semantica = "semantica.cli:main" # CLI,50+ 命令 semantica-server = "semantica.server:main" # FastAPI REST 服务 semantica-worker = "semantica.worker:main" # 后台任务 worker semantica-explorer = "semantica.explorer:main" # 可视化图工作台 semantica-mcp = "semantica.mcp_server:main" # MCP 服务器,给 Agent 调用
同一套 27 个子模块,五种暴露方式——命令行用户、服务端集成、任务队列、人工可视化、AI Agent 各取所需。上手自检只要一条命令:
semantica doctor # Python 3.11.9 pass # semantica 0.6.5 pass # faiss vector store pass # Config file pass ~/.semantica/config.yaml
而最小可运行示例不需要任何 API key:ContextGraph 默认内存图、VectorStore(backend="faiss") 本地建索引、抽取默认走 ML(spaCy)与 pattern 路线。也就是说,第 2 章起你可以在纯本地环境把管线前五段完整跑一遍,直到第 8 章换后端时才第一次需要外部服务。
💡 装配要点:本节装上「总装台」。三件事带走:①
Semantica编排器=门面+惰性 property 缓存池,模块级配置从config.get("kg")这类命名段读取;② 八段管线是全书目录,build_knowledge_base是它的程序化入口,默认容错不 fail-fast;③PipelineBuilder的核心是PipelineStep.dependencies列表——一个仅 10 个字段的 dataclass 支撑起 DAG、校验、并行调度整套 DSL。
本节要点回顾
Semantica(orchestrator.py:38)是 27 个子模块的门面:_modules缓存池+惰性 property(graph_builder/reasoner/embedding_generator 等 6 个)。- 惰性初始化的代价:依赖缺失延迟到首次使用才暴露,换来零成本构造与可选依赖友好。
- 八段管线:ingest→parse+normalize→split+extract→conflict+dedup→kg→polyglot→reasoning→context,对应本书第 2 到 8 章。
build_knowledge_base五步:校验源→建管线→逐源执行(默认容错)→建图→嵌入。PipelineBuilder:PipelineStepdataclass+add_step/connect_steps/build 三方法,dependencies 支撑 DAG,build 前强制 validator。- 5 个入口(cli/server/worker/explorer/mcp)共享同一套模块;
semantica doctor自检;无 key 可跑通核心功能。
下一节:进入第 2 章管线前段——
01 ingest:25+ 数据源接入,看统一摄入接口如何屏蔽文件、数据库、Snowflake/Databricks、Kafka、邮件、Git、MCP 的差异。