第 1 章 · 02 双循环预览:内循环会话与外循环自我改进
第 1 章 · 02 双循环预览:内循环会话与外循环自我改进
本节摘要:本节建立全书的心智模型——双循环。**内循环(Inner Loop)**是所有 agent 都有的会话循环:消息输入→prompt 组装→调 LLM→工具调用→结果回填→再调 LLM→最终回复,落在
run_agent.py的AIAgent与agent/conversation_loop.py。**外循环(Outer Loop)★**是 Hermes 的灵魂:从经验创建技能(skill)→curator 策展生命周期→使用中改进→learning_graph 沉淀→跨会话记忆,再把产物(技能/记忆/历史)注入内循环的 prompt。两条循环通过"注入点"耦合:外循环的一切改进,最终都要在内循环的一次 API 调用里生效。与 smolagents/OpenHands 对比,它们只有内循环。
内容来源:原项目源码
run_agent.py(AIAgent)、agent/conversation_loop.py:2017(主循环)、agent/system_prompt.py:341(三层 prompt)、agent/iteration_budget.py、agent/curator.py、agent/learning_graph.py;docswebsite/docs/developer-guide/agent-loop.md。
⚠️ 注意:"内循环/外循环"是本教程为组织讲解而采用的命名,官方文档没有这对术语——官方把前者叫 Agent Loop,把后者分散称为 skills/memory/learning 子系统。但这对概念精准对应了代码的真实分层,且与业内 "agent inner loop" 的通用说法一致,建议读者牢牢记住。
学习目标
阅读完本节,你应当能够:
- 画出双循环架构图,标出内循环的五个步骤与外循环的五个阶段。
- 说出内循环的源码落点:
run_agent.py的 AIAgent 与agent/conversation_loop.py的主 while 循环。 - 说出外循环的源码落点:skills/、curator、learning_graph、记忆系统。
- 指出外循环向内循环的三个注入点:系统 prompt 的技能索引与记忆块、会话历史、工具面(技能管理工具)。
- 解释为什么 smolagents/OpenHands 属于"只有内循环"的 agent。
- 用双循环视角复述全书十章的地图。
一、内循环:一次会话的完整解剖
内循环是 agent 的心脏。官方 agent-loop.md 文档把 AIAgent 的职责列为:组装系统 prompt 与工具 schema、选择 provider/API 模式、发起可中断的模型调用、执行工具调用(串行或并发)、以 OpenAI 消息格式维护会话历史、处理压缩重试与备援切换、跟踪迭代预算、在上下文丢失前刷写持久记忆。一次用户输入进来后的完整生命周期(文档原文归纳):
run_conversation() 1. Generate task_id if not provided 2. Append user message to conversation history 3. Build or reuse cached system prompt (prompt_builder.py) 4. Check if preflight compression is needed (>50% context) 5. Build API messages from conversation history - chat_completions: OpenAI format as-is - codex_responses: convert to Responses API input items - anthropic_messages: convert via anthropic_adapter.py 6. Inject ephemeral prompt layers (budget warnings, context pressure) 7. Apply prompt caching markers if on Anthropic 8. Make interruptible API call (_interruptible_api_call) 9. Parse response: - If tool_calls: execute them, append results, loop back to step 5 - If text response: persist session, flush memory if needed, return
第 9 步的"loop back to step 5"就是内循环的环。它的源码形态是 agent/conversation_loop.py:2017 的一个 while 循环(第 2 章逐行精读):
2017 while (api_call_count < agent.max_iterations and agent.iteration_budget.remaining > 0) or agent._budget_grace_call: 2031 # Check for interrupt request (e.g., user sent new message) 2032 if agent._interrupt_requested: 2033 interrupted = True 2034 _turn_exit_reason = "interrupted_by_user" ... 2054 api_call_count += 1 ... 2063 elif not agent.iteration_budget.consume(): 2064 _turn_exit_reason = "budget_exhausted"
循环条件里有三重退出保险:单轮 API 调用次数上限(max_iterations)、迭代预算(iteration_budget,父子共享的线程安全计数器)与用户中断。模型不再发起工具调用而返回纯文本时,循环自然结束,run_conversation() 返回最终回复。
值得强调的是内循环的入口无关性:官方架构文档列出的入口有六个——CLI(cli.py)、网关(gateway/run.py)、ACP 适配器(acp_adapter/,对接 VS Code/Zed/JetBrains)、批处理器(batch_runner.py)、API server、Python 库直调。六个入口最终都汇到同一个 AIAgent.run_conversation(),平台差异(渲染/投递/授权)全部留在入口层消化。这也是后面第 7 章能讲"单进程 34 平台网关"的前提:网关只是内循环的一排不同形状的插头。
二、外循环★:从经验到能力的螺旋
外循环没有单一的 while 语句——它是横跨多个子系统、以"会话"为周期转动的学习闭环。README 把它描述为:"代理管理记忆并定期自我提醒。复杂任务后自动创建技能。技能在使用中自我改进。FTS5 会话搜索配合 LLM 摘要实现跨会话回溯。"拆成五个阶段:
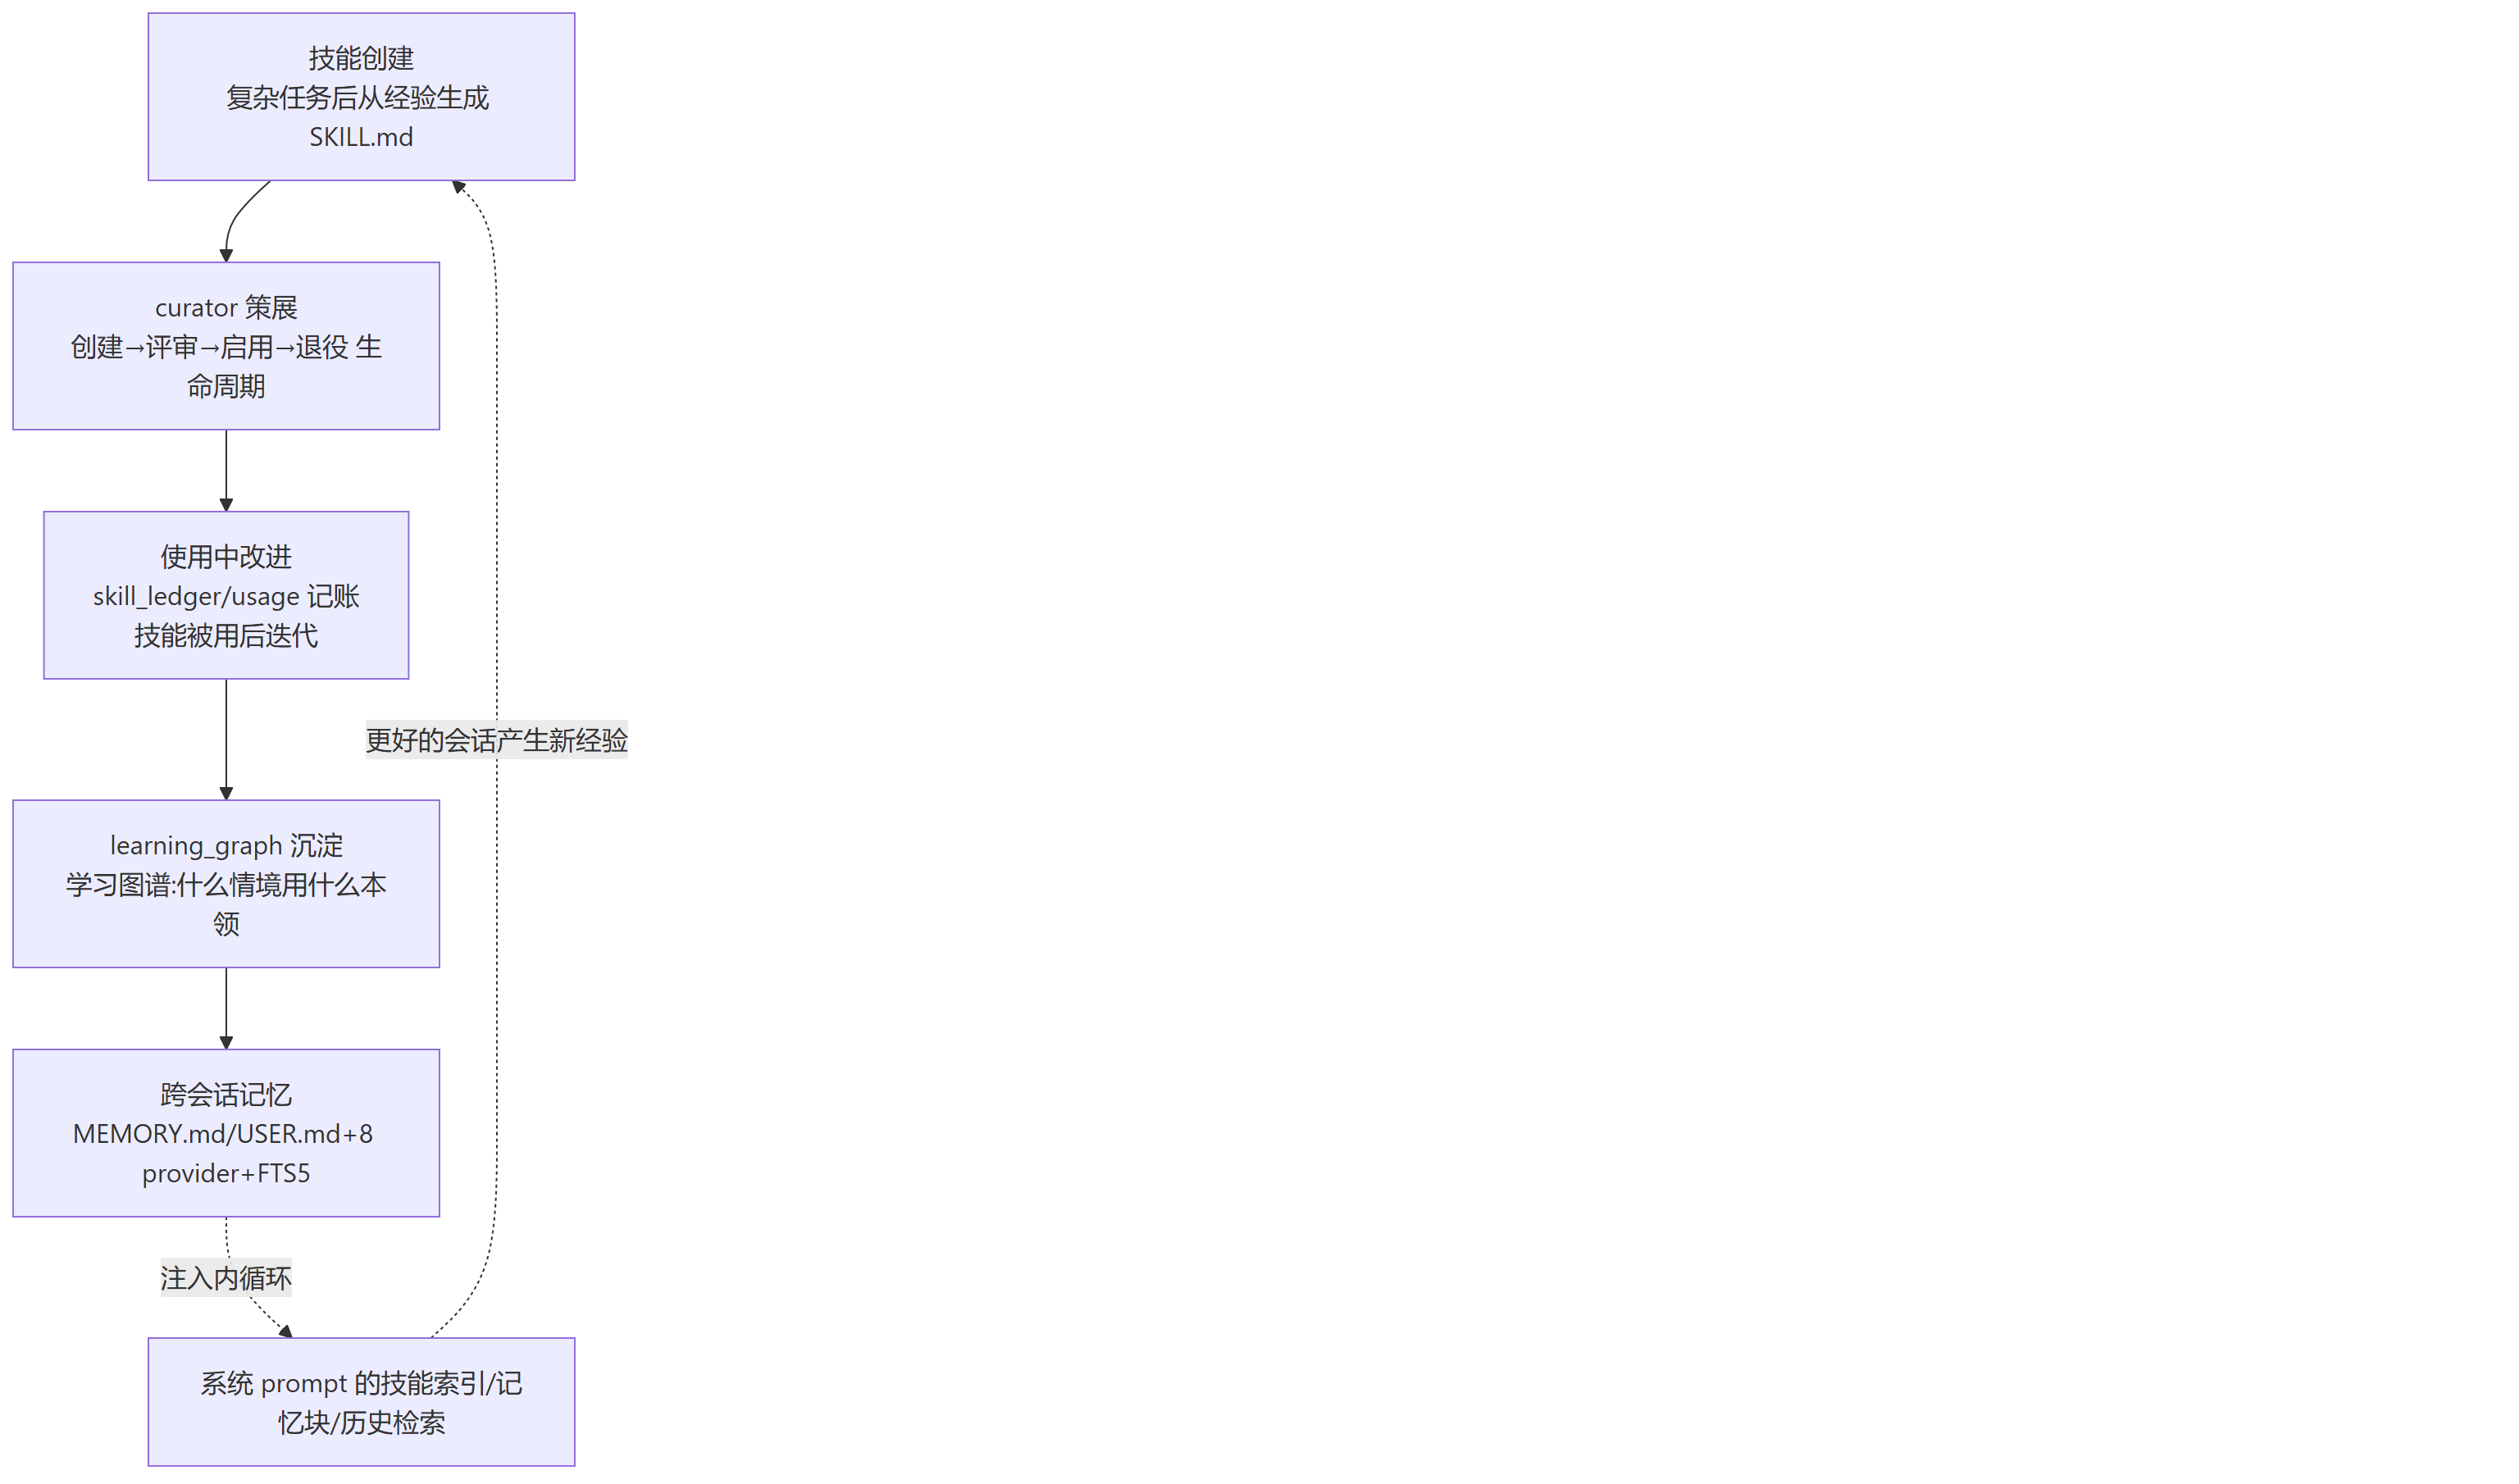
各阶段的源码落点(第 4、5 章精读):技能创建与生命周期在 agent/curator.py(策展人)与 skills/ 目录(82 个内置技能,兼容 agentskills.io 开放标准);使用记账在 skill_ledger/usage;学习图谱在 agent/learning_graph.py;记忆在 agent/memory_manager.py 加 8 个可插拔 provider。注意外循环的箭头最终都指向同一个方向——回到内循环。
两条循环的"转速"截然不同,对照如下:
| 维度 | 内循环 | 外循环 |
|---|---|---|
| 周期 | 毫秒到分钟(一次迭代/一轮会话) | 小时到月(技能沉淀/记忆演化) |
| 驱动 | LLM 的下一个 token | 用户的使用轨迹 |
| 产物 | 一条回复、一次工具副作用 | 一份技能、一条记忆、一次图谱关联 |
| 失败代价 | 重试一次(第 2 章的备援链) | 错误技能被 curator 评审拦下 |
| 度量 | token/迭代数 | 技能命中率/记忆召回质量 |
用一次具体任务串起整条链:你让 Hermes"每周五从三个数据源抓数、清洗、画图、发周报到飞书"。第一次它靠内循环摸索着做完(terminal/file/browser/web 工具来回调用,几十次迭代);任务收尾时外循环启动——模型判断这套流程有复用价值,调 skill_manage 把流程写成一份 SKILL.md(目标、步骤、坑、验证方式);curator 评审后启用。下周五再跑:系统 prompt 的技能索引里有它,模型 skill_view 展开细节照方抓药,迭代次数骤降;跑完发现数据源改版,顺手修订技能。一个月后 learning_graph 里沉淀出"周报类任务→该技能"的关联;MEMORY.md 记下你的偏好(要中文图表标题)。这就是"用得越多越强"的机械原理:每次会话的外产物,都是下次会话的内省力。
三、两个循环如何耦合:三个注入点
外循环的产物不是摆在仓库里好看的,它们通过三个注入点进入内循环的每一次 API 调用:
注入点一:系统 prompt。agent/system_prompt.py:341 的 build_system_prompt_parts 把系统 prompt 组装为三层缓存梯队,外循环产物恰好占据其中两层:
341 def build_system_prompt_parts(agent, system_message=None) -> Dict[str, str]: 342 """Assemble the system prompt as three ordered cache tiers. 344 Returns a dict with three keys: 345 * ``stable`` — the cross-session-stable prefix ... 347 * ``context`` — the workspace snapshot ... context files ... 350 * ``volatile`` — skills index, memory snapshot, user profile, 351 external memory provider block, timestamp line.
volatile 层的内容几乎全是外循环产物:技能索引(模型由此知道"我会什么")、MEMORY.md/USER.md 记忆快照(第 5 章讲的有界策展记忆)、外部记忆 provider 的块。组装好的 prompt 缓存在 agent._cached_system_prompt 上,整个会话期间字节级不变——这是第 6 章"prompt caching 神圣不可侵犯"铁律的伏笔。
**注入点二:会话历史。**跨会话检索(session_search 工具查询 SQLite FTS5)、压缩产生的摘要会话(lineage 子会话)、委派 subagent 的结果回注,都以消息形式进入 messages 列表。
注入点三:工具面。skills_list/skill_view/skill_manage 三个技能管理工具与 memory 工具本身就是内循环可调用的工具(第 3 章 toolsets)——模型在会话中就能"翻阅"甚至"增改"自己的本领,这是外循环最激进的设计:内循环的每一步都可能成为外循环的驱动力(例如模型做完复杂任务后主动创建技能)。
四、与 smolagents/OpenHands 的对比
用双循环坐标衡量几个常见 agent 框架:
| 框架 | 内循环 | 外循环 |
|---|---|---|
| smolagents | 有(MultiStepAgent 的 ReAct/代码循环) | 无——工具与 prompt 写定后,agent 不因使用而变强 |
| OpenHands | 有(事件流驱动的会话循环) | 无——记忆是简单的会话内追加 |
| Claude Code 等 coding agent | 有 | 部分(skills/CLAUDE.md 手动维护,无自动策展) |
| Hermes | 有(AIAgent) | 有★:创建→策展→改进→沉淀→注入,全自动 |
本教程作者此前精读过 smolagents:它的 CodeAgent 把工具调用降维成代码执行,单循环设计优雅紧凑,但跑一万次任务后它还是原来的它。Hermes 的赌注相反:agent 的价值随使用时间复利增长——代价是系统复杂度暴涨(183 万行 vs smolagents 的数万行)。理解这个取舍,就理解了为什么 Hermes 要把技能系统、curator、learning_graph、记忆 provider 做成一等公民,也理解了本教程为什么用"双循环"来组织全书:
第 1 章 全貌与双循环(本章) 第 2 章 内循环:Agent Loop 全解剖 ← 骨架 第 3 章 行动器官:工具系统 ← 内循环的手 第 4 章 外循环★:技能自我改进(全书高潮) ← 灵魂 第 5 章 记忆器官 ← 外循环的仓廪 第 6 章 上下文工程 ← 两个循环共用的燃料管理 第 7 章 社交器官:34 平台网关 ← 内循环的多个入口 第 8 章 协作器官:多 Agent ← 内循环的自我复制 第 9 章 中文生态与模型 provider ← 双循环的本地化土壤 第 10 章 研究管线与工程纪律 ← 把内循环的轨迹变成训练数据
💡 循环要点:双循环的本质是一句话——内循环花 token,外循环攒资产。内循环每转一圈消耗 API 调用,但如果圈里做过的事能凝结成技能与记忆,下一圈就省了。判断任何 agent 框架的"进化潜力",就看它的外循环有几个阶段是自动的:Hermes 是全部五个阶段,smolagents 是零个。第 2 章起,我们钻进这颗心脏的内部。
本节要点回顾
- 内循环=会话循环:消息→prompt→LLM→工具→回填→循环→回复;源码在
run_agent.py的 AIAgent 与agent/conversation_loop.py:2017的 while 循环。 - 内循环三重退出保险:
max_iterations、iteration_budget(线程安全 consume/refund)、用户中断(_interrupt_requested)。 - 外循环五阶段:技能创建→curator 策展→使用中改进→learning_graph 沉淀→跨会话记忆;源码在 skills/、
agent/curator.py、agent/learning_graph.py、记忆系统。 - 三个注入点:系统 prompt 的 volatile 层(技能索引+记忆块)、会话历史(检索/摘要/委派回注)、工具面(skill_manage/memory 本身是工具)。
- 系统 prompt 分 stable/context/volatile 三层缓存梯队,会话期间字节级稳定,缓存命中优先。
- smolagents/OpenHands 只有内循环;Hermes 的差异化是全自动外循环——"用得越多越强"。
- 全书十章按双循环组织:第 23 章解剖内循环与工具,第 45 章是外循环高潮,第 6~10 章展开器官与生态。
下一章进入心脏手术:逐段精读
run_agent.py(9215 行)的 AIAgent 类——从约 60 个构造参数开始,看清这个巨型类的骨架。