- 文集信息
- 目录大纲
- 最新文档
- 知识宇宙
文集详情
文集导读
教程导读
一句话定位:这是一部从内存布局出发讲透 NumPy 的教程——不看魔法看地址,读完你能对任何一个数组操作说出"它动没动内存、动了多少"。
这个教程解决什么问题
很多人学 NumPy 的路径是:背一遍创建函数,背一遍切片语法,背一遍广播规则,然后在上千万级数据的任务里写出一行慢十倍的代码,还不知道慢在哪。问题不在函数没背全,而在从来没看过 ndarray 在内存里到底长什么样。
NumPy 的所有速度优势都建立在一个事实上:ndarray 是一块连续内存加上三个描述字段(数据指针、数据类型、形状与步长)。理解了这一点,大量"奇怪现象"会瞬间变得理所当然——为什么切片修改原数组、为什么转置不花时间、为什么花式索引那么慢、为什么 copy 一不小心就爆内存。本教程把这条主线贯穿全册:先拆开 ndarray 看它的三要素,再讲步长与连续性,然后用"视图还是拷贝"这把尺子去量每一个操作,最后落到线性代数、文件读写与性能实战。
我们不打算做函数手册。官网文档查参数更方便,这里给的是判断力:拿到一个操作,你能预判它的内存代价,能解释它的行为,能在出问题时顺着内存这条线排查。
适合谁读
- 已经会一点 Python,刚接触 NumPy 或用了很久但从没关心过 dtype 和 strides 的人
- 数据分析、机器学习方向的学生或工程师,处理过"数组怎么突然改了""内存怎么爆了"这类诡异问题
- 面试准备者:视图与拷贝、广播机制是 NumPy 面试的高频考点,本册从内存层面把它们讲到底层
学完你能做什么
- 画出任意 ndarray 的内存示意图,说清 shape、dtype、strides 三者如何共同决定一个元素的地址
- 对切片、转置、reshape、花式索引、布尔掩码等操作,准确判断返回的是视图还是拷贝
- 用广播规则推演两个形状不同的数组能否运算、结果形状是什么
- 用 ascontiguous、out 参数、向量化改写等手段把热点代码提速一到两个数量级
- 排查并修复"改了切片原数组变了""float 转.int 静默截断""大文件读取爆内存"等经典故障
全册知识地图
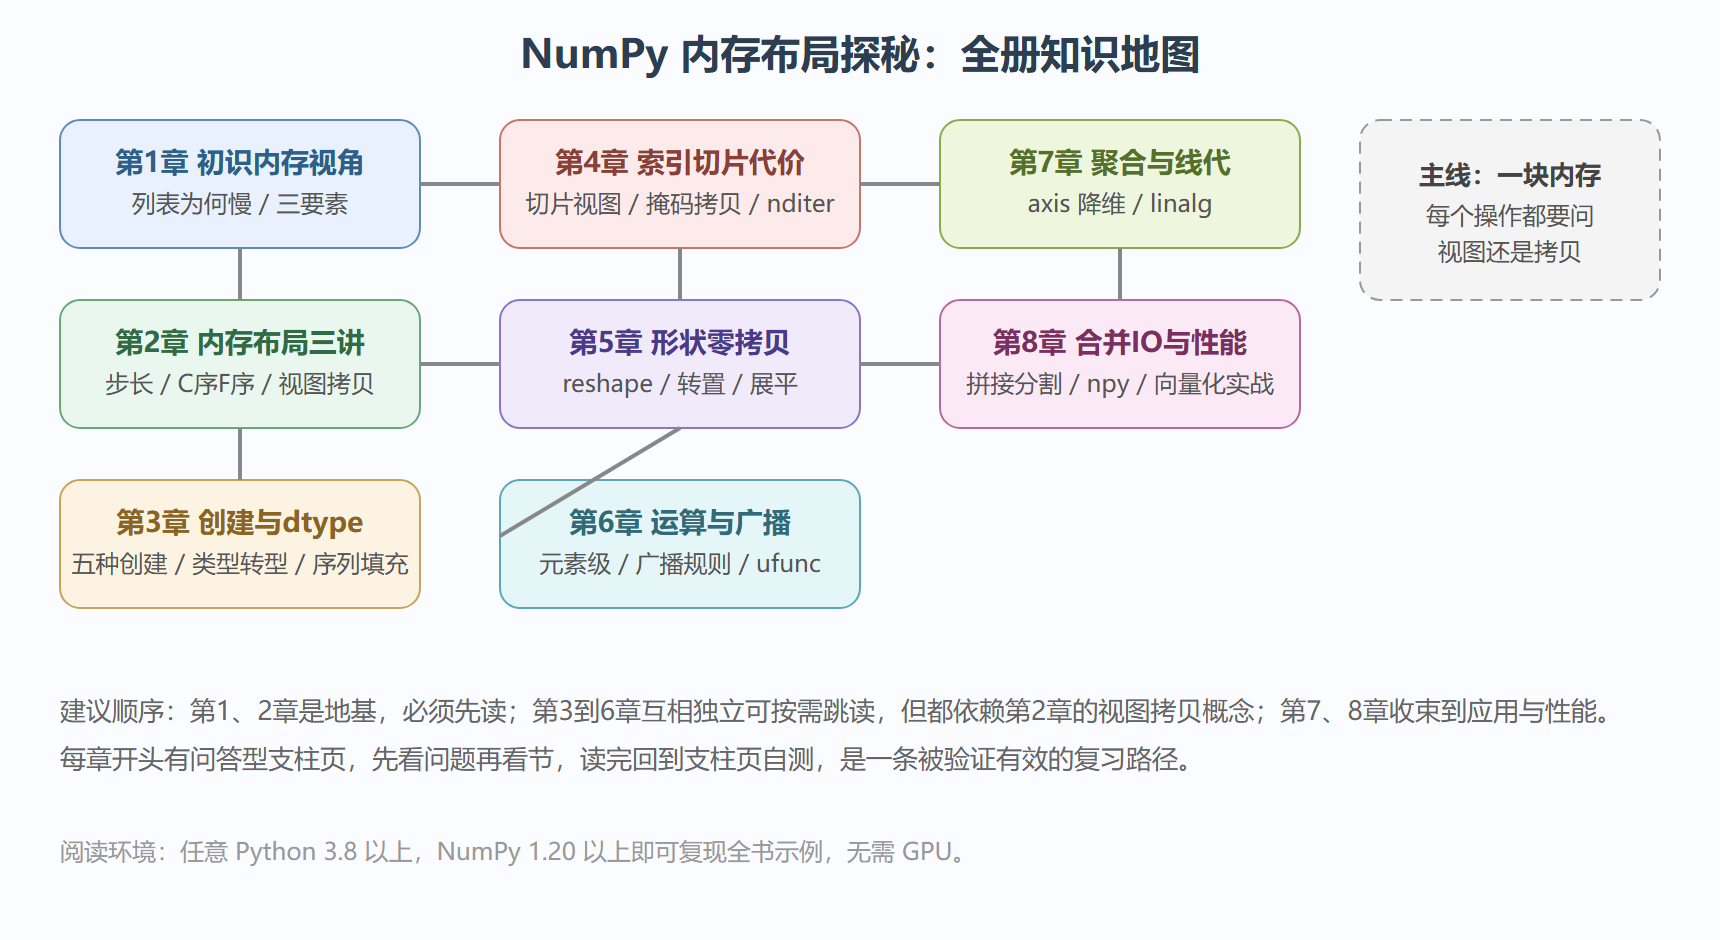
怎么用这个教程
第一遍按章顺序读,每节的代码建议亲手敲——这本教程的很多结论(比如"切片是视图")只有自己改一次数据、看着原数组变色才会真正记住。每章预计耗时 40 到 60 分钟,全书约 6 到 8 小时。第二遍可以把第 4、5、6 章当手册查:每节开头都点明了它在知识地图上的位置,方便快速定位。
需要动手环境:一台普通电脑,装好 Python 与 NumPy 即可。不熟安装的话,第 1 章第一节顺带讲了最省事的环境准备方式。
关于本教程
一是别跳过第 2 章。哪怕你已有多年 NumPy 使用经验,第 2 章的步长、连续性、视图拷贝三讲也值得完整读一遍——本册后面每一章都在引用它的结论,跳过它等于拿着没有刻度的尺子做木工。
二是代码必须亲手跑。本册大量结论以"实验加输出"的形式呈现,注释里的输出只作对照,你机器上的数字会有出入(计时尤其如此),这正是我们想建立的直觉:内存行为是可测量的,不是背诵的教条。
三是允许回读。每章支柱页用三个问题开篇,读完该章回来自测能否回答它们;答不上来的节,回去重读比硬往下走更省时间。
常见疑问快答
问:我学过一些 NumPy,还需要从头读吗?
答:翻到 1.2 节做"三要素读片"自测。能不假思索说出 strides=(24,8) 的含义,可以从第 2 章开始;说不出,就从第 1 章老实读起。
问:这本书和函数手册有什么区别?
答:手册告诉你每个函数怎么调用,本册告诉你每次调用时内存里发生什么。前者查得到,后者查不到——这正是很多"背熟接口仍写慢代码"的人缺的那一块。
问:需要数学基础吗?
答:只有 7.2 节涉及线性代数词汇(矩阵、方程组、特征值),概念不熟不影响跟跑代码;其余章节只需要算术。
目录大纲
最新文档
知识宇宙
正在加载知识图谱...