3.1 多模态智能体原理解析
3.1 多模态智能体原理解析
本节摘要:文本只是世界信息的一种形态——图片里的产品、语音里的情绪、视频里的动作,都是智能体该"看懂"的内容。本节讲清多模态智能体的价值、Agno 的支持方式(多模态模型 + 工具链),并用"看图回答 + 语音交互"两个示例落地。
学习目标
阅读完本节,你应当能够:
- 说出多模态智能体解决什么问题
- 理解 Agno 多模态的两种支撑:多模态模型与工具
- 构建能"看图说话"的智能体
- 理解语音交互的组成环节
- 选择适合场景的多模态方案
一、问题与直觉
文字智能体再聪明,也答不出"这张产品图里有没有瑕疵""这段语音是什么情绪"。真实世界的问题常以图像、语音、视频的形式出现。多模态智能体的价值就是打破"只能读字"的边界:客服能看图定位问题,内容团队能借图创作,安防能分析视频。Agno 的模型无关设计让这一步天然平滑——选对模型,多模态。
二、核心原理
2.1 多模态的两种实现路径
- 原生多模态模型:GPT-4o、Claude 等直接吃图像输入,最省事
- 单模态模型 + 工具:模型只能读文本,靠图像描述/语音转文字工具把非文本转成文本再处理
两条路都能走,选哪条取决于"模型是否支持多模态 + 延迟成本要求"。
2.2 多模态处理管线
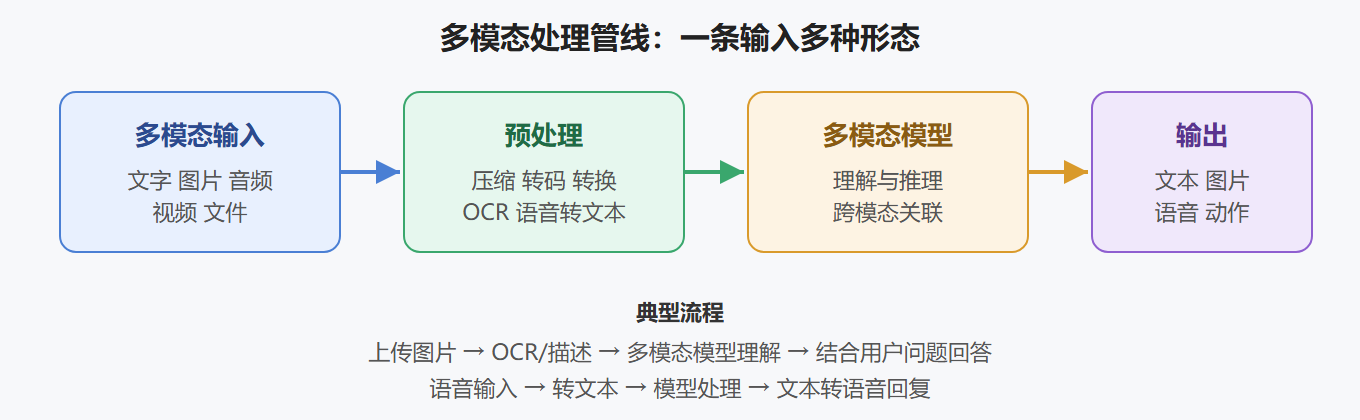
三、工程实践要点
3.1 看图说话的智能体
from agno.agent import Agent agent = Agent( name="vision_bot", description="能理解图片内容的视觉智能体", # 使用支持图像输入的多模态模型 ) # 传入图片路径与问题(概念示例,具体参数以版本为准) agent.print_response("这张图片里有什么?", images=["sample.png"])
选对支持视觉的模型后,智能体直接"看图"。没有多模态模型时,用图像描述工具把图转成文字再喂给单模态模型,效果打折但可行。
3.2 语音交互的组成
# 语音交互 = 语音转文字 + 文本智能体 + 文字转语音 # 环节一:ASR 语音转文字 text = transcribe(audio_file) # 概念示意 # 环节二:文本进智能体 agent.print_response(text) # 环节三:TTS 文字转语音 speak(agent.last_response)
💡 关键直觉:语音交互本质是"转写 + 文本对话 + 合成"三段式。智能体本身不用"会听"——ASR 把语音变文本,TTS 把文本变语音,中间的智能体只处理文本。这是落地语音助手的最简架构。
3.3 方案选型速查
| 需求 | 方案 | 备注 |
|---|---|---|
| 看图理解 | 多模态模型直接吃图 | 最省事 |
| 图片分类 | 专用视觉工具 | 精度可控 |
| 语音对话 | ASR + 文本 + TTS | 三段式 |
| 视频分析 | 抽帧 + 图像理解 | 按帧处理 |
3.4 多模态的工程成本
多模态有额外成本要算:延迟(图像比文本大,传输与推理更慢)、成本(多模态模型 token 计价更高)、存储(媒体文件要管理)。生产环境做三步:上传前压缩、只在需要时启用视觉模型、结果缓存。
⚠️ 常见坑:多模态输入容易被"整包喂给模型"——大图、长视频不预处理直接传,延迟与成本翻倍。先压缩、抽帧、截取关键片段,再交给模型。
四、图像生成管线:文本模型与图像模型的接力
原始资料里最有代表性的多模态实践,是"文本模型 + 图像生成模型"的接力结构:用户用自然语言下指令,文本模型负责理解意图、扩写画面描述,图像模型(示例用的是 DALL-E 一系)负责把描述渲染成图,图像数据以地址形式返回再做后续处理。两个模型各司其职,智能体是中间的调度层。
这种接力结构的通用性比看起来强。把图像模型换成音频模型,就是语音生成助手;换成视频模型,就是短视频素材工具。理解了"理解模型 + 生成模型"的分工,就掌握了多模态智能体的基本骨架。
用户:"画一张赛博朋克风格的猫" │ ▼ 文本模型:理解意图,扩写画面细节描述 │ ▼ 图像模型:按描述生成图像 │ ▼ 返回图像地址 → 展示 / 存储 / 二次加工
五、感知侧:自定义工具补齐眼睛和耳朵
生成之外,多模态的另一半是感知——看懂图片、听懂语音、理解视频。原始资料的做法很务实:图像识别、语音转文本、视频分析都以自定义工具的形式接入,智能体在需要时调用,拿到文本化的结果再推理。这个"感知工具化"的思路把模态处理与推理解耦,任何模态进来都先转成模型能消化的文本描述,管线立刻简化。
| 模态 | 接入方式 | 输出形态 | 典型场景 |
|---|---|---|---|
| 图像输入 | 图像识别工具 | 文字描述 | 客服看截图定位问题 |
| 语音输入 | 语音转文本工具 | 文字转写 | 会议记录、语音指令 |
| 视频 | 视频分析工具 | 关键帧/事件描述 | 内容审核、监控摘要 |
| 图像输出 | 图像生成模型 | 图像地址 | 素材创作、配图生成 |
| 音频输出 | 语音合成模型 | 音频地址 | 有声内容、播报 |
六、多模态检索:CLIP 思路与商品搜索
资料里还有一个进阶实验:多模态商品搜索。做法是为文本与图像描述选用支持跨模态的嵌入模型(思路同 CLIP 一系),把商品的文字描述和图像都映射进同一个向量空间,存入 LanceDb;查询时无论用户给的是文字还是图,都在同一空间里找最近邻。文本嵌入与图像嵌入作为独立可配置组件分开调优——文档入库可以用便宜模型,检索精度要求高再换强模型。
⚠️ 常见坑:直接拿纯文本嵌入模型去编码图像描述就号称"多模态检索",文本和图像根本不在一个语义空间里,相似度毫无意义。跨模态检索必须用跨模态训练的嵌入模型,这一点选型时要盯紧。
💡 关键直觉:多模态智能体的难点不在"支持格式",而在模态对齐——什么时候该看图、图文冲突信谁、音频噪声怎么兜底。这些是工程问题,靠工具链和指令设计解决,不是换个多模态模型就自动消失。
模态路由:别让所有模态挤一条道
多模态系统上线后遇到的第一个架构问题是路由:用户的输入五花八门,文字、截图、语音混着来,全都塞给同一个模型既贵又慢。更聪明的做法是在入口处设一个轻量分类层——判断每段输入的模态与处理路径,文本走直通、图像走识别工具、音频走转写,各走各的专线,最后在推理层汇合。分类本身可以用规则起步(按消息类型分发),量上来后再换小模型,成本几乎可以忽略。
路由之外还有降级设计:图像识别服务超时怎么办?合理策略是先回文本部分作答、标注图像稍后补充,而不是让整次请求失败。多模态系统的可用性往往不取决于最强模态的效果,而取决于最弱链路的兜底。把"某个模态暂时不可用"设计成正常状态而非故障,用户的体验才稳。
实践里还有个容易忽视的细节:模态之间的信息冗余。用户发一张报错截图又配一句"这个怎么回事",文本已经把问题说了七成,图像识别跑一趟只为确认那三成。路由层做"必要性与否"的判断(比如文本已含明确问题时降级图像处理),能省下可观成本。这类优化没有教科书答案,全靠对自己业务流量分布的观察。
七、常见问题
现在就能在生产里用视频理解吗?
谨慎。视频理解的算力成本高、误差累积快,稳妥路径是"关键帧抽取 + 图像理解"的组合,把视频问题降维成图片问题,成本可控且技术成熟。
多模态会话的记忆怎么存?
通用做法是存"模态内容的文本化描述 + 原始引用"。描述进上下文供模型推理,原始文件按地址引用,需要时再取。全量原始数据进上下文既贵也没必要。
语音场景的延迟怎么压?
流水线化:语音转写、推理、合成三段并行设计,转写用流式模型边说边转,合成用低延迟音色。框架层能做的是把三段接成管线,延迟大头在各模型服务本身。
多模态落地的现实检查表
决定把多模态能力做进产品前,过一遍这份检查表。其一,模态必要性:这个模态解决的是真需求还是演示效果?客服看截图是真需求,给天气查询加语音输入就多半是花活。其二,数据可得性:训练与测试用的多模态数据够不够?图文场景至少要准备一批真实业务截图做验证,实验室图片的表现毫无参考价值。其三,错误容忍度:识别错误的后果多严重?把药盒照片认错的代价,与把商品照片认错的代价,完全不是一个量级,后者可以乐观上线、前者必须有人工复核。其四,成本与延迟:多模态处理的单位成本通常是纯文本的数倍,高频场景要先算账。
四项检查都过关,再进入技术选型;有一项存疑,就先做小范围试点而不是全量上线。多模态技术仍在快速演化,今天的最佳实践半年后就可能刷新,因此架构上保持模态处理层的可替换性——识别工具封装成独立组件,模型可换、管线不动——比押注任何一个具体方案都重要。这不是保守,是把变化当成常态来设计。
多模态的测试数据策略
多模态功能的质量验证,难点在测试数据。纯文本场景随手就能造一百个测试问题,图文场景却要费心收集真实业务图像——而实验室里精心挑选的图片会把系统表现高估一大截。务实的做法有三条:优先收集"困难样本"(模糊、逆光、小字、遮挡的真实图片),它们才是线上流量的常态;按业务分布配比测试集(客服场景就多用用户随手拍的截图,别用产品渲染图);每类典型失败建立"坏案例相册",回归时优先验证老毛病没复发。测试数据贴近真实,评估数字才有意义,这条朴素的道理在多模态场景比任何地方都重要。
一节小结
- 要点一:多模态智能体打破"只能读字"的边界,客服、创作、安防是典型场景
- 要点二:两条路径——原生多模态模型或单模态模型加转换工具
- 要点三:语音交互是 ASR + 文本 + TTS 三段式,智能体只处理文本
- 要点四:看图说话选多模态模型,用工具转文本是降级方案
- 要点五:多模态有延迟、成本、存储三笔额外账
- 要点六:先压缩抽帧再喂模型,别整包硬塞
多模态把能力做宽了,下一节把"知识"做准——RAG 检索增强的进阶实战。