3.2 知识库与 RAG 进阶实战
3.2 知识库与 RAG 进阶实战
本节摘要:2.4 教会你"挂上知识库",本节解决"检索质量差、回答不准"的进阶问题。内容覆盖 RAG 的三个关键环节——分块策略、检索优化、知识管理,并给出"先诊断检索质量,再针对性调优"的实战方法。
本节目标
阅读完本节,你应当能够:
- 说清影响 RAG 回答质量的关键环节
- 按场景设计合理的文档分块策略
- 用 top-k、相似度阈值等参数优化检索
- 管理多源知识与知识更新
- 诊断"检索不到/答不准"的问题根因
一、问题与直觉
知识库挂了,回答还是不准——这是 RAG 落地最常见的心结。问题多半不在模型,而在检索链路:文档分块太粗,语义被切碎;检索到的片段不相关;知识更新后没重新导入。本节把 RAG 的质量链路拆开,逐个环节给调优手段。
二、核心原理
2.1 RAG 质量的三个关键环节
诊断 RAG 问题先看全链路:
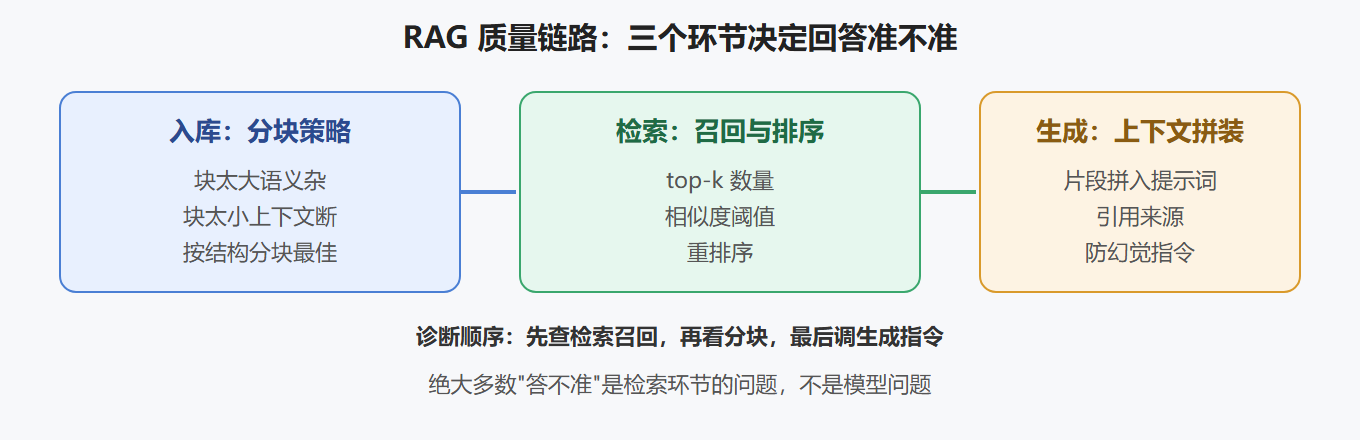
回答质量 = 入库质量 × 检索质量 × 生成质量,三者是乘法关系,任何一环为 0 结果就是 0。
2.2 分块策略的核心矛盾
分块是"粒度"的取舍:块太大,一个块里塞多种语义,检索时命中不精准;块太小,上下文被切断,模型理解不了来龙去脉。最佳实践是按文档结构分块——按段落、标题、章节切,让每个块语义完整。
三、工程实践要点
3.1 分块策略速查
| 文档类型 | 推荐策略 | 理由 |
|---|---|---|
| 技术手册 | 按章节/标题分块 | 语义天然完整 |
| 长段落文本 | 固定大小 + 重叠 | 避免切碎 |
| FAQ 列表 | 每个问答一块 | 语义自足 |
| 表格数据 | 按行/按表分块 | 保持结构 |
3.2 检索参数调优
from agno.knowledge import AgentKnowledge from agno.vectordb.lancedb import LanceDb knowledge = AgentKnowledge( vectordb=LanceDb(table_name="docs"), # 检索时返回更多候选,提升召回 # 具体参数名以当前版本为准 )
💡 关键直觉:先看召回再看精度。答不准时先调大返回片段数(提高召回),看能不能找到正确答案;找到了但顺序乱,再考虑重排序;全找不到,回源头查分块与导入。
3.3 知识更新与版本管理
# 全量重导:数据量小时最简单 knowledge.load_documents("new_docs.pdf") # 版本化:不同版本用不同表,切换引用 vectordb_v2 = LanceDb(table_name="docs_v2")
知识库要跟上文档更新:小知识库全量重导;大知识库按版本分表、增量导入;定时任务里"拉文档 → 入库 → 切换引用"做成流水线。
3.4 多源知识管理
不同来源的知识(官网、手册、FAQ)建议分表存储,检索时按需选择来源或合并检索。好处:来源可追溯、更新互不影响、单表查询更快。生产环境给每个知识源一个表名与元数据标签。
3.5 质量诊断流程
| 症状 | 第一步检查 |
|---|---|
| 答非所问 | 检索到的片段是否相关(打印检索结果) |
| 检索为空 | 文档是否导入、向量库是否非空 |
| 知识过时 | 是否重新导入最新文档 |
| 回答太泛 | 是否开了 search_knowledge、片段数是否够 |
| 出现幻觉 | 加"没有就明说"指令,要求引用来源 |
⚠️ 常见坑:调参后忘了重新导入文档——改了分块或换了向量库配置,但知识还是旧的那份。任何入库侧改动,都要重新 load 再验证检索结果,别只改代码不重建索引。
四、进阶第一步:把脏数据洗干净
入门示例用的 PDF 干净规整,真实文档远没有这么客气:HTML 标签、超链接残留、特殊字符、页眉页脚噪声,样样都有。原始资料专门给了一段包含 HTML 与特殊字符的示例文本演示清洗——这一步的价值在于,嵌入模型对噪声很敏感,脏数据进库,检索质量从源头就废了。
清洗的基本动作:剥掉标记语言的标签与结构符号、合并断行、去掉重复的页眉页脚、统一全半角与空白符。动作不复杂,贵在把"清洗"固定成入库前的标准工序,而不是出问题后回来返工。
五、进阶第二步:检索质量的自测方法
资料里的第二个实验给出了可复现的自测路径:用句向量模型编码一批示例文本,建 FAISS 索引,查询向量化后做 Top-K 相似检索。整个流程几十行代码,却是评估"嵌入模型 + 切块策略"组合效果的标尺:拿一批真实业务问题跑检索,人工判定命中块是否相关,命中率就是你的基线。换嵌入模型、调块大小后再跑一轮,升降立见。
# 思路骨架(句向量 + 向量索引) # 1. 加载句向量模型 # 2. 文档切块 → 逐块向量化 # 3. 建向量索引 # 4. 查询向量化 → Top-K 检索 → 返回最相关的块
| 检索策略 | 一句话原理 | 见效场景 |
|---|---|---|
| Top-K 相似检索 | 取相似度最高的 K 块 | 基线方案,先跑通它 |
| 预加载知识库 | 启动时把库载入内存 | 首查延迟高的大库 |
| 查询改写 | 模型先把口语问题改写成检索式 | 用户表述随意的产品 |
| 多路召回 | 关键词与向量并行再融合 | 专业术语多的领域 |
预加载是原始资料里点名的优化项:知识库较大时首次查询要把库从磁盘载入,耗时明显;启动阶段预载,用内存换首查延迟。
六、进阶第三步:让模型学会"不知道"
RAG 系统最伤信任的不是答错,而是一本正经地编。资料给出的对策是检索与生成两侧同时收紧:检索侧控制返回块的相关度门槛,低于门槛视为"没检到";生成侧指令明确"只依据给定内容回答,无依据就说明找不到"。两侧夹击后,系统才会老实承认"文档里没有"。
评估 RAG 升级效果时,别只看"答对率",加两个更诚实的指标:拒答正确率(该说没有时真说了没有)、引用命中率(答案要点能对应到检索块)。这两个指标上去,系统才算敢面向用户。
⚠️ 常见坑:迭代 RAG 时一次动多个变量(同时换嵌入模型、调块、改指令),效果变了却不知道功劳算谁的。一次只动一个变量,跑一轮固定的问题集,记录指标,再动下一个。
指标体系:把"感觉变好了"换成数字
RAG 调优最容易陷入的循环是"改了、感觉好了、上线、又被打脸"。破局靠一套小而硬的指标体系,四个数就够用。检索命中率:该检到的块有没有出现在返回结果里,衡量"找"的能力;答案忠实度:答案里的断言能否在检索块中找到出处,衡量"编"的程度;拒答正确率:库里没有的内容是否如实说没有,衡量"诚实度";端到端延迟与成本:每次问答的花费,衡量"经济性"。
四个指标的采集方式都很朴素:命中率靠人工标注一批"问题—应命中的块",忠实度靠抽样人工核对断言出处,拒答靠故意问一批库外问题,成本直接从请求日志统计。半小时建集,长期复用。关键是每次调优前后都测同一批,形成可比的时间序列。
指标之间会打架:检索返回块数调多,命中率升但成本与噪声也升;指令收紧忠实度,答案可能变得过度保守。调优的艺术就是在四个指标间找业务能接受的平衡点,而这个平衡点只能由你的业务定义——客服场景忠实度优先,资讯场景命中率优先,先定优先级再拧旋钮。
七、常见问题
向量库越大越好吗?
相反,精准比海量重要。按业务域分库、定期清理过时文档、给块加元数据过滤条件,小而准的库检索质量与速度都更好。
嵌入模型要不要跟着生成模型一起升级?
两者独立,各自评估。嵌入决定"找得准不准",生成决定"答得好不好",瓶颈在哪边就升哪边,盲升级只是烧钱。
RAG 和长上下文模型会二选一吗?
短期内是互补。长上下文适合单次会话塞进少量文档的场景;知识规模大、多智能体共享、需要溯源与权限控制时,RAG 仍是主干。把 RAG 当"外挂记忆管理"而非临时补丁,就不会被淘汰焦虑绑架。
高级检索模式:何时跨出向量检索
向量相似度是检索的基线而非终点,几类高级模式各有其主场。混合检索(向量加关键词)适合专业术语密集的领域——型号、法规编号这类精确词,向量反而容易模糊掉,关键词精确命中后再与语义召回融合,两头兼顾。重排序在召回之后加一道精排:先用便宜的方式召回几十块,再用更强的模型对候选精排取前几,质量与成本取得漂亮平衡,是进阶调优的首选投资。多跳检索处理需要连环推理的问题("A 的供应商的竞争对手是谁"),第一轮检索定位实体,第二轮带着新线索再检索,模拟人类的翻资料过程。
选择逻辑很简单:先用纯向量跑出基线,看错误分布。错在"检不到专业词"上混合检索,错在"检到了但排序烂"上重排序,错在"需要两步才能找到答案"上多跳。没有错误分析就上高级模式,多半是把好钱花在不对的地方。这也是进阶章节想传递的核心工作方式:一切优化从错误样本出发,而不是从技术清单出发。
一个完整的调优案例走读
把本章方法串成一个虚构但典型的案例。某政策问答系统上线,用户反馈"答非所问"。第一步错误分析:抽样五十条坏案例,发现六成是检索没命中——问题用了口语("外地户口能办吗"),文档写的是术语("非本地户籍申请条件")。第二步对症:上查询改写,让模型先把口语翻译成术语再检索,命中率回升。第三步复测:又发现两成错误出在"检到了但排后面",加轻量重排序,取前三精排。第四步固化:把五十条坏案例变成回归集,指标从七成正确率爬到九成后写进周报。整个过程没有换过任何模型——调优的胜负手从来都在管线与数据,不在追新。
核心回顾
- 要点一:RAG 质量是"入库 × 检索 × 生成"的乘法关系
- 要点二:分块按文档结构切,块内语义要自足
- 要点三:先调大召回看能不能找到,再谈排序与精度
- 要点四:小库全量重导,大库版本分表、增量导入
- 要点五:多源知识分表存储,来源可追溯
- 要点六:绝大多数"答不准"是检索问题,不是模型问题
知识做准了,下一节看团队怎么协作——多智能体协作机制详解。