2.4 议题与目标:任务拆解的会议学
2.4 议题与目标:任务拆解的会议学
本节摘要:任务与目标机制决定"这场会讨论什么、讨论到什么程度算完"。本节讲 OWL 里目标(Goal)与议题(Task)的层次关系,给出把一句模糊需求改写成可验收议题的四要素法(对象、问题、标准、格式),并用贯穿案例做一次完整的拆解演练。
本节从名册转向机制:有了角色还不够,会议要开得成,议题本身得是"能开工、能验收"的。这是 2.2 主持人"拆解"环节的原理层,也是第 4 章跑会前必须想清楚的一步。
一、目标与议题:两层粒度
OWL 的任务模型里,目标(Goal)是用户要的最终结果,议题(Task)是为了达成目标而需要逐项完成、逐项验收的工作单元。两者粒度不同,混用是会议低效的第一大根源:拿目标当议题,一步干不动;拿议题当目标,干完也交不了差。
用贯穿案例对齐概念。目标是"产出发给管理层的竞品定价对比纪要";议题则是一个清单——打开三个竞品的定价页、折算计费口径、计算差价、分析定价结构对应的功能取舍、成文。目标负责"为什么开这场会",议题负责"这轮讨论什么、谁来做、做到什么标准"。
二、四要素法:把模糊需求改写成可开工议题
一句模糊需求要变成可开工议题,补齐四要素就够:对象(对谁做什么)、问题(要回答什么)、标准(怎么算做完)、格式(交付长什么样)。四要素缺一项,对应一种典型的返工现场:缺对象则范围失控,缺问题则资料堆砌,缺标准则验收扯皮,缺格式则成文返工。
def rewrite_task(raw: str) -> dict: """四要素改写示范:把一句模糊需求改写成结构化议题。 真实场景由用户智能体在对话中补全,这里演示结构。""" return { "对象": "竞品A、竞品B、竞品C 的公开订阅定价", "问题": [ "各竞品三档价位与我们的差价百分比是多少", "价位差异对应哪些功能取舍", ], "标准": [ "价格统一折算为按月付年费口径", "差价百分比给出计算式,基期为我们的定价", ], "格式": "一页纪要:先结论表,后两段分析", } # 输出(打印成议题卡): # 【议题卡】 # 对象: 竞品A、竞品B、竞品C 的公开订阅定价 # 问题: 1) 三档价位差价百分比 2) 价位差异对应哪些功能取舍 # 标准: 折算口径统一;差价给计算式,基期为我们的定价 # 格式: 一页纪要:先结论表,后两段分析
改写的价值在验收时兑现:主持人核表用的正是"标准"两个字段里的条目。没有这两个条目,"做完了"与"做好了"之间就是无穷拉扯。
三、工程实践要点:依赖关系与并行度
议题拆出来之后还有一道工序:标注依赖关系。哪几项可以并行(互不依赖,可同时开干),哪几项必须串行(后项吃前项的产出)。并行度直接决定会议时长——OWL 的会程是按轮次推进的,能并行的议题压在一起发,轮次显著缩短。
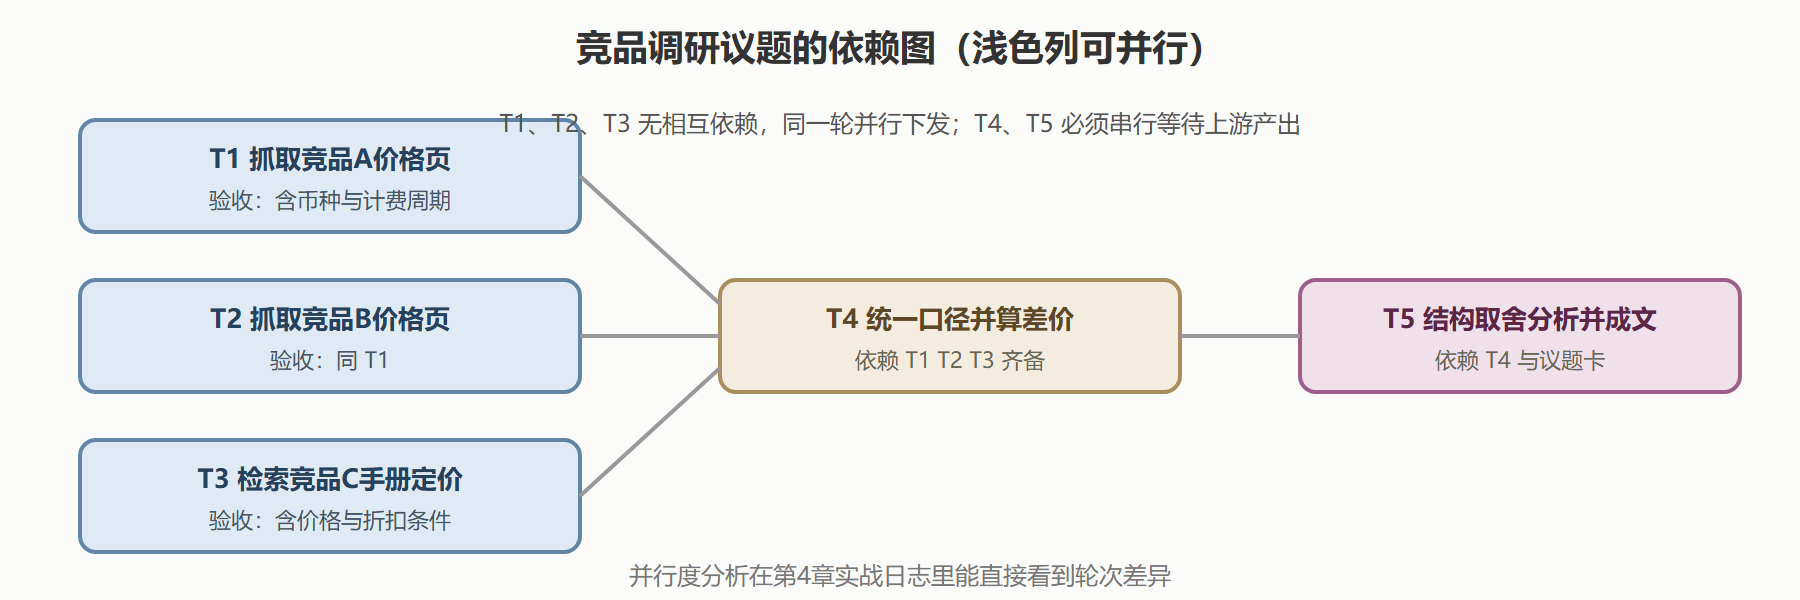
一个反直觉的取舍:先并后串
我建议的拆解顺序是"先把所有叶议题拆完,再统一标依赖",而不是拆一个派一个。原因:拆解本身会暴露新议题(拆 T3 时才想到竞品C定价在手册里),边拆边派会导致已派出去的议题反复返工。先拆完、再排序、后下发,多花一轮思考,省掉多轮返工。
def schedule(tasks: list) -> list: """按依赖关系分层:返回按轮次分组的议题列表。 tasks: 每项含 id 与 depends 字段。""" done, rounds = set(), [] while len(done) < len(tasks): layer = [t["id"] for t in tasks if t["id"] not in done and set(t["depends"]) <= done] if not layer: # 依赖成环,会议开不下去了 raise ValueError("议题依赖存在环,请人工梳理") rounds.append(layer) done.update(layer) return rounds # 输出: # schedule([ # {"id": "T1", "depends": []}, {"id": "T2", "depends": []}, # {"id": "T3", "depends": []}, {"id": "T4", "depends": ["T1", "T2", "T3"]}, # {"id": "T5", "depends": ["T4"]}]) # -> [['T1', 'T2', 'T3'], ['T4'], ['T5']]
案例展开:一次拆解翻车与重拆
背景:某团队第一次跑竞品调研,主持人把目标直接当成了唯一议题——"调研三个竞品并写纪要",一轮下发。结果:浏览器专家接到巨单,抓了三个站点四十多个页面,上下文塞满,价格数据与功能描述混在一起,最终纪要里竞品 B 的价格串到了竞品 A 头上。解读:这不是专家无能,是议题粒度错了——没有验收标准的巨单,谁接谁砸。操作(重拆):按四要素法把巨单拆成 T1 至 T5,叶议题并行下发,每个都带验收标准;二次跑会,全程十一轮,纪要一次过审。变式:如果你的议题天然带探索性(比如"找出市场上所有值得关注的新竞品"),允许第一轮只拆出"侦察议题",侦察结果回来再拆正式议题——探索型任务允许两段式拆解。
⚠️ 议题卡不是越多越好。每张卡都有固定的轮次开销,五张以内的议题卡能覆盖八成调研类任务;超过五张,先合并同类项再开会。
议题卡的复用:模板化与参数化
议题卡写多了会发现一个规律:同类任务的卡片高度相似。竞品调研的卡片永远是"抓取、折算、分析、成文"四段;材料核对类任务的卡片永远是"登记、转换、核对、出清单"。把相似的卡片模板化,是议题机制里性价比最高的一步——模板存结构,参数存差异:
CARD_TEMPLATES = { "调研类": {"要素": ["对象清单", "问题清单", "口径标准", "纪要格式"], "默认并行": True, "默认验收字段": ["来源", "新鲜度"]}, "核对类": {"要素": ["材料清单", "核对点", "通过标准", "差异报告格式"], "默认并行": False, "默认验收字段": ["差异项", "核对人"]}, } def instantiate(template: str, params: dict) -> dict: """从模板生成议题卡:结构来自模板,内容来自参数。""" card = dict(CARD_TEMPLATES[template]) card.update(params) # 参数覆盖默认值,模板保底结构 return card # 输出: # instantiate("调研类", {"对象清单": ["竞品D", "竞品E"]}) # -> {'要素': ['对象清单', '问题清单', '口径标准', '纪要格式'], # '默认并行': True, '默认验收字段': ['来源', '新鲜度'], # '对象清单': ['竞品D', '竞品E']}
模板化的收益不止省事:它让"这场的议题卡比上期少了口径标准"这类退化在开工前就暴露——模板里该有的字段不在,说明拆解退化了。第 5 章常设委员会的"议题卡模板统一"检查项,要求的正是这份模板库。
本节要点回顾
- 目标与议题分层:目标管"为什么开会",议题管"这轮讨论什么",混用是低效第一根源;
- 四要素法:对象、问题、标准、格式,缺哪项就有对应的返工现场;
- 依赖分层:叶议题并行、下游串行,先拆完再排序后下发;
- 两段式拆解:探索型任务允许先派侦察议题;
- 下一节解决"开完会就散"的问题:纪要怎么写进集体记忆。