2.5 会议纪要与集体记忆
2.5 会议纪要与集体记忆
本节摘要:会议最怕开完就散——上次的结论、踩过的坑,下次会全忘。本节讲 OWL 的知识与记忆机制:对话史怎么维护、向量检索怎么按需取材、长期沉淀怎么跨会传承,以及"纪要写不好,记忆就白建"的实操要点。本节是与会名册的收尾,也为第 5 章多场会议协同埋下伏笔。
一、问题与直觉:上下文窗口不是记忆
一个常见误解是把上下文窗口当记忆。窗口是桌面——只放当前正在讨论的材料;记忆是档案柜——放历史会议的结论、数据与教训。把所有历史对话全堆在桌面上,窗口很快被挤爆(1.1 节的失效二),模型开始遗忘最早的关键信息。记忆机制要解决的是:桌面永远有限,怎么保证每个时刻桌面上放的恰好是最有用的材料。
二、三层记忆:各管一段遗忘
OWL 借助其底层的 CAMEL 记忆体系,把记忆分成三层,每层对抗一种遗忘:
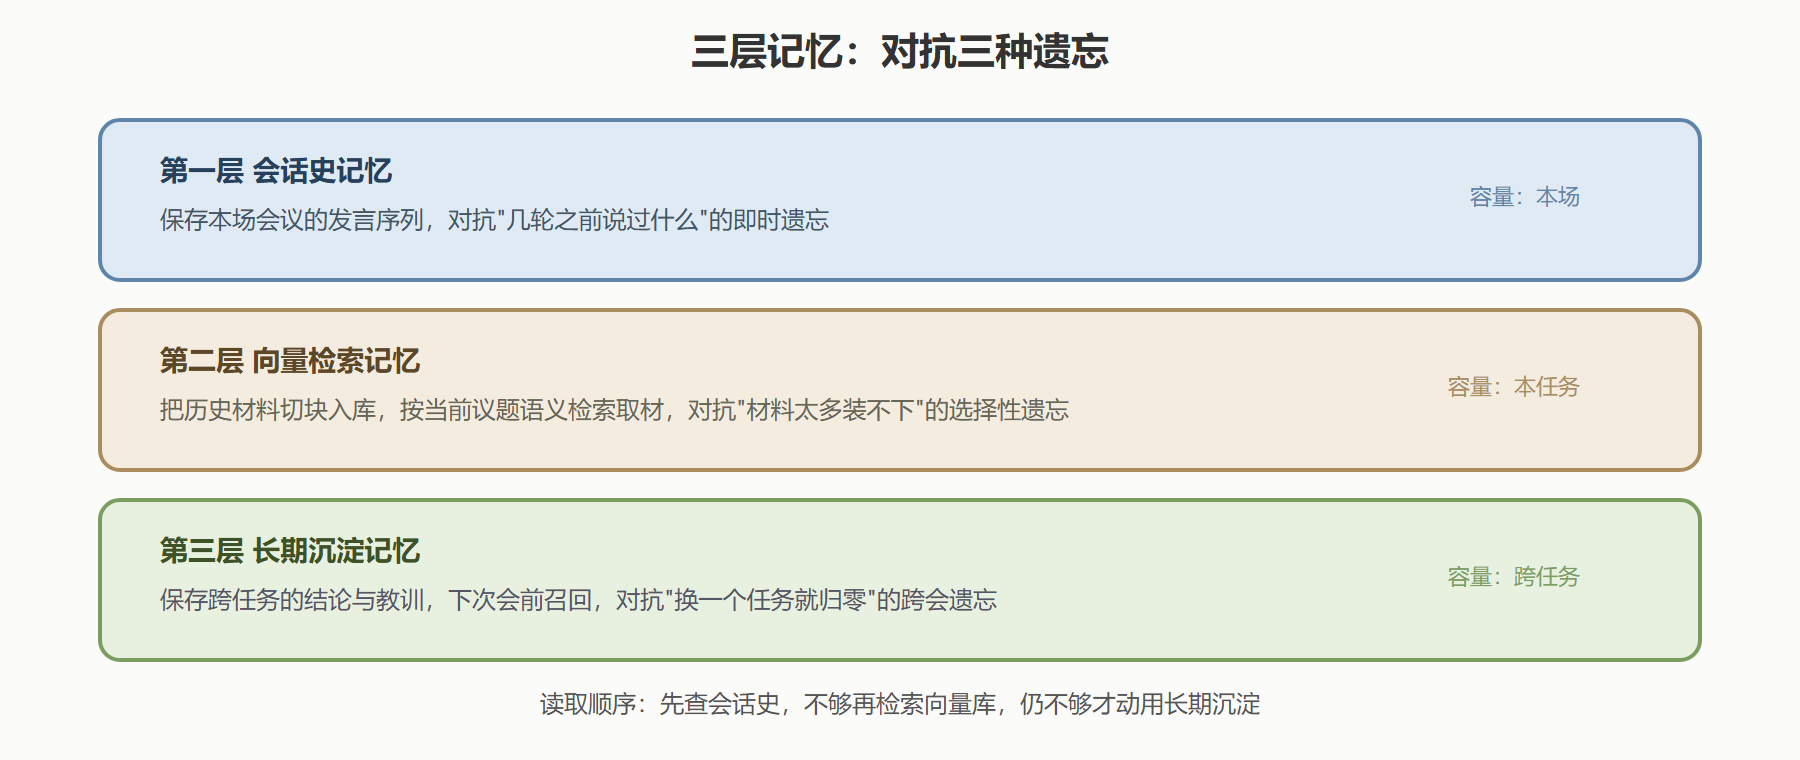
三层分工的直觉:会话史保证"刚才的话不丢",向量检索保证"关键材料随取随用",长期沉淀保证"经验跨会传承"。写作时最容易忽略第三层,但它恰恰是会议纪要主调的核心——纪要不是给本场看的,是给下一场看的。
三、工程实践要点:纪要怎么写才进得了档案柜
纪要三段式
能让记忆机制高效检索的纪要,通常是三段式:结论先行(本会达成了什么,一句话每条)、证据索引(结论依据哪份材料,标注来源)、遗留事项(哪些问题没解决、原因是什么)。三段式不是文风偏好,是检索优化:散会后,结论段进入长期沉淀的"经验"区,遗留事项进入"教训"区,下次会议的知识召回阶段按语义各取所需。
def write_minutes(results: list, pending: list) -> dict: """按三段式生成本场会议的纪要骨架。 results: 已验收子任务的(结论,依据)列表 pending: 遗留事项列表""" minutes = { "结论": [f"{r['topic']}:{r['finding']}" for r in results], "证据索引": [f"{r['topic']} 依据 {r['source']}" for r in results], "遗留事项": [f"{p['topic']}:{p['reason']}(建议下次会议处理)" for p in pending], } return minutes # 输出(节选): # write_minutes( # [{"topic": "T1", "finding": "竞品A三档价格为99/299/定制", # "source": "竞品A官网定价页快照"}, # {"topic": "T4", "finding": "竞品A基础版比我们贵23%", # "source": "统一口径折算表"}], # [{"topic": "竞品C", "reason": "手册解析超时,定价未核实"}]) # -> {'结论': ['T1:竞品A三档价格为99/299/定制', 'T4:竞品A基础版比我们贵23%'], # '证据索引': ['T1 依据 竞品A官网定价页快照', 'T4 依据 统一口径折算表'], # '遗留事项': ['竞品C:手册解析超时,定价未核实(建议下次会议处理)']}
向量检索的粒度坑
第二层记忆的检索质量取决于入库粒度。整页入库,检索命中后会把大量无关文本带上桌面;单句入库,命中碎片缺乏上下文。经验粒度是"一个论据一个块":一条结论及其直接证据切成一块入库,块内自含语境。这个粒度与纪要三段式的"证据索引"天然对齐——纪要写得越结构化,切块越省事。
⚠️ 别把原始材料直接写进长期沉淀。档案柜里放结论与教训,原始材料留在任务级向量库里。混放的结果是:下次会议召回时,一堆过期网页原文挤占桌面,真正有用的教训反而没被取出来。
跨会召回的注入位置
长期沉淀在会前注入,不是会中。OWL 六阶段流程(1.2 节)的第 2 阶段"知识召回",做的就是这件事:从档案柜里捞出与本任务相关的历史结论,注入两位核心智能体的开场上下文。注入的内容要有节制——十条历史教训里挑三条最相关的,好过十条全塞(每条都在稀释其他条的存在感)。
案例展开:第二次开会快在哪里
背景:团队按本节方法为第一次竞品调研写了三段式纪要并存档。一个月后,第二轮调研启动(范围扩大到五个竞品)。操作:会前召回阶段,系统按"竞品定价、口径折算"检索历史沉淀,取回三条结论(计费口径怎么统一、哪些竞品页有反爬、手册解析的替代路径)注入开场。结果:第二轮会议省掉了首轮三处试错——折算口径一次定对,反爬页面直接走第三方比价路径,全程轮次比首轮少四成。解读:省下来的轮次不是"模型变聪明了",而是档案柜里躺着上次的教训。变式:如果任务彼此差异大(今天调研竞品、明天写文案),长期沉淀要按任务类型打标签,召回时先过滤类型,避免"跨行业的教训串门"。
纪要的三种反模式
会写纪要之前,先认识三种最常见的不合格纪要——它们的问题都在"存进档案柜后检索不出来":
- 流水账式:按轮次逐条记录"谁说了什么",结论埋在三十条发言里。检索命中的是某句发言而非结论,召回质量低。修正:先抽结论,发言只作为证据索引的出处。
- 只记结论不记依据:十条结论光秃秃入库,事后无法判断适用条件与时效。修正:结论必须配证据索引,哪怕只是一个来源标注。
- 只记成功不记失败:档案柜里全是"做成了什么",没有"哪里卡住过"。跨会复用的价值大头恰恰在教训——反爬的坑、口径的歧义、超时的场景,都是下次省轮次的直接依据。修正:遗留事项与失败经过单独成段入库,不得省略。
用一句话概括三种反模式的共同病根:纪要的读者不是今天的人,而是下个月的检索器。按人的阅读习惯写纪要,检索器读不懂;按检索的粒度写纪要,人才真正受益。
本节要点回顾
- 桌面与档案柜分离:上下文窗口是桌面,记忆是档案柜,混用必炸;
- 三层记忆:会话史管本场,向量检索管本任务,长期沉淀管跨会,读取顺序由近及远;
- 纪要三段式:结论先行、证据索引、遗留事项,写法即检索优化;
- 入库粒度:一个论据一块,与证据索引对齐;原始材料不入长期沉淀;
- 会前注入:召回在开场做,宁精勿多;第 5 章多场会议协同将把这层记忆变成团队级资产。