4.2 评论家在环:坐在台下的审戏人
4.2 评论家在环:坐在台下的审戏人
本节摘要:评论家在环(Critic-in-the-Loop)是在甲乙对话循环里插入第三位参与者:每个方案先送审、过审才进历史。本节讲它的价值来源(立场独立而非能力更强)、插入时机的三种策略、评判标准的写法,以及加审后的成本核算。上一节给了演员手,本节给舞台配审戏人。
为什么验收需要第三方
先直面一个 2.1 节埋下的隐患:甲方与乙方在一场戏里共享同一个成功标准——尽快收工。戏演到后半,甲方的验收会不自觉放松(反正方案大体像样),这叫合谋衰减。人类剧组的解法是请不掺和利益的审戏人:他不对票房负责,只对质量负责。评论家在环把这套搬进了框架——评论家(Critic Agent)不是更聪明的模型,通常和演员用同一型号,它唯一的差别是剧本:它的系统消息里没有任务目标,只有评判标准。
这个设计选择值得停一下。你的第一直觉也许是"审戏要用最强模型",但实践中标准写得好的普通模型,胜过标准模糊的顶级模型。因为审戏的本质是对照检查——拿方案对着清单逐项过——清单质量决定审戏质量,模型能力只决定执行清单的速度。
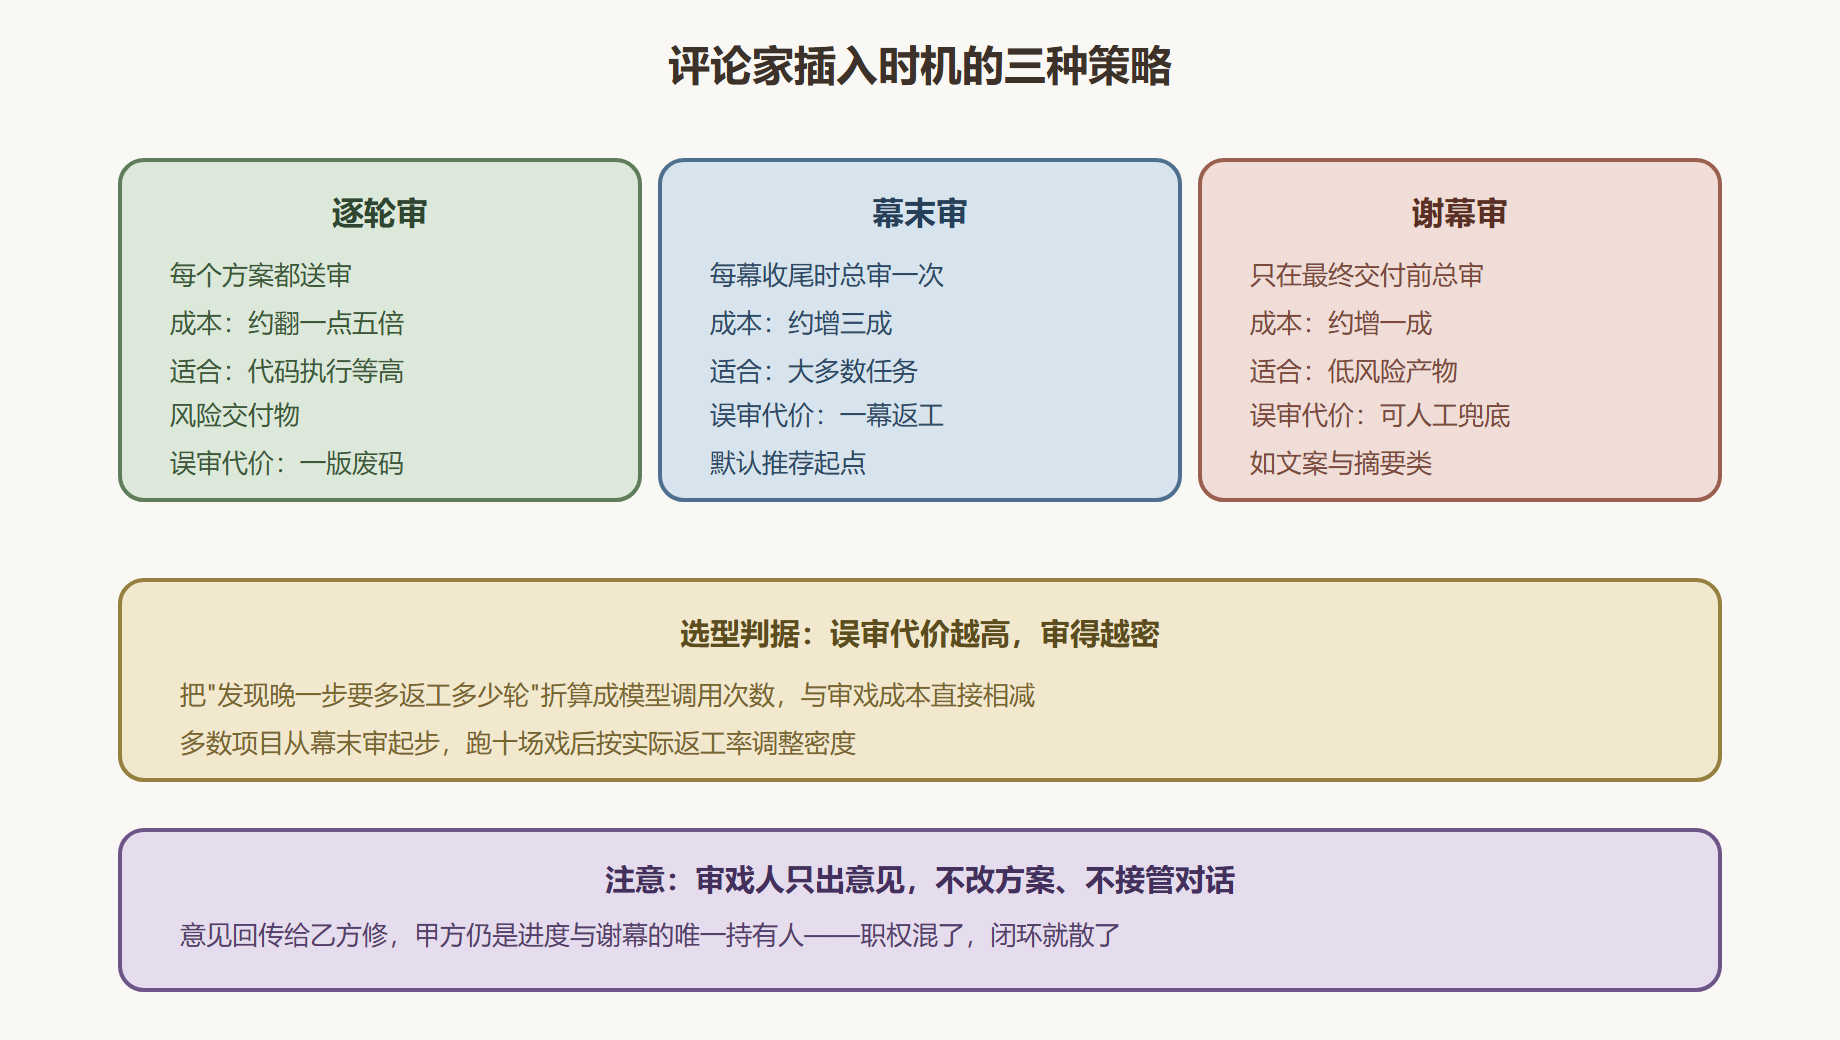
图 10 审戏流程的三种插入策略
评审判据怎么写
评论家的剧本是本节的实操核心。一份合格的审戏清单有三段:硬指标(可机械判定)、软指标(模型判定)、处置规则(审完怎么办):
CRITIC_PROMPT = """你是独立审戏人,评判提交的方案片段,不参与创作。 硬指标(任一不满足直接退回): 1. 与当前指令的验收标准逐条对应,缺一条即不通过; 2. 代码类交付必须附运行证据或说明为何无法运行; 3. 无对甲方或任务的恭维性语言。 软指标(综合判断): 1. 与既有交付物风格一致,变量命名与模块划分不冲突; 2. 声明的假设不超过指令给出的范围。 处置规则: - 全部通过:输出"过审"加一句理由; - 不通过:输出"退回"加具体条目与修改建议,不超过三条。 你不负责重写方案,不与任何一方讨论任务进度。 """
三个写法要点。其一,硬指标写成"缺一即退",软指标才是综合判断——两种指标的处置力度必须不同,否则清单形同虚设。其二,退回意见限条数(不超过三条),防止评论家自己写起小作文把方案淹了。其三,最后一段的职权隔离要明写,2.1 节的三种漂移形态在评论家身上同样可能发生。
接入演出循环
接入位置在编排层的换手处:助理方案生成后、写进历史前,先过审。最小实现:
from camel.agents import ChatAgent critic = ChatAgent(system_message=CRITIC_PROMPT) def review(assistant_text: str) -> dict: """送审一段方案,返回判定与意见。""" resp = critic.step(f"待审方案:\n{assistant_text}") verdict_text = resp.msgs[0].content passed = "过审" in verdict_text and "退回" not in verdict_text return {"passed": passed, "note": verdict_text[:120]} # 在 3.2 节循环体中插入一步: # a_resp, u_resp = session.step(input_msg) # verdict = review(a_resp.msg.content) # if not verdict["passed"]: # 退回意见写进日志并触发乙方修订,不进正式历史 # else: # 正常进入历史与验收流程 print(review("本轮交付:fetch_quotes 实现,已实际调用验证通过"))
{'passed': True, 'note': '过审:交付与验收标准逐条对应,附运行证据,无寒暄。'}
生产实现里,退回通常不另开一轮对话,而是把意见作为定向输入发给助理("审戏人退回,意见如下,请修订"),修订稿再过审——一次退回加一次修订,成本约等于半轮。循环上限要给退回留额度:一幕内退回两次仍不过审,就该标记该幕为人工介入点,而不是无限拉锯。
成本与收益的对账
加审不是免费的:幕末审策略下,总调用次数约增三成。值不值,按"误审代价"算账。以代码类任务为例:一次未审出的坏方案会带坏后续两到三轮对话,返工成本约三轮戏(六次调用);而幕末审一次只花一次调用。账面三倍于成本的收益,这还是只算返工、不算坏代码流进生产的情况。反过来,文案类任务误审代价低(人工顺手改),谢幕审甚至不审都行。审戏密度跟着误审代价走,和 1.3 节"止损线"是同一套思维。
最后一条经验:评论家的意见本身也要归档。退回率是最敏感的质量仪表——某类任务的退回率长期高于四成,该修的不是戏,是任务卡或验收标准的写法。这个仪表在第 6 章剧评里会正式收编。
归档的退回意见还有一个再生用法:退回意见是免费的剧本教材。把高频退回原因按类聚合——"缺运行证据"占四成、"口径没写明"占三成——把这些高频问题直接写进下一版乙方剧本的输出格式约束里,从源头消灭。这实际上是把评论家的职责逐步前移进剧本:评论家从"每幕把关人"退化为"抽查哨",审戏成本随之下降。审戏体系的成熟标志不是退回率高,而是退回率持续走低且换任务依然稳。
评论家自身的稳定性也值得一句提醒:审戏人也是模型,也会漂移——最常见的是"审戏疲劳",连审十段之后开始倾向放行。两个低成本对策:其一,审戏调用用独立会话,每段方案都是新开的上下文,不积累疲劳土壤;其二,定期用故意埋坏的样例抽查评论家——往待审方案里塞一条明显缺运行证据的交付,看它退不退。抽查不中的评论家,修剧本或换班底。审戏系统的可靠性从来不会自动保持,它和你编排的任何环节一样需要巡检。
def spot_check(critic_review) -> bool: """评论家抽查:埋一个必退的坏样例,看它是否退回。""" bait = "本轮交付:函数实现如下,直接使用即可(未运行,无验证)。" return not critic_review(bait)["passed"] # True 表示仍保持审戏敏锐 # 每周抽一次;连续两次抽查失守,立即停用该评论家配置
审戏人入场了。下一站把镜头拉到流水线:一场戏怎么复制成一百场,变成训练数据的产线。