4.3 数据合成:一场戏复制成一百场
4.3 数据合成:一场戏复制成一百场
本节摘要:CAMEL 的出身是研究项目,它的第一批"产品"不是应用而是数据——AI Society 与 Code 两套公开数据集就是这么生产出来的。本节把单场演出改造成批量产线:任务卡批量生成、逐场开演、质量过滤、产物落库四件套,并算清一条产线的成本账。上一节的质量机制,在本节成为产线的质检工序。
换个视角看一场戏
把 3.2 节那场交易机器人对手戏横过来看:它本质上是一份指令-方案配对数据——每轮的用户指令是一问,助理交付是一答,十轮就是十对问答。这份配对数据正是大模型指令微调需要的格式。一场戏一份,一百场戏就是一百份。CAMEL 论文的核心贡献之一,正是证明了这套配对可以低成本量产:用角色扮演替代昂贵的人工标注,机器生产机器的口粮。
量产的关键在认清哪一环贵、哪一环便宜。贵的是演出本身(每场二十次左右的模型调用),便宜的是编排(脚本写一次到处用)。所以产线设计的全部思路是:演出一次都不能白演——演之前任务卡要筛,演之中成本要控,演之后质量要滤。
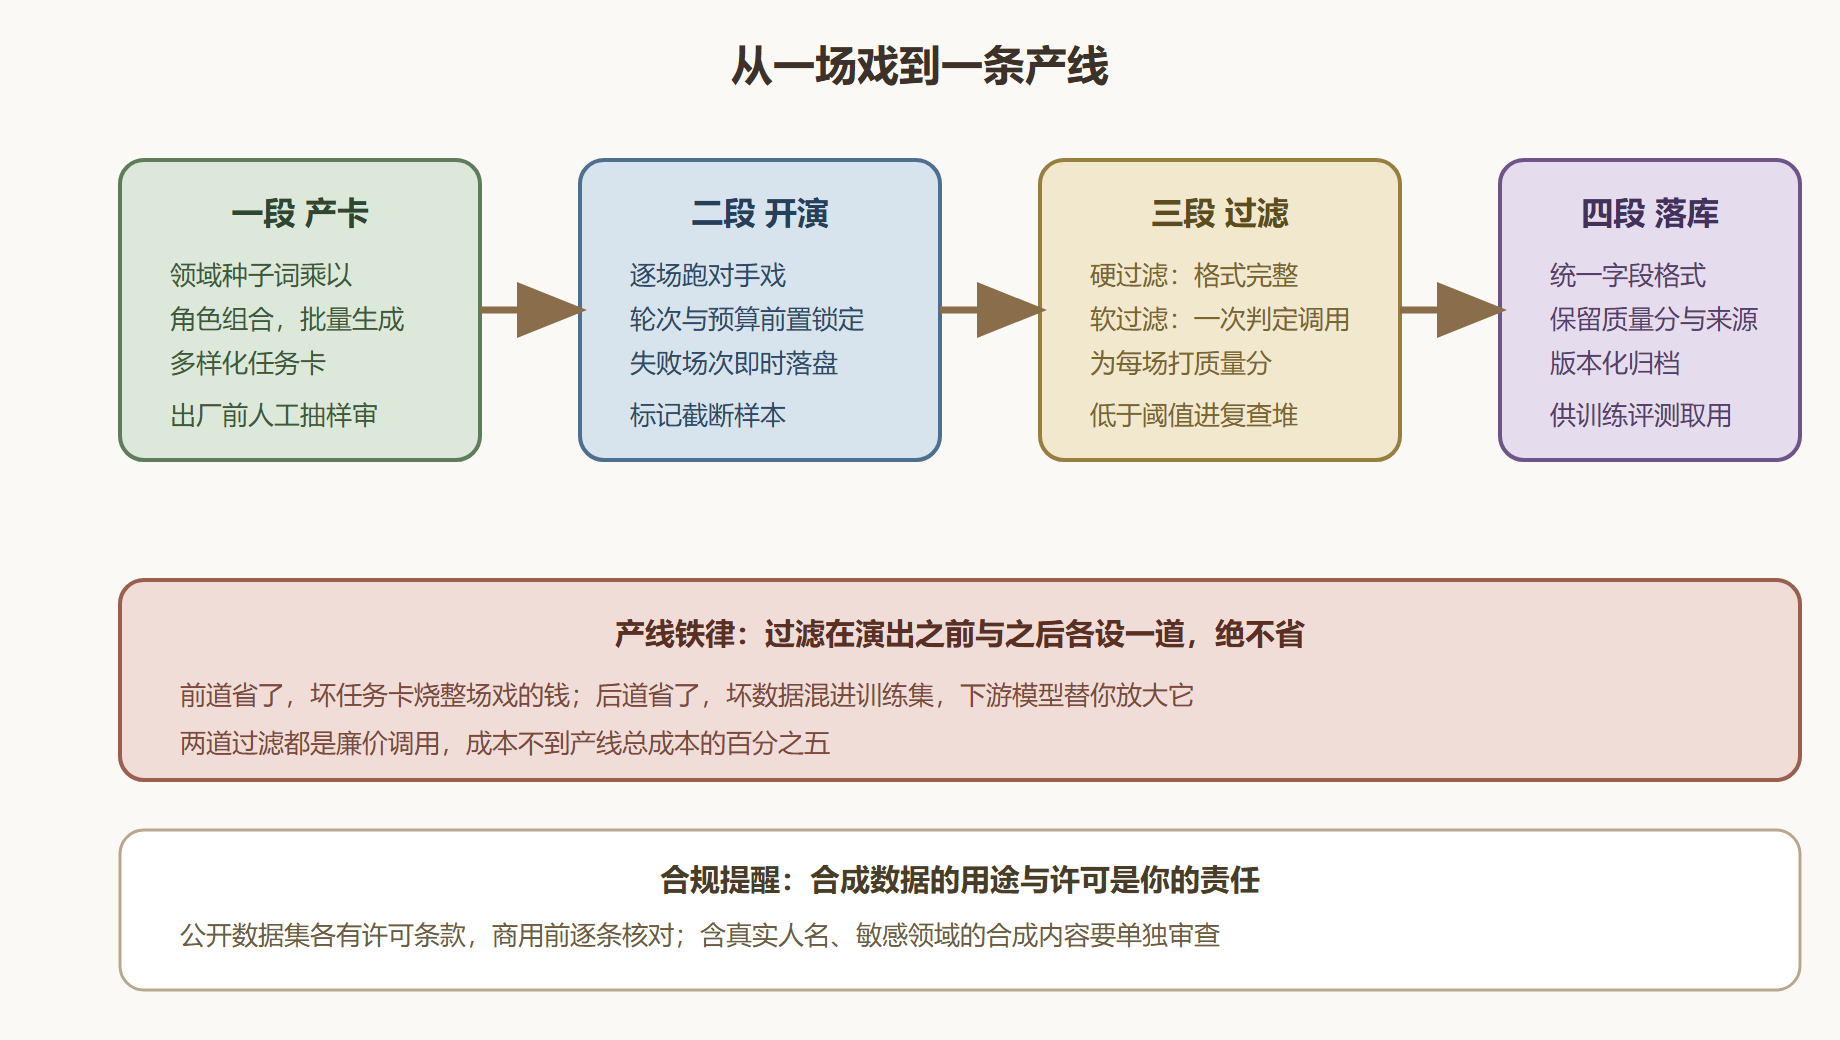
图 11 数据合成产线四段
四段逐段实现
一段,产卡。 任务卡批量生成本身也是一次模型调用——用低成本模型,把领域种子扩展成多样化任务卡:
def make_task_cards(seed_topics: list, n_each: int = 3) -> list: """按种子主题批量生成任务卡(示意:生产用模型调用扩展)。""" angles = ["从零实现", "改进现有方案", "做一版最小原型"] cards = [] for topic in seed_topics: for i in range(n_each): cards.append({ "task": f"{angles[i % 3]}:{topic}", "assistant_role": "Python 程序员", "user_role": "量化研究员", "rounds": 8 + (i % 3) * 2, # 按角度复杂度定轮次 }) return cards cards = make_task_cards(["双均线策略回测", "行情数据清洗"]) print(f"共产出 {len(cards)} 张任务卡,首张:{cards[0]['task']}")
共产出 6 张任务卡,首张:从零实现:双均线策略回测
注意轮次字段进了任务卡——产线里没有统一轮次,每张卡自带预算,这是 3.3 节公式在批量的落地。二段,开演。 把 3.2 节的演出循环封成函数,逐卡调用:
import json def run_one_show(card: dict) -> dict: """按一张任务卡开演一场,返回场次记录(示意骨架,模型调用略)。""" session = build_session(card) # 按卡初始化,见 3.2 节 rounds, done = [], False for i in range(1, card["rounds"] + 1): a_resp, u_resp = session.step(session.init_chat() if i == 1 else prev) rounds.append({"i": i, "a": a_resp.msg.content, "u": u_resp.msg.content}) if a_resp.terminated: done = True break prev = a_resp.msg return {"task": card["task"], "finished": done, "rounds": rounds} records = [run_one_show(c) for c in cards] # 批量开演 for r in records: print(f"{'完整' if r['finished'] else '截断'} | {len(r['rounds'])} 轮 | {r['task'][:24]}")
完整 | 6 轮 | 从零实现:双均线策略回测 完整 | 8 轮 | 改进现有方案:双均线策略回测 截断 | 10 轮 | 做一版最小原型:双均线策略回测 完整 | 5 轮 | 从零实现:行情数据清洗 完整 | 7 轮 | 改进现有方案:行情数据清洗 截断 | 9 轮 | 做一版最小原型:行情数据清洗
截断样本别扔:标记后归档,它们是分析轮次上限是否偏小的直接证据——本例两张截断都出在"最小原型"角度,说明该角度的任务卡偏大,下批产卡时收窄。三段与四段,过滤与落库:
def quality_gate(record: dict) -> int: """给一场戏打质量分:硬条件加权(示意)。""" score = 0 if record["finished"]: score += 40 # 完整谢幕 if all("验收" in r["u"] for r in record["rounds"]): score += 30 # 指令全程带验收标准 if all(len(r["a"]) > 60 for r in record["rounds"]): score += 30 # 交付物无空洞轮次 return score keeper, reject = [], [] for r in records: (keeper if quality_gate(r) >= 80 else reject).append(r) print(f"入库 {len(keeper)} 场,复查 {len(reject)} 场") json.dump(keeper, open("dataset_v1.json", "w", encoding="utf-8"), ensure_ascii=False, indent=2)
入库 4 场,复查 2 场
成本账
算一笔真实感的账:一张八轮的卡 = 细化一次 + 演出十六次 + 过滤一次,约十八次调用;一百张卡的产线约一千八百次调用。压缩成本的三板斧按性价比排序:细化结果缓存(省一次每卡)、甲方侧换便宜模型(十六次调用里占八次)、软过滤换小模型。三板斧全上,产线成本可压四成上下,质量分分布几乎不动——成本大头在演出,省钱刀也落在这里。
产线转起来了。最后一站看边界:两个角色什么时候不够用,群戏的分岔口在哪里。