4.4 从对手戏到群戏:规模化与OWL
4.4 从对手戏到群戏:规模化与OWL
本节摘要:两个角色什么时候不够用?本节给出扩编的触发判据,算清从对手戏到群戏要重估的三笔账——协调成本、错误传播、可观测性——并介绍 CAMEL 生态里两条扩编路线:多场并行(横向)与角色扩编(纵向),最后定位 OWL 与 Workforce 在生态里的位置。本章收束,也是全册"角色扮演机制"视角的边界勘定。
扩编的触发判据
先立判据再谈架构。遇到一个新需求,出现以下任一信号,才考虑请更多角色上台:信号一,职责真实异质——任务天然需要三种以上互不兼容的专长(比如"写代码、审法务、管预算"),硬塞进两个角色会让某个演员精神分裂。信号二,流程需要仲裁——甲乙之外存在规则裁决需求(合规、安全),评论家的临时客串已经不够。信号三,产物链并行——任务可拆成多条互不依赖的工作线,串行演出纯属浪费时间。
三个信号一个都不满足时,答案是把现有对手戏做得更好:修剧本、配工具、加审戏。这个判断很反直觉但重要——扩编是多智能体系统里最容易被滥用的动作,因为"多来几个角色"听起来总像是解法。
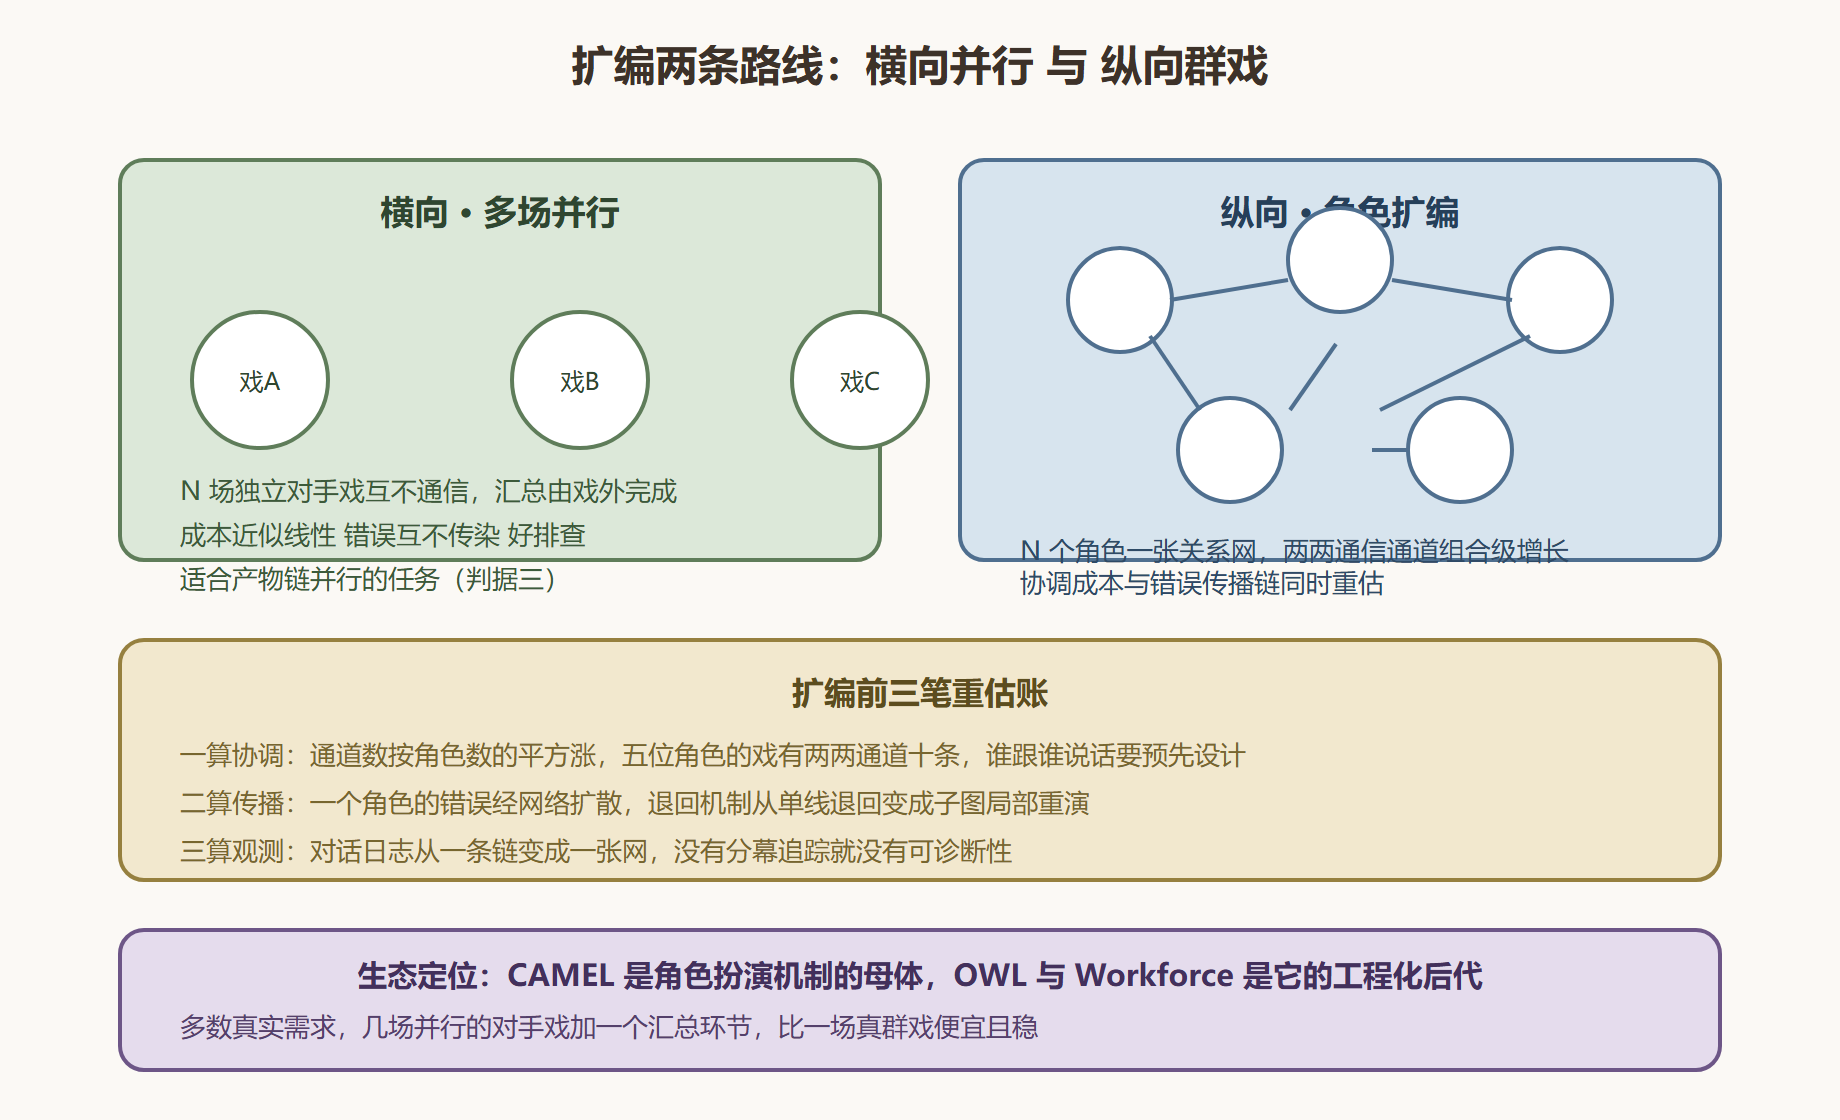
图 12 两条扩编路线的形状对比
三笔账算给一个真实需求看
拿需求走一遍账:"同时调研三个竞品的公开资料并汇总成报告"。它满足判据三(三条工作线并行),不满足判据一(同一专长:资料搜集)。裁决:横向并行——三场独立的调研对手戏,各演各的,产出三份子报告,最后用一次普通模型调用(或第四场小戏)做汇总。对比真群戏方案(一个调研团:五角色、一张通信网):前者三十到四十次调用、日志三条链、失败重演单场;后者协调提示的编写就要一天,通道网里一个角色的档案污染会传染全场。
这笔账可以程序化,把两种方案的调用数与故障半径写成粗估函数:
def scale_compare(parallel_shows: int, roles_per_show: int, ensemble_roles: int) -> dict: """横向并行与纵向群戏的成本与故障半径粗估。""" # 横向:每场两侧轮流调用,加一次汇总 duo_calls = parallel_shows * roles_per_show * 2 + 1 # 纵向:两两通道按组合数计,每通道按两次调用粗估 channels = ensemble_roles * (ensemble_roles - 1) // 2 ensemble_calls = channels * 2 + ensemble_roles return {"横向调用数": duo_calls, "横向故障半径": "单场", "纵向调用数": ensemble_calls, "纵向故障半径": "全网络"} print(scale_compare(parallel_shows=3, roles_per_show=2, ensemble_roles=5))
{'横向调用数': 13, '横向故障半径': '单场', '纵向调用数': 45, '纵向故障半径': '全网络'}
三个角色各派两个演员的横向方案,调用数不到五人团群戏的三分之一,故障半径还小一号。数字不总是这么悬殊——角色更多、场次更少时差距会收窄——但方向稳定:连通度是成本与风险共同的放大器。
再看一个反例:"开发一个含前端、后端、合规审查的金融工具"。判据一命中(专长异质),判据二命中(合规仲裁)。纵向扩编合理,但正确姿势仍不是一步到位的全连接群戏——按依赖分层扩:前端戏、后端戏各自是小型对手戏,合规作为评论家横插两线之间,总体是一张浅层网络而不是网状团。扩编的艺术在控制连通度,不在堆角色数。
横向并行的最小实现
既然横向并行是多数需求的正解,给一个可抄的最小骨架。要点是三件套:分片器把总任务切成互不依赖的子任务、执行器逐场开演、汇总器收拢产物。汇总不用群戏——一次普通模型调用足够:
def parallel_duo(master_task: str, splits: list, build, run_one) -> dict: """横向并行骨架:分片、逐场对手戏、汇总。build 与 run_one 为注入的 会话构造器与演出函数(复用 3.2 与 5.1 的实现)。""" results = [] for sub in splits: session = build(master_task=master_task, sub_task=sub) results.append({"sub": sub, "output": run_one(session)}) merge_input = "\n".join(f"分片{r['sub']}结论:{r['output']}" for r in results) merged = run_one(build(master_task=master_task, sub_task=f"汇总以下结论:{merge_input}")) return {"pieces": results, "merged": merged} plan = {"master_task": "三款竞品调研", "splits": ["竞品甲", "竞品乙", "竞品丙"]} for s in plan["splits"]: print(f"排片:{s} —— 独立场次,互不通信") print("收口:一次汇总调用,产物合并归档")
排片:竞品甲 —— 独立场次,互不通信 排片:竞品乙 —— 独立场次,互不通信 排片:竞品丙 —— 独立场次,互不通信 收口:一次汇总调用,产物合并归档
骨架里最值得咀嚼的是最后一行:汇总环节被刻意排除在角色扮演之外。多数人到这里会本能地想设计一场"圆桌群戏"来收口,但分片结论的合并是确定性加工——一次调用即可,且可测试、可重放。群戏该不该上,这个选择本身就是 4.4 节的全部精神。
CAMEL 生态的扩编答案
框架层面对两条路线各有承接。横向并行本质是 4.3 节产线的变体:产线批量跑的是不同任务卡,这里批量跑的是同主题不同分片,编排代码几乎原样复用。纵向扩编在生态里的代表是 Workforce(工作队):一个带协调者的角色编队,任务在队员之间按依赖分派,失败有内部重试;它把"谁跟谁说话"从提示工程变成了配置工程。而 OWL 框架走得更远——它以 CAMEL 为底座,把多方协作做成完整的任务执行系统,工具生态与角色编排都有工程化封装。
三者的关系可以这样记:CAMEL 给了"两个角色怎么演对手戏"的机制与数据,Workforce 把它扩成编队,OWL 把它扩成全套班子。本册到此为止教的是母体机制——这恰好是最值得吃透的一层:群戏框架的每一步分派,底层跑的仍是一场场角色扮演。
给纵向扩编留一个最小观察哨:如果未来真的上了编队型框架,6.1 节的四指标看板要加第五个维度——消息网密度(实际发生的通信对数 除以 可能的通信对数)。密度长期贴着上限跑,说明协调提示没有起到分派作用,角色在互相客串;健康的编队通常远低于上限。这个哨兵现在就能埋:编排层每走一步记一次"谁对谁",批次结束聚合即可。
对手戏的边界勘完了:能单演的别扩编,该扩编的控连通。第 5 章进保留剧目库,看四个完整案例怎么把全册机制拧成成品。