5.3 AI Code:需求方与开发者的双人排练
5.3 AI Code:需求方与开发者的双人排练
本节摘要:AI Code 是把双角色对话用在编程场景的剧目:需求方角色与开发者角色结对,把一个功能从接口设计推进到测试通过。本节按五段复盘一场"写一个 Markdown 表格统计工具"的排练,重点展示函数级拆幕与机器可查的验收断言——编程场景是双智能体编排里验收链最硬的场地。
背景:编程戏的特殊性
同样是双角色,编程戏与方案戏有一个结构差异:代码可以被机器裁决。函数跑不跑得通、测试过不过,不需要任何主观判断。这让编程场景成为双智能体机制价值密度最高的场地——验收线可以画得极硬,评论家可以由测试框架兼任,具身工具的执行器是天然主角。CAMEL 生态的 Code 数据集正是用这套机制量产的:配对的指令与代码,每段代码都过了可运行性这道闸。
本剧目的任务卡:写一个 Markdown 表格统计工具——输入表格文本,输出行数、列数、每列类型。体量适中,正好演示"接口、实现、测试"三幕的标准刀法。
编排:拆到函数级的幕次表
编程戏的拆幕粒度比方案戏细一档:幕下直接对齐函数。本剧目的幕次表:
CODE_PLAYBILL = { "task": "编写一个 Markdown 表格统计工具,输入表格文本,输出统计信息", "assistant_role": "Python 开发者,只交付代码,不描述计划", "user_role": "产品需求方,用接口与测试用例说话,不写实现", "acts": [ # 每幕:函数名 + 机器可查的验收断言 {"name": "解析幕", "unit": "parse_table", "assert": "给定样例输入返回 3 行 4 列"}, {"name": "类型幕", "unit": "infer_column_types", "assert": "样例数据推断为 文本 数值 数值 日期"}, {"name": "汇总幕", "unit": "summarize", "assert": "输出字典含 rows cols types 三键"}, {"name": "测试幕", "unit": "test_suite", "assert": "全部用例通过且含边界用例"}, ], "tools": ["代码执行"], # 每幕交付必须附执行证据 "rounds": 12, # 四幕,幕均两到三轮 } for act in CODE_PLAYBILL["acts"]: print(f"{act['name']} -> {act['unit']} : {act['assert']}")
解析幕 -> parse_table : 给定样例输入返回 3 行 4 列 类型幕 -> infer_column_types : 样例数据推断为 文本 数值 数值 日期 汇总幕 -> summarize : 输出字典含 rows cols types 三键 测试幕 -> test_suite : 全部用例通过且含边界用例
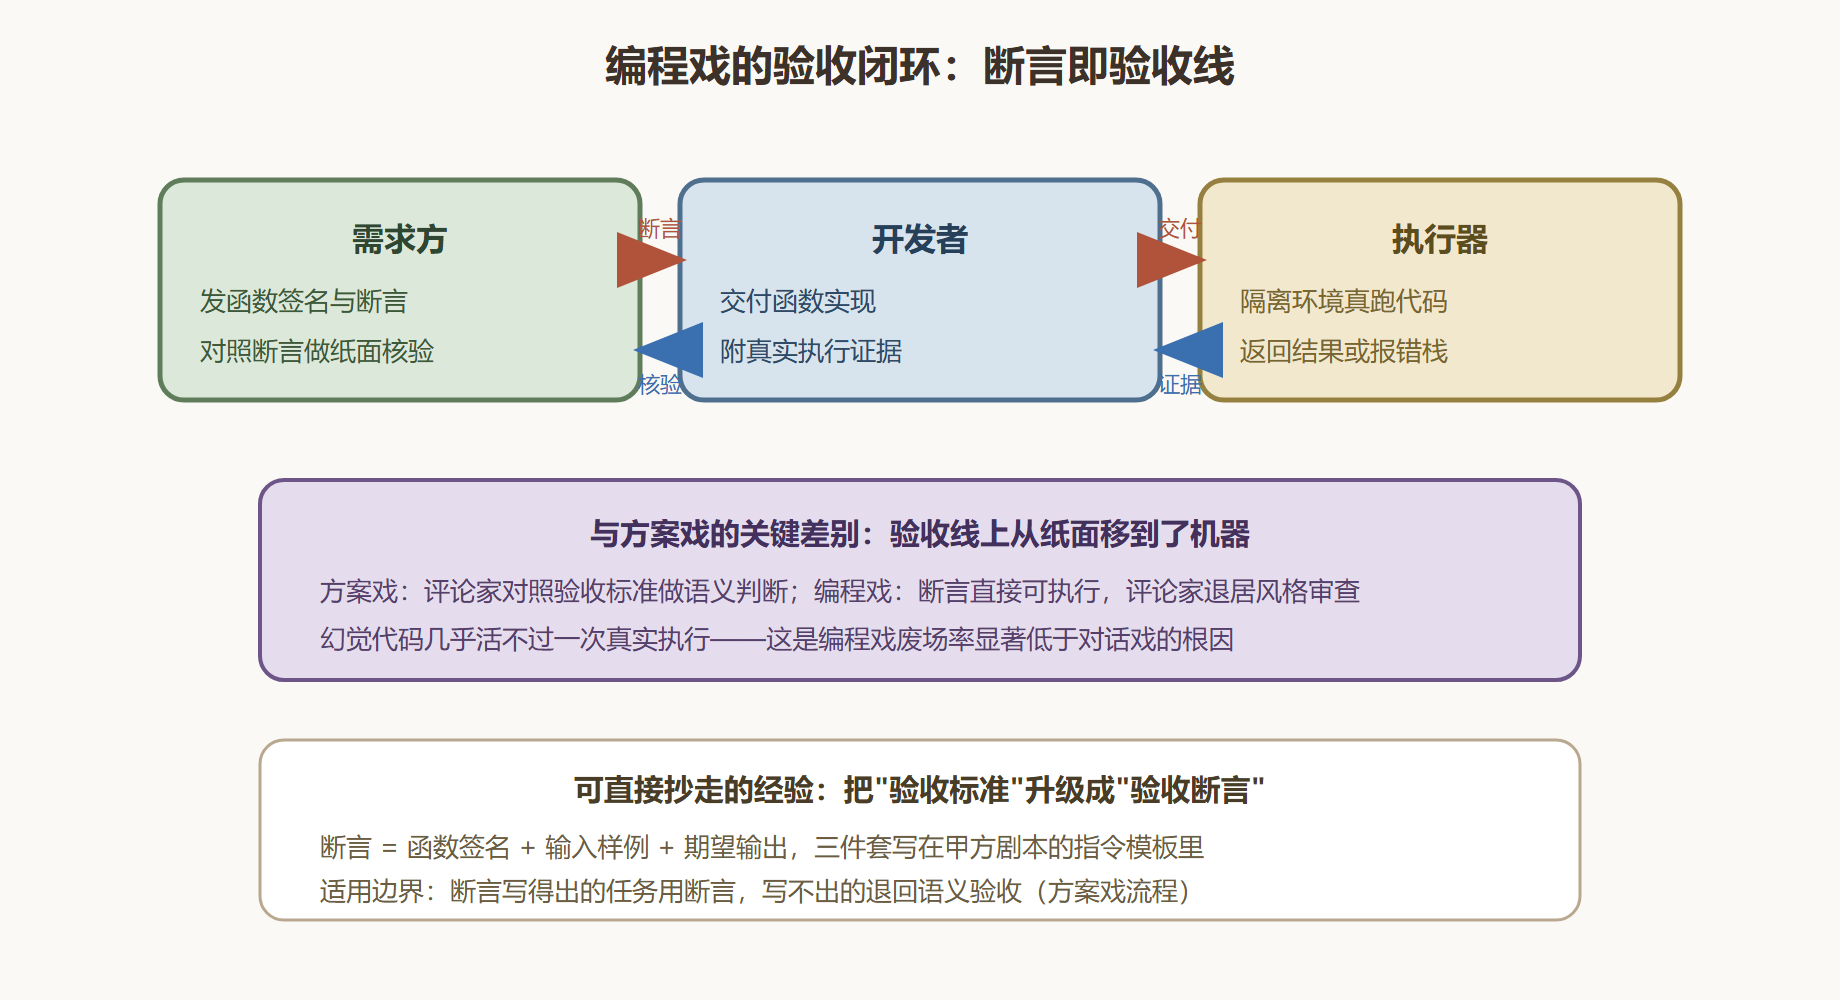
三个编排要点。其一,甲方角色定义为"用接口与测试用例说话"——需求方不发散文式指令,每条指令是函数签名加断言,指令本身就是可执行规格。其二,验收断言写进幕次表,评论家审交付时对照的是断言而非感觉。其三,执行工具全场常驻,每幕交付必须带运行证据——4.1 节"行头按幕配"在这里简化成了"一路带到底",因为编程戏每一幕都在碰代码。
图 15 编程排练的验收闭环
演出:一幕的完整实录
取解析幕的第 1 至 2 轮实录,看断言怎么在两侧流转:
第 1 轮 [需求方] 指令:实现 parse_table(text),输入 Markdown 表格文本, 返回二维列表(去掉分隔行)。断言:parse_table(SAMPLE) 应返回 3 行 4 列的列表,SAMPLE 如附录。 第 1 轮 [开发者] 本轮交付:parse_table 实现如下,逐行按竖线切分并剔除 空段与分隔行。执行证据:parse_table(SAMPLE) 返回长度 3 的列表, 每行 4 元素,与断言一致。 第 2 轮 [需求方] 指令:验收通过。下一幕:实现 infer_column_types, 断言:对 SAMPLE 推断结果为 文本 数值 数值 日期。
注意开发者的交付模板里"执行证据"成为固定字段——这不是模型自觉,是 2.2 节剧本模板明文规定的输出格式。测试幕收尾时,测试套件本身也作为交付物过审,边界用例(空表格、单列表格、列数不齐)是评论家的必查项。
结果、解读与变式
结果:四个函数加一个测试套件,全部带执行证据归档,十二轮收场,成本约二十八次调用。解读关键在废场率:编程排练的废场率通常显著低于对话戏——断言验收把"看起来对"的方案拦在了幕内,问题代码没有机会传染。这印证了图 15 的判断:验收线越硬,漂移越无处藏身。
这套剧目还有一个常被忽略的衍生价值:排练记录本身就是需求文档。十二轮对话按时间顺序读下来,就是一份带验收口径的开发过程档案——每个函数为什么这样设计、边界用例怎么定的、口径在哪里改过,全在日志里。团队新成员接手维护时,读一遍排练日志比读三遍代码更快建立上下文。把"归档产物"从代码扩展到"代码加排练日志",是这个剧目最划算的一笔附加收益,成本为零——日志本来就在落盘。
顺手把日志转成结构化档案,检索效率再上一档:
def code_archive(log: list, project: str) -> dict: """把排练日志转成按函数索引的结构化档案。""" archive = {"project": project, "functions": {}} current = None for r in log: if "实现" in r["user"] or "下一幕" in r["user"]: current = r["user"].split("实现")[-1].split(",")[0].strip() or current if current: archive["functions"].setdefault(current, []).append(r["i"]) return archive demo_log = [{"i": 1, "user": "指令:实现 parse_table,断言:3 行 4 列", "assistant": "本轮交付:parse_table 实现"}, {"i": 2, "user": "指令:验收通过。下一幕:实现 infer_column_types", "assistant": "本轮交付:infer_column_types 实现"}] print(code_archive(demo_log, project="表格统计工具"))
{'project': '表格统计工具', 'functions': {'parse_table': [1], 'infer_column_types': [1, 2]}}
变式一,断言升级为真实测试框架:让测试幕产出标准测试代码并真实运行,验收从断言比对升级为测试套件通过率。变式二,加修复幕:故意在剧本里删掉"边界用例"要求,观察测试幕能否自行发现并退回——训练自己识别验收缺口。变式三,反向排练:交换两侧角色,让开发者提需求、需求方写代码,作为对照实验检验角色设定的作用——多数情况你会看到明显的质量下降,这本身就是 2.1 节机制论的最好证明。
编程排练落幕。最后一台戏走出单框架:CAMEL 与 LangChain 同台,看跨框架协作怎么在消息层握手。