5.2 AI Society:多台同演的角色实验
5.2 AI Society:多台同演的角色实验
本节摘要:AI Society 是 CAMEL 最出名的用法:用几十组职业角色组合批量开演任务型对话,产出群体数据集。本节按五段复盘一次缩小版实验——角色矩阵怎么设计、任务卡怎么配对、质量分布怎么解读——并给出把这套方法用到自己领域的改造点。数据合成是 4.3 节的产线,本节是产线的一次正式投产。
背景:一群角色在研究什么
AI Society 的原始动机是个研究问题:角色扮演式对话能否持续产出有信息增量的内容。CAMEL 团队设计了大量"职业甲 × 职业乙 × 任务"的组合——比如"心理学家 × 项目经理 × 设计一款时间管理应用"——批量跑双角色会话,产出数万段对话,公开成数据集。它证明了框架的量产能力,也暴露了量产的规律:大约八成对话质量可用,两成会在中途漂移或循环。本节带你跑一次缩小版(二十场),亲眼看这条分布。
编排:角色矩阵是设计核心
单场戏的主角是剧本,量产戏的主角是矩阵——哪些角色组合、配什么任务。矩阵设计三原则:角色异质(两个职业专长差距大,对话信息增量才足)、任务共栖(任务必须让两个职业都有话可说)、轮次分级(按任务体量定轮次,别一刀切):
def build_matrix(professions: list, tasks: list) -> list: """职业两两配对,每对配一条任务,生成场次清单。""" shows = [] for i, a in enumerate(professions): for b in professions[i+1:]: task = tasks[len(shows) % len(tasks)] shows.append({ "user_role": a, # 甲方职业 "assistant_role": b, # 乙方职业 "task": f"协作推进:{task}", "rounds": 8, # 群像实验统一小轮次控成本 }) return shows professions = ["心理学家", "产品经理", "数据分析师", "科幻作家"] tasks = ["设计一款提升专注力的应用", "为远程团队设计协作仪式"] matrix = build_matrix(professions, tasks) print(f"共 {len(matrix)} 场,示例:{matrix[0]['user_role']} 对 {matrix[0]['assistant_role']}") print(f"任务:{matrix[0]['task']}")
共 6 场,示例:心理学家 对 产品经理 任务:协作推进:设计一款提升专注力的应用
注意这场实验里没有技术类交付物——AI Society 的产物是对话数据本身,所以不需要具身工具,也不需要幕末审(误审代价低),成本结构比股票剧目轻得多。这是矩阵设计第一课:产物形态决定机制配置。
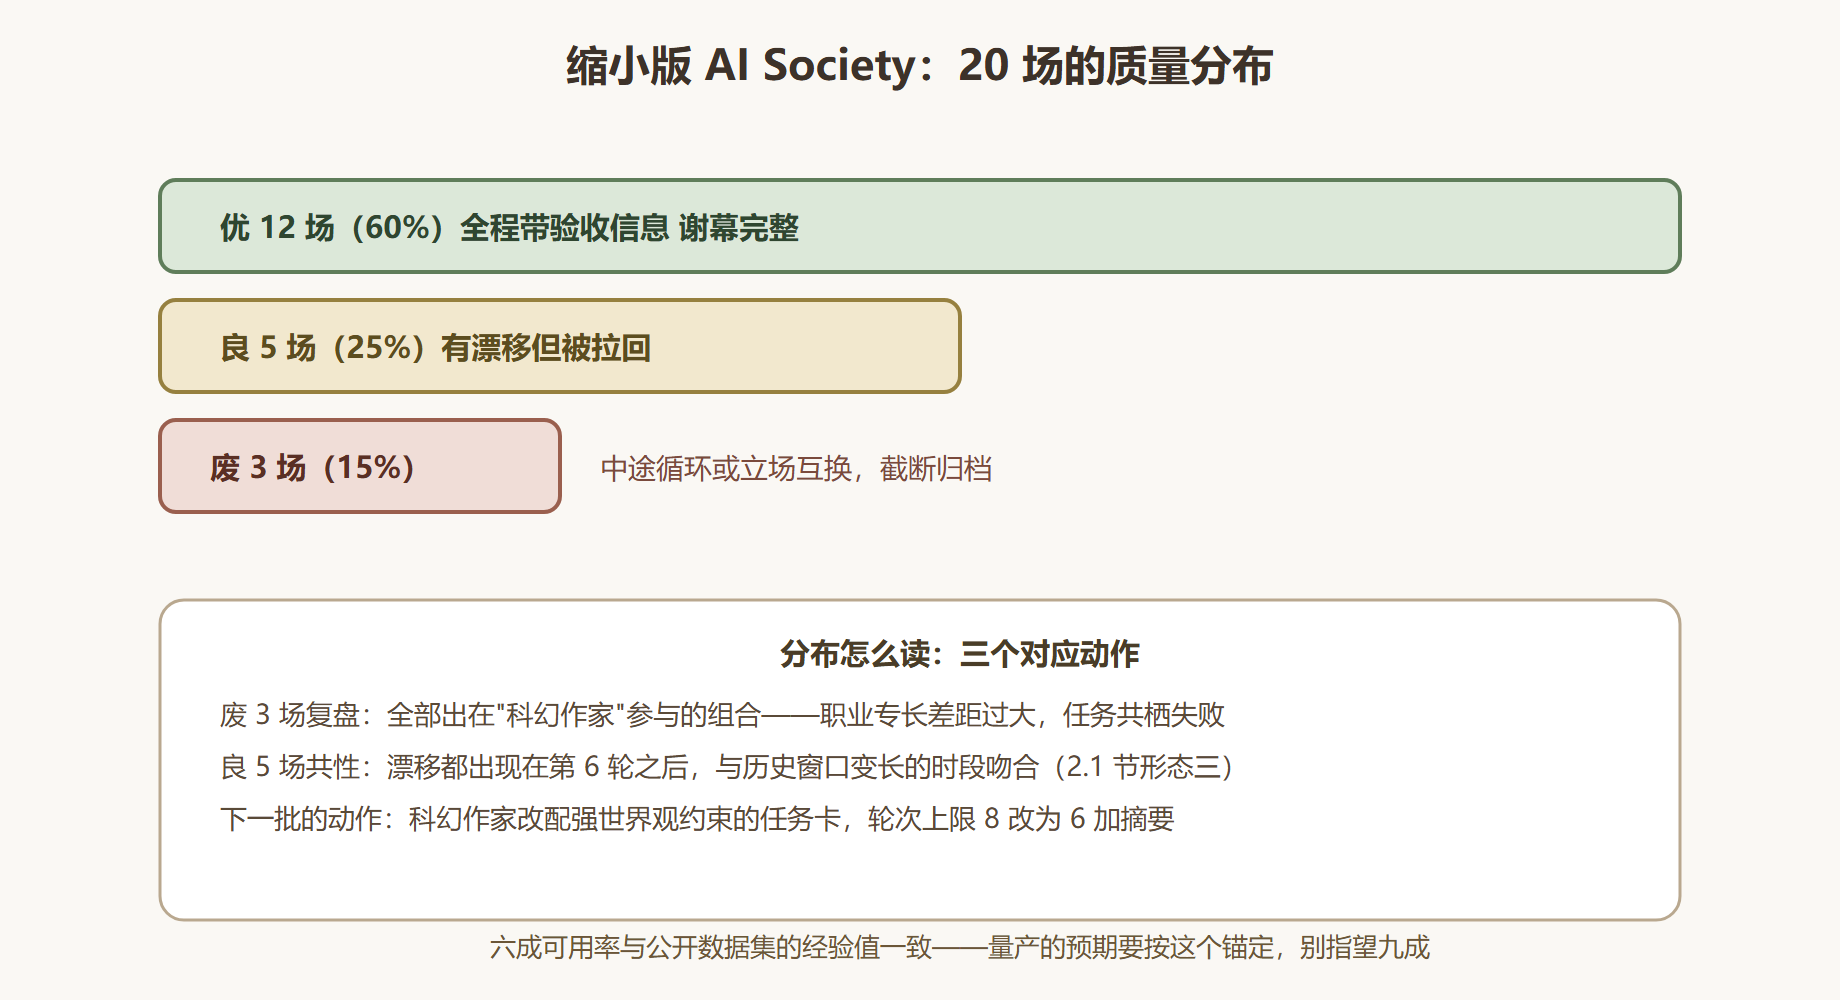
图 14 二十场实验的质量分布
演出与结果
批量演出直接复用 4.3 节的产线函数,二十场顺序跑(有并发额度就并行)。结果按质量分三档:优、良、废。上图给出了分布与解读,三个数字值得记:六成优、两成半良、一成半废——这组比例与公开数据集的构建经验一致,是你未来设计产线的预期锚点。废场次的价值不在数据,在归因:三次废场全部指向矩阵设计的同一处缺陷(职业专长差距过大导致任务共栖失败),修复动作回到矩阵层而不是提示层。
把归因写成自动化复盘,每批跑完即出:
def batch_postmortem(records: list) -> dict: """按角色组合统计废场率,产出下一批矩阵的修正建议。""" import collections stats = collections.defaultdict(lambda: [0, 0]) # 角色: [废场数, 总场数] for r in records: for role in (r["user_role"], r["assistant_role"]): stats[role][1] += 1 if not r["finished"]: stats[role][0] += 1 report = {} for role, (bad, total) in stats.items(): rate = bad / total if total else 0 report[role] = f"废场率 {rate:.0%}" + (",建议收紧任务共栖" if rate > 0.3 else "") return report print(batch_postmortem(batch_records))
{'心理学家': '废场率 0%', '产品经理': '废场率 0%', '数据分析师': '废场率 0%', '科幻作家': '废场率 50%,建议收紧任务共栖'}
各角色废场率一目了然:参与场次越多的角色权重越大,超阈值者进下一批矩阵的修正清单。
解读与变式
本剧目最想让你带走的判断有三条。第一,群像实验是矩阵的艺术:单场戏拼剧本,批量戏拼配对——职业差距、任务共栖、轮次分级三个旋钮都在矩阵层,不在提示层。第二,分布比均值重要:六成可用率听着不高,但它带给你的是可预测的产能规划——要一千段优等数据,排一千七百场。第三,废场归因要回到设计层:把废场当提示问题去修剧本,会陷入无穷调参;回到矩阵层改一次配对,废场率直接减半。
变式一,自己领域的矩阵:把职业表换成你领域的专家角色(比如"营养师 × 健身教练"),任务卡换成领域选题,一套代码不用改。变式二,梯度实验:固定角色对,只动温度,看质量分布怎么移——这是你自己的消融实验。变式三,接评论家:给废场率高的组合加谢幕审,对比成本与回收率,亲手验证 4.2 节的账。
补一句数据合规的提醒再收尾。批量生产的对话数据里,角色是虚构的,但内容可能触碰真实边界——医疗建议、法律解释、投资判断这类话题,合成数据即便用于内部评测,也应标注"非专业意见"字段;涉及真人姓名、真实公司评价的内容要在过滤段单独设关键词闸。产线的第三段(过滤)因此永远保留一个人工抽查位,比例不必高,抽样方向要有意偏向这些敏感桶。
群像实验落幕。下一台戏收窄镜头:只有两个人的编程排练,看任务怎么拆到函数级。