6.1 剧评环节:评估与性能
6.1 剧评环节:评估与性能
本节摘要:本节为双智能体演出建立四指标评估体系:任务完成率、轮次效率、单位成本、漂移率。每个指标给出定义、日志计算方法与合格线参考,最后拼成一张评估看板。第 5 章的四场演出是本节的评分对象——评估体系的第一次实战,就打在自己身上。
从老板那一问说起
"怎么证明它更好?"拆开看,这个问题在问四件事:成了没有(完成率)、演得拖不拖(轮次效率)、贵不贵(单位成本)、稳不稳(漂移率)。四件事对应四个指标,全部可以从你已经落盘的演出日志里算出——这是把 3.2 节"日志当数据"的习惯兑现成体系的时刻。
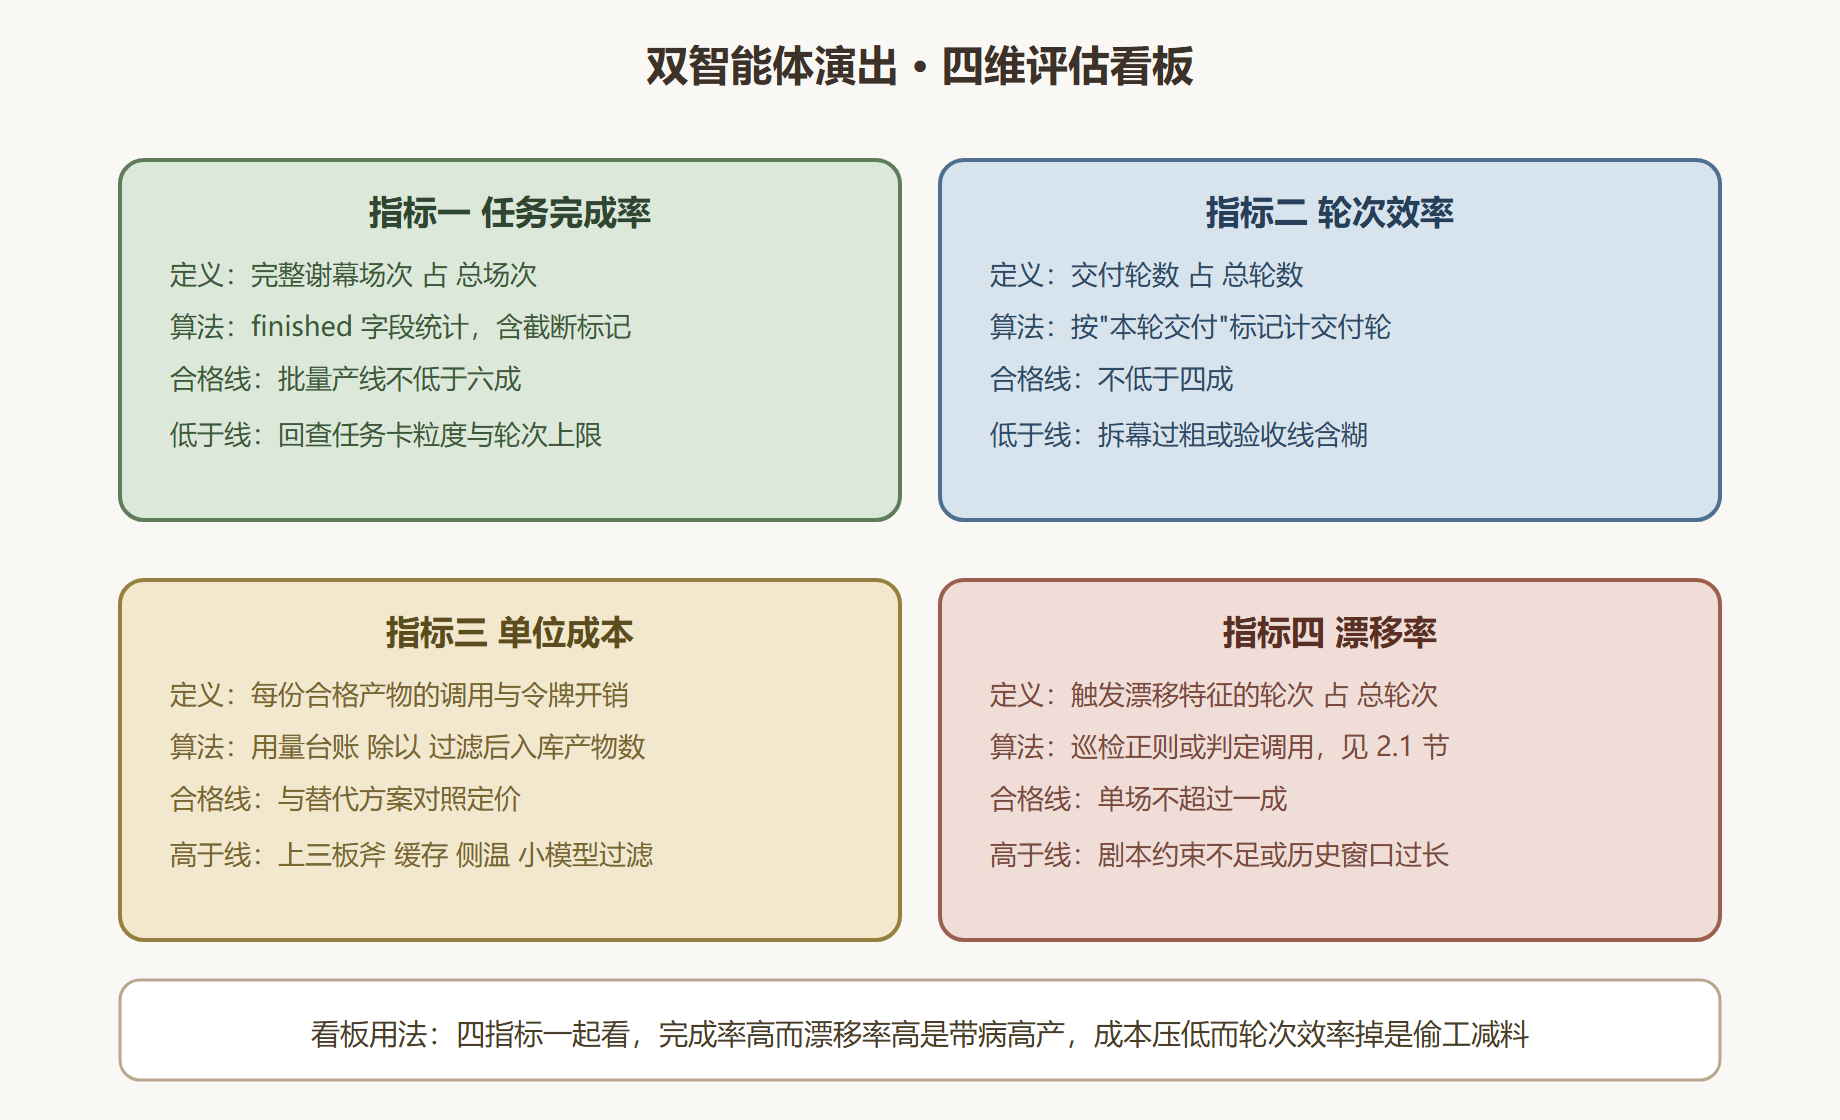
先看四个指标的定义与合格线参考:
图 16 四维评估看板
四个指标逐个算
全部计算基于 3.2 节的落盘日志,代码一次写好反复用:
import json def evaluate(path: str) -> dict: """从单场演出日志计算四指标(漂移率用简化正则)。""" import re log = json.load(open(path, encoding="utf-8")) total_rounds = len(log) finished = log and ("CAMEL_TASK_DONE" in log[-1]["user"] or log[-1].get("terminated", False)) # 轮次效率:带"本轮交付"标记的助理轮 delivery_rounds = sum(1 for r in log if r["assistant"].startswith("本轮交付")) # 单位成本:从用量字段取每轮令牌(示意:按字符串中的总量字段) tokens = sum(int(m) for r in log for m in re.findall(r"total_tokens[=:]\s*(\d+)", r["usage"])) # 漂移率:恭维与互换指纹 drift_pat = re.compile(r"(非常好|太专业|好问题|需要我帮你|那我替你)") drift_rounds = sum(1 for r in log if drift_pat.search(r["user"] + r["assistant"])) return { "完成率": 1.0 if finished else 0.0, "轮次效率": round(delivery_rounds / total_rounds, 2), "总令牌": tokens, "漂移率": round(drift_rounds / total_rounds, 2), } print(evaluate("show_log.json"))
{'完成率': 1.0, '轮次效率': 0.43, '总令牌': 9010, '漂移率': 0.0}
单场数字没有意义,指标在对照组里才活过来。把第 5 章四场演出加上对照组跑一遍,看板长这样:
import statistics def board(paths: list) -> dict: """多场汇总看板:均值即团队成绩单。""" rows = [evaluate(p) for p in paths] return { "完成率": statistics.mean(r["完成率"] for r in rows), "轮次效率": round(statistics.mean(r["轮次效率"] for r in rows), 2), "平均令牌": int(statistics.mean(r["总令牌"] for r in rows)), "漂移率": round(statistics.mean(r["漂移率"] for r in rows), 2), } show_paths = ["show_stock.json", "show_society_1.json", "show_code.json", "show_marketing.json"] print(board(show_paths))
{'完成率': 0.75, '轮次效率': 0.38, '平均令牌': 11800, '漂移率': 0.03}
解读:数字背后的处方
拿这块看板做一次真实解读。完成率 0.75——低于产线六成的合格线没有问题,但高于四场保留剧目的单演预期,主要拖后腿的是 AI Society 的截断层,对症动作在矩阵层(5.2 节已归因)。轮次效率 0.38 略低于 0.4 的参考线:验收与推进轮偏多,处方是把幕拆粗半档或合并相邻验收。漂移率 0.03 很健康,剧本约束在起作用——这是 2.2 节那套三段式模板的真实回报。平均令牌 11800 偏高的成分主要来自营销剧目(素材包全文进验收线),对症动作是双粒度手法的再收紧。
两个跨指标联判的规则值得写进团队约定。联判一:完成率高而漂移率高——这批数据产量好看但质量带病,严禁直接入库。联判二:成本压下来了而轮次效率同步下滑——多半是砍掉了验收轮,省钱省在了质量上。单指标达标从来不是终点,四指标互相制衡才是看板的本意。
最后交代与基准测试的关系:框架自带的公开基准(任务型对话、代码生成等)适合给模型与框架打分,本节的四指标适合给你自己的编排打分。两套分数回答不同的问题,别拿公开基准的分数字替代自家看板——前者证明机制上限,后者证明你的手艺。
看板的落地节奏最后交代一遍,避免"体系建好了没人用"的常见结局:先固化计算,再固化习惯。第一步把 evaluate 与 board 两个函数放进项目的固定脚本目录,任何演出脚本收尾时自动调用——让算分成为演出的一部分,而不是事后补的作业。第二步定一个复盘节拍,比如每跑完一批必看一次看板,超过两个指标越线就停下扩量。体系的价值在于被使用的频率,而不在于维度的精致程度。
还剩一个真实团队迟早会问的问题:指标要不要给产线设门槛?建议是设预警线而非拦截线——比如漂移率预警一成、拦截三成。理由是双智能体产出的方差天然偏大,拦截线太紧会把正常批次拦在门外,太松形同虚设;预警线的作用是触发人工看一眼,把机器不擅长的"灰度判断"留给值班的人。门槛数字从你自己的历史分布里定:取近二十个批次的中位数上浮两成作预警,翻倍作拦截,比照抄任何外部的标准都可靠。
看板立起来了。下一节看前路:框架往哪演进,你的编排要预留哪些接口。