6.2 下一步戏路:自适应演员与工具生态
6.2 下一步戏路:自适应演员与工具生态
本节摘要:本节看框架与编排手艺的三条演进主线:演员侧的自我改进(自适应智能体与经验记忆)、行头侧的工具生态扩张(外部接口与数据源的持续接入)、规则侧的交互协议加固(更稳的轮次与终止机制)。每条主线都落到同一件事——你的编排代码今天该预留什么接口。6.1 节的看板告诉你哪里不行,本节告诉你改进的路怎么铺。
为什么演进要提前看
看板报出短板之后,你有三条路:调参(3.3 节)、改剧本(2.2 节)、升级机制(本节)。前两条是修补,第三条是换代——但换代有陷阱:多智能体领域版本更迭快,今天的接口下个版本可能改名。本节的立场很务实:演进方向要跟,代码要松耦合。把"可能变的东西"收拢到隔离层,框架升级时你只改隔离层。
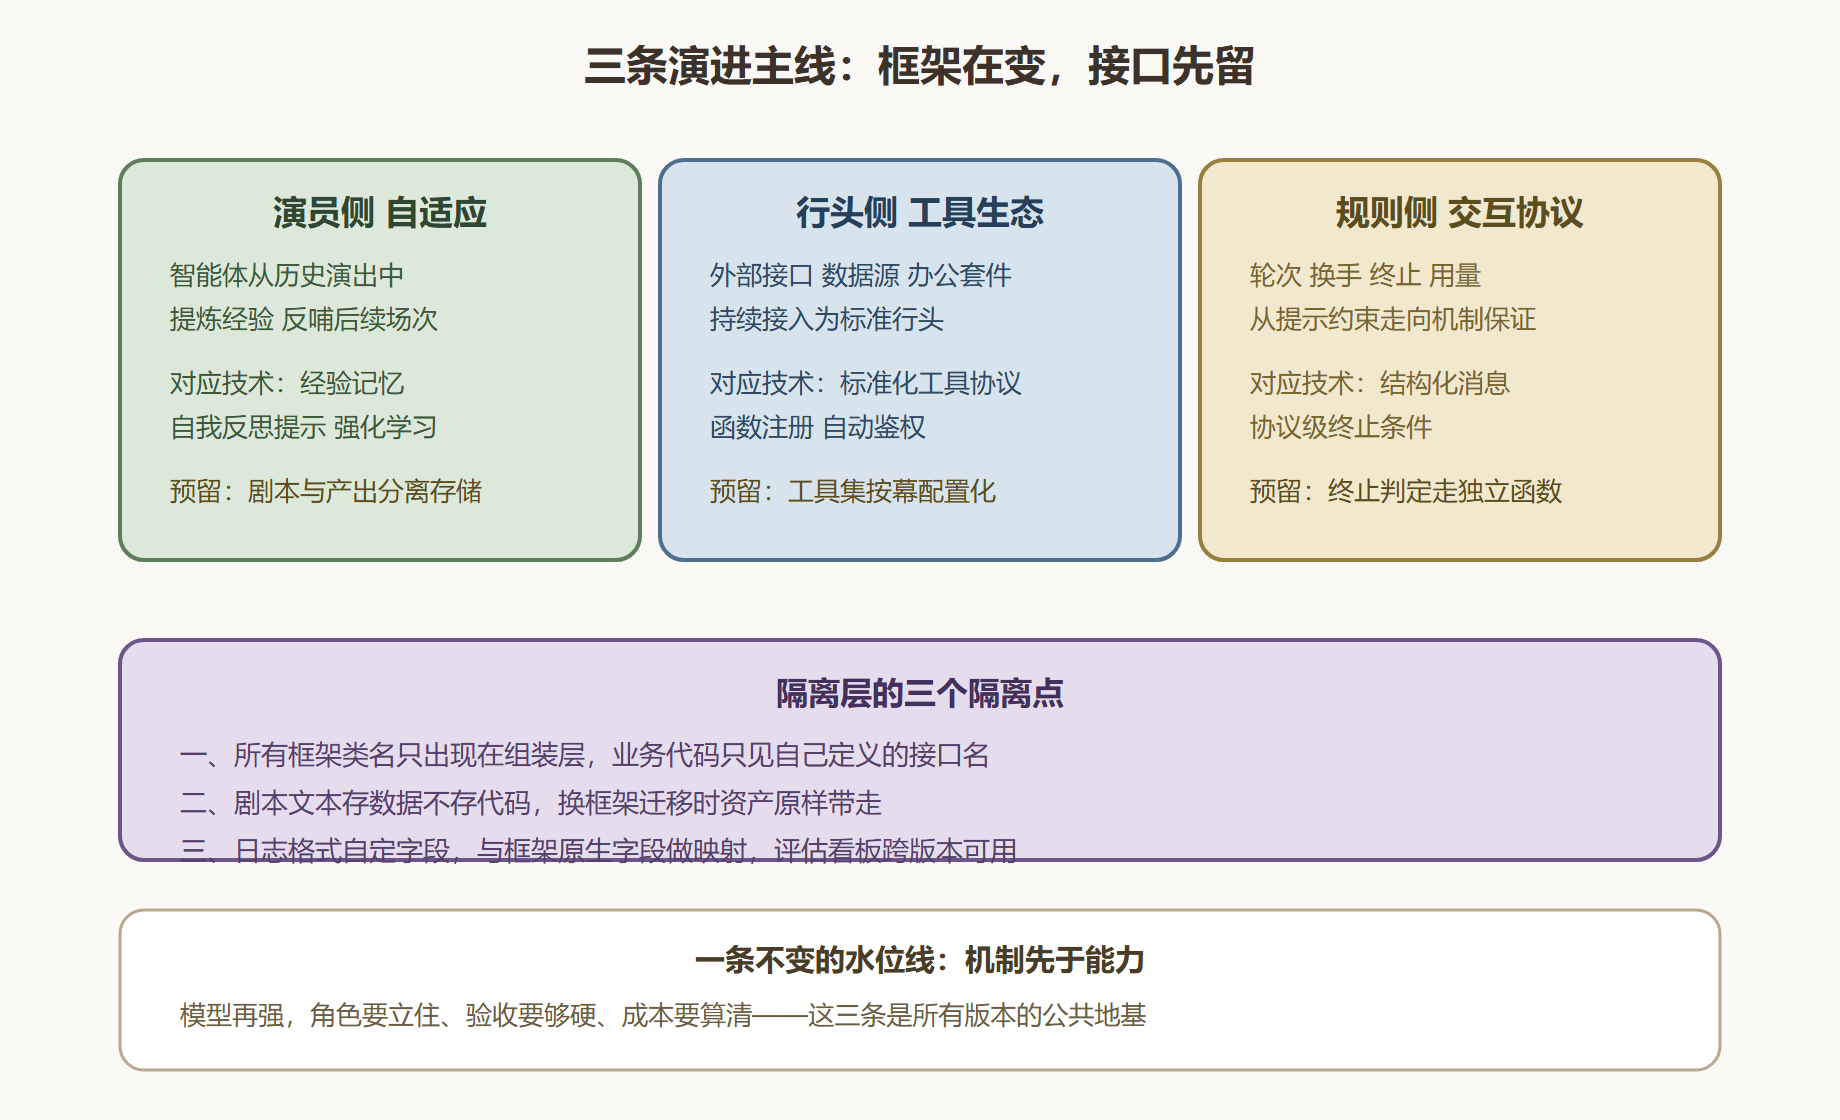
图 17 三条演进主线与你的预留接口
三条主线逐条落地
演员侧:从执行者到经验体。 现在的演员每场戏都是白纸——第 100 次演交易机器人与第 1 次没有区别。演进方向是给智能体配经验记忆:从已完成场次里提炼"什么指令形式最好验收""什么结构容易翻车",反哺后续场次的剧本。这条线的低配版本今天就能做:把每场戏的评估看板结果与退回意见存成经验库,批量开演前把同类任务的高频退回意见注入剧本——两行代码的"土法自适应",收益立竿见影。
行头侧:工具长成协议。 4.1 节的工具集是手写函数列表,演进方向是标准化的工具协议——工具声明、鉴权、发现都走统一规范,生态里的现成工具即插即用。你要做的是把 4.1 节"行头按幕配"从硬编码改成配置驱动:
# 工具配置化:幕次表声明每幕可用工具,组装层统一挂载 ACT_TOOLS = { "行情获取": ["stock_query", "code_runner"], "信号模块": ["code_runner"], "回测模块": ["code_runner", "data_source"], "主流程串联": ["code_runner", "doc_export"], } def mount_tools(act_name: str, registry: dict) -> list: """按幕从工具注册表取工具实例,注册表可来自本地或远端。""" names = ACT_TOOLS.get(act_name, []) tools = [] for n in names: if n not in registry: raise KeyError(f"工具 {n} 未注册——配置与注册表不一致") tools.append(registry[n]) return tools REGISTRY = {"stock_query": "行情查询实例", "code_runner": "执行器实例", "data_source": "数据源实例", "doc_export": "导出器实例"} print(mount_tools("回测模块", REGISTRY))
['执行器实例', '数据源实例']
配置化的直接收益有两个:换工具实现不动业务代码;某个工具下线时,注册表里换一个实现,幕次表一字不改。这正是工具协议化时代到来前你该做的隔离。
规则侧:终止条件从提示走向机制。 谢幕口令目前靠字符串匹配,演进方向是协议级终止——结构化消息里带类型字段,终止是类型而非文本。低配版的准备动作:把终止判定收拢成独立函数,框架的口令匹配、轮次上限、预算守卫三个信号都汇到这里,未来协议变了只改这一个函数。
def should_stop(round_i: int, budget_left: float, term_signal: bool, max_rounds: int = 14) -> tuple: """唯一的终止裁决点:三个信号源汇合。""" if term_signal: return True, "正常谢幕" if round_i >= max_rounds: return True, "轮次上限" if budget_left <= 0: return True, "预算触顶" return False, ""
should_stop(14, 500, False) -> (True, '轮次上限') should_stop(6, 500, True) -> (True, '正常谢幕')
演进路线排一张时间表
把三条主线按你该投入的顺序排序:先做规则侧的终止收拢(半天,防灾),再做行头侧的配置化(一到两天,防乱),最后做演员侧的经验库(持续,增益)。顺序的理由是风险不对称:终止失效是事故,工具散乱是技术债,经验缺失只是优化不足。防灾的事永远排前面。
时间表还要配上验收线,否则演进就成了没有终点的装修。三个验收问题直白得很:终止收拢后,所有的停演路径是否都经过 should_stop 这一个函数(全局搜一遍循环体便知);工具配置化后,换一个工具实现是否真的不用改业务代码(现场换一次试试);经验库转起来后,第二批任务的退回率是否低于第一批(6.1 节看板直接给数)。三个问题全过,演进投入才算落袋。
经验库的最小实现也顺手给出来——它比多数人想象的简单:
import json class ExperienceBook: """土法经验库:退回意见进书,开演前按任务类型取。""" def __init__(self, path: str): self.path = path def record(self, task_type: str, note: str): book = json.load(open(self.path, encoding="utf-8")) \ if __import__("os").path.exists(self.path) else {} book.setdefault(task_type, []).append(note) json.dump(book, open(self.path, "w", encoding="utf-8"), ensure_ascii=False, indent=2) def lessons(self, task_type: str, limit: int = 3) -> list: if not __import__("os").path.exists(self.path): return [] book = json.load(open(self.path, encoding="utf-8")) return book.get(task_type, [])[-limit:] book = ExperienceBook("lessons.json") book.record("回测类", "口径注释是最常见退回原因,剧本已加硬性要求") print(book.lessons("回测类"))
['口径注释是最常见退回原因,剧本已加硬性要求']
取出的条目按 2.2 节的格式拼回乙方剧本的约束段——这就是"把看板输出变成下一场戏输入"的全部机械部分。
自适应与强化学习这条线还要多说一句分寸:从演出数据里学经验与端到端强化训练智能体是两件事,后者需要稳定的奖励信号与海量场次,是研究团队的游戏;工程团队的正确姿势是本节说的经验记忆——把评估看板的输出变成下一场戏的输入,这个闭环今天就能转起来。
前路看清了。下一节备救场手册:线上跑着的系统会出什么事故,出事后按什么剧本处置。