5.1 游戏领域
5.1 游戏领域
本节摘要:游戏是智能体的「训练场」——环境可控、反馈即得、失败无代价。本节先讲游戏智能体的四个组成模块与六类应用(NPC 控制、自适应难度、PCG、测试、玩家分析、竞技 AI),再给行为树巡逻/攻击 NPC 与 GAN 迷宫关卡生成两个实战案例,最后讨论挑战与趋势。
读前必看(上)
阅读完本节,你应当能够:
- 说出游戏智能体的四个组成模块与六类应用场景
- 理解行为树的节点类型、三种状态与执行流程
- 用 Python 实现一个巡逻+攻击的行为树 NPC
- 解释 GAN 的生成器/判别器对抗训练原理
- 说出游戏智能体的挑战与未来趋势
问题与直觉
为什么游戏是智能体研究的「天然实验室」?三个原因:环境可控(游戏世界的一切规则都写在代码里,可观测、可重放)、反馈即得(每步都有明确奖励或惩罚)、失败无代价(AI 输一万次不会造成任何损失)。SOUCE 指出,正是这些特性让游戏成了 AlphaGo、AlphaStar 这类里程碑系统的试验田。
但游戏的约束也别低估:实时性(NPC 决策要在帧周期内完成)、趣味性(AI 不能太弱也不能强到劝退)、可解释性(开发者要能调试 AI 行为)。SOUCE 说游戏 AI 强调「自主性、学习能力、适应性」——与通用智能体一致,但实时与趣味这两条领域约束,让游戏 AI 形成了自己独特的技术栈(行为树、有限状态机),而不是直接套通用 RL。
核心原理
游戏智能体的四模块与六应用
SOUCE 把游戏 AI 智能体拆成四模块:感知模块(玩家位置、敌人状态)、决策模块(有限状态机/行为树/规划/机器学习)、行动模块(移动、攻击、交互)、学习模块(强化学习、模仿学习,可选但越来越重要)。
六类应用:NPC 行为控制(最经典,驱动敌人/盟友/商人)、难度调整与自适应 AI(根据玩家水平动态调难度)、程序化内容生成 PCG(关卡/地图/任务自动生成)、游戏测试与平衡性调整(自动化测试 + 模拟对局分析强度)、玩家行为分析与推荐、竞技游戏 AI(AlphaStar 击败星际争霸 II 人类选手是里程碑)。
「难度调整」这个应用常被当成「玄学」,其实它有清晰的实现路径。SOUCE 把它称为「自适应 AI」——核心是感知玩家水平 → 映射难度参数。实现上通常是:收集玩家行为(击杀率、通关时间、失误频率)→ 用规则或模型估计玩家技能等级 → 动态调整 NPC 的反应速度、血量、AI 决策深度。要注意的是「难度曲线」设计——难度陡升玩家流失,太平玩家无聊。所以自适应难度真正调的不是「绝对难度」,而是「难度与玩家技能差的距离」。这也呼应了前面说的「趣味性约束」:游戏 AI 的目标不是「赢」,而是「让玩家处在心流区」。
行为树:NPC 行为的模块化表达
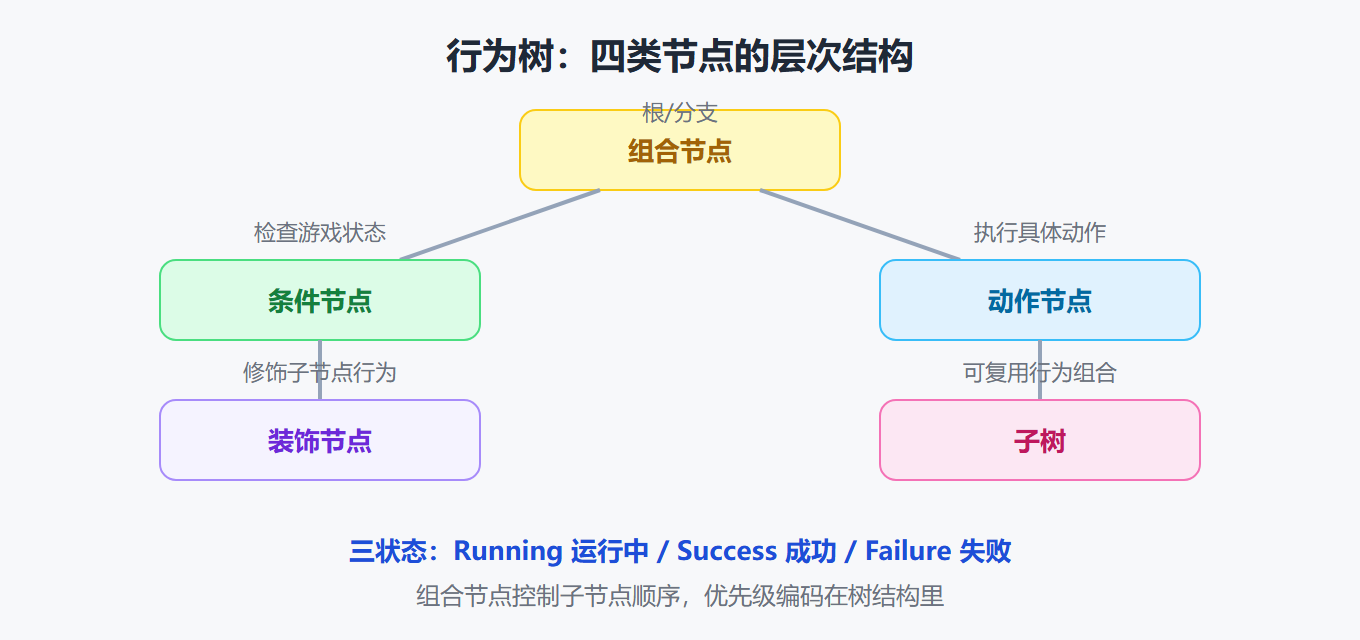
行为树(Behavior Tree, BT)是游戏 AI 的主流决策结构,比有限状态机更模块化、更好调试。三类核心节点:
- 动作节点:执行具体动作(移动、攻击)。
- 条件节点:检查游戏状态(敌人是否在视野、血量是否低于阈值)。
- 组合节点:控制子节点执行逻辑——Sequence(顺序执行,全成功才成功)、Selector(选择执行,一个成功就成功)、Parallel(并行执行)。
每个节点返回三种状态之一:Running(正在执行)、Success(成功)、Failure(失败)。执行从根节点开始递归,组合节点按逻辑控制子节点顺序。
SOUCE 的巡逻/攻击行为树:顶层是 Selector,先试「发现敌人」分支——如果条件不满足(没发现敌人),这个分支失败,Selector 转去执行「巡逻」分支。这就是行为树的核心思想:优先级编码在树的结构里(高优先级放前面),逻辑清晰、可图形化编辑、可单独测试每个子树。
行为树与有限状态机的选型
游戏 AI 的决策结构最常用的就是行为树和有限状态机(FSM),SOUCE 提到 FSM 是「决策模块可以采用的技术」之一,但没细说两者怎么选。这里补一张对照表:
| 维度 | 有限状态机 | 行为树 |
|---|---|---|
| 结构 | 状态 + 转移条件 | 树 + 节点组合 |
| 扩展方式 | 加状态、加转移 | 加子树、换子树 |
| 状态爆炸 | 容易(状态×状态组合) | 不易(节点独立) |
| 调试 | 看当前状态 | 看节点返回值 |
| 适用 | 状态明确、转移清晰 | 行为多、组合复杂 |
FSM 适合「有限几个状态、转移规则清晰」的 NPC(待机→巡逻→追击→攻击);行为树适合「行为组合多样、需要复用子行为」的复杂 NPC。SOUCE 的例子选择了行为树,正是因为巡逻/攻击/发现敌人这些行为可以拆成可复用的节点组合。实际项目里两者也常混用——行为树节点内部可以用 FSM 管理状态。记住一条经验法则:行为种类少于 8 个用 FSM,超过或者行为复用多,用行为树,别一上来就上行为树,那是给复杂度付额外学费。
工程实践要点
行为树 NPC 的最小实现
SOUCE 用 Python 演示了行为树的最小实现,节点基类 + 三个子类。先给个「为什么游戏 AI 爱用行为树」的直觉:在真实游戏里,NPC 的行为描述通常是「如果敌人进入视野就追击,追击过程中敌人跑了就回巡逻,被打死了就倒下」——这类「优先级 + 条件」的逻辑,用 if-else 写会越写越乱,用行为树就是把「条件」做成节点、「优先级」编进树结构,看得见、摸得着、好调试。行为树也因此成了引擎级标配——主流游戏引擎(Unity、Unreal)都内置行为树编辑器,美术和策划都能可视化配置 NPC 行为,不必写代码。
class Node: def execute(self, agent): pass class ActionNode(Node): def __init__(self, action): self.action = action def execute(self, agent): self.action(agent) return "Success" class ConditionNode(Node): def __init__(self, condition): self.condition = condition def execute(self, agent): return "Success" if self.condition(agent) else "Failure" class SequenceNode(Node): def __init__(self, children): self.children = children def execute(self, agent): for child in self.children: status = child.execute(agent) if status == "Failure": return "Failure" elif status == "Running": return "Running" return "Success" class SelectorNode(Node): def __init__(self, children): self.children = children def execute(self, agent): for child in self.children: status = child.execute(agent) if status == "Success": return "Success" elif status == "Running": return "Running" return "Failure"
这个实现只有几十行,但把行为树的执行语义完整表达出来了:Sequence 短路(一个子节点失败立刻返回失败)、Selector 短路(一个子节点成功立刻返回成功)。Agent 类里 patrol()、find_enemy()(30% 概率发现)、attack_enemy()(20% 概率击杀)都是简化模拟——真实游戏里这些是寻路、视野检测、战斗结算。行为树能流行,靠的就是「把复杂行为拆成可组合的小节点」,改一个子树不动整棵树。
值得注意 SOUCE 的 Agent 类里 current_patrol_point_index = (index + 1) % len(patrol_points) 这个细节——取模让 NPC 在巡逻点之间循环往返。它提示了行为树里「持久状态」的处理:树的节点本身应该是「无状态的」(每次执行从根开始),而 NPC 自己的状态(巡逻到第几个点、当前目标敌人是谁)存在 Agent 对象里。这个「树无状态、智能体有状态」的分离是行为树工程化的关键——树可以放心复用、并发,状态不会互相污染。
行为树的节点层次
基于 GAN 的程序化关卡生成
程序化内容生成(PCG)让 AI 生成关卡、地图、任务,降低开发成本、提供无限内容。SOUCE 用 GAN(生成对抗网络)做 2D 迷宫生成:
- 生成器(Generator):接收随机噪声,生成迷宫样本。
- 判别器(Discriminator):判断输入是真实迷宫还是生成迷宫,输出「真实性」概率。
训练是一个对抗博弈:生成器想骗过判别器,判别器想识破生成器,两者共同进化。SOUCE 的代码是概念性的——generator(noise) 随机生成迷宫(30% 墙壁),discriminator(maze) 用简单规则判断(起点终点可通、墙比例合理),train_gan 模拟训练循环。真实实现用深度神经网络 + 梯度下降,但「对抗」的思想完全一致:生成器和判别器互相逼对方变强。
PCG 还有两个非 GAN 的经典路线值得知道,因为它们在实际游戏里用得更多:分形与噪声算法(Perlin 噪声生成地形,可控性强、速度快,是《我的世界》这类沙盒的地形来源)和搜索式生成(用约束求解/进化算法生成满足设计规则的关卡,可玩性有保证)。GAN 路线的优势是「学数据的分布」、能生成风格化的内容;劣势是可控性差、训练不稳定。所以工程上 GAN 常和其他方法混用——GAN 先「发散创意」,规则/验证再「收敛到可玩」。SOUCE 的判别器其实已经在做「收敛」这一步,只是它没把「可玩性验证」和「生成」拆成两个独立阶段来讲。
⚠️ 常见坑:把「生成关卡」误当成「生成可玩关卡」。随机生成的迷宫可能无解、可能过于简单——SOUCE 特意在判别器里加「起点终点是否可通」「墙壁比例是否合理」的检查,就是为了兜住可玩性。实际工程里 GAN 生成后通常还要跑一遍「可玩性验证」(自动玩一次看能否通关)。
💡 关键直觉:游戏 AI 的「智能」常常是分层的——底层用行为树/FSM 保证行为可控可调试,上层用强化学习/GAN 提升能力或生成内容。快慢结合、确定性兜底,是游戏领域最实用的组合拳。
挑战与趋势
SOUCE 列的挑战:复杂行为建模(行为树到一定程度难维护)、情感与个性化(AI 要有情绪、要适配玩家)、学习能力与适应性、可解释性与可控性(深度学习黑箱难调试)、伦理与社会影响(AI 会不会取代人类玩家)。趋势:更很强的深度学习模型(Transformer、图神经网络)、强化学习与模仿学习结合(RL 学策略、IL 从人类演示学)、个性化 AI 体验、AI 辅助游戏设计开发(关卡/剧情/角色)、云端 AI 与边缘计算。
「可解释性与可控性」这条挑战值得单独展开——它是游戏 AI 与通用 RL 研究的一个关键分歧。强化学习训练出的 AI 可能很强,但开发者不知道它为什么那么强,更不知道它在某个隐藏状态下会不会做出离谱行为(比如打不过就原地打转)。游戏要发布、要长期维护,黑箱 AI 是运营噩梦。所以游戏行业对 RL 的应用很谨慎:训练时给奖励函数加约束,上线前做行为审计,关键 NPC 保留行为树做「安全网」——RL 负责「优化表现」,行为树负责「保证下限」。这个「学出来的能力 + 写出来的底线」组合,比纯 RL 或纯规则都更稳妥,也是 SOUCE 把「可解释性」列为挑战的深意。
顺着「可解释性」再往下走一步,就碰到游戏 AI 的「调试工具链」问题。行为树的调试是结构化的——哪个节点返回了 Failure,一眼能看出来;而深度 RL 智能体的调试是「黑箱猜谜」——只能通过录屏观察行为、统计状态访问分布、检查奖励曲线间接推断问题。SOUCE 提到 AlphaStar 这类竞技 AI 的成功,但没说它背后的工程代价:长达数月的大规模分布式训练、庞大的评测体系、海量的行为日志分析。小团队做游戏 AI 时,这条「调试成本」的红线几乎决定了技术选型——能用行为树解决的绝不上 RL,不是 RL 不好,是「出了 bug 修不起」。
一节小结
- 四模块:感知、决策(FSM/BT/RL)、行动、学习
- 六应用:NPC、难度调整、PCG、测试、玩家分析、竞技 AI
- BT vs FSM:行为少用 FSM,行为复杂用行为树,别过度设计
- 行为树三节点:动作、条件、组合(Sequence/Selector/Parallel)
- 三状态:Running/Success/Failure,结构即优先级
- 树无状态、体有状态:节点可复用,NPC 状态存 Agent 对象
- GAN 对抗:生成器骗、判别器识,共同进化
- 可玩性兜底:生成内容要过「自动可玩验证」
- 分层组合:BT 保可控,RL/GAN 提能力
- 领域教训:实时性 + 趣味性 + 可调试性约束技术选型
虚拟世界说完了,下一节进入「真刀真枪」的物理世界——机器人领域。