2.1 数学基础:线性代数、概率与优化
2.1 数学基础:线性代数、概率与优化
本节摘要:大模型的前向传播本质是大规模矩阵乘法,训练本质是概率建模下的梯度优化。本节浓缩三块数学底子——线性代数(怎么算)、概率论(算什么目标)、优化理论(怎么调参数),每一块都直接对接后续章节的具体技术点,不讲用不到的定理。
学习目标
阅读完本节,你应当能够:
- 说清向量、矩阵、矩阵乘法在模型里的作用,并理解形状(shape)匹配规则
- 用"嵌入"的概念解释词为什么能被计算
- 解释概率分布、最大似然与语言模型训练目标的关系
- 手推一遍梯度下降的更新式,并说明学习率的角色
从一次矩阵乘法开始:线性代数是模型的运算语言
大模型的参数本质是矩阵和向量。一次前向传播,底层就是在做天文数字量的矩阵乘法——这也解释了为什么 GPU(天生擅长并行矩阵运算的硬件)会成为 AI 时代的硬通货,第 7 章讲推理成本时这个事实还会回来。
先把三个基本对象定义清楚:
- 向量(vector):一维数组。一个词的嵌入向量、一个样本的特征向量,都是它。向量有维度,如 4096 维。
- 矩阵(matrix):二维数组。模型每一层的权重就是一个矩阵,形状如(4096 × 4096)。
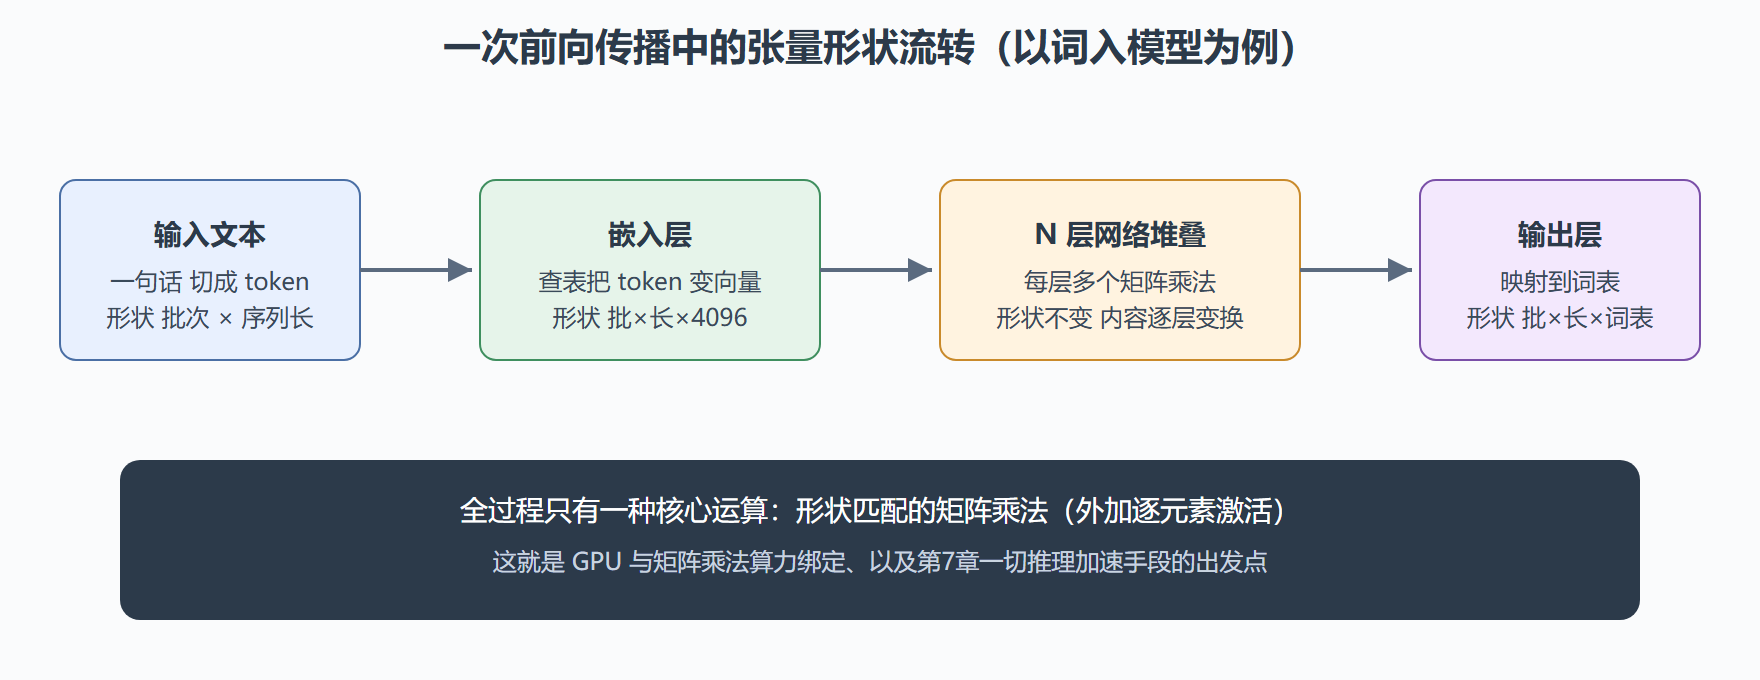
- 张量(tensor):矩阵的推广,三维及以上。批量训练时数据是三维张量(批次 × 序列长度 × 维度)。
矩阵乘法是核心运算。神经网络最基本的一步就是:
y = W·x + b
输入向量 x(维度 d_in)乘以权重矩阵 W(形状 d_out × d_in),得到输出向量 y(维度 d_out),加偏置 b。注意形状规则:W 的列数必须等于 x 的维度——所谓"维度对不上",指的就是这个。Transformer 里一次注意力的计算,本质就是几个大矩阵相乘(第 4 章展开)。
给一个可以手算的小例子,帮助建立实感。设 x = [1, 2],W = [[0.5, 0.2], [0.3, 0.8]],b = [0.1, 0]:
W·x = [0.5×1 + 0.2×2, 0.3×1 + 0.8×2] = [0.9, 1.9] y = [0.9 + 0.1, 1.9 + 0] = [1.0, 1.9]
真实模型只是把这里的 2 维换成 4096 维甚至更高,把一次乘法换成每秒千万亿次——数学上没有新东西。
从一次乘法到千亿参数
把"一层 = 一次矩阵乘法加激活"这个视角贯穿到底:一个 70 亿参数的模型,约有几十层,每层包含若干个几千万到几亿参数的矩阵。所谓"参数量",就是所有这些矩阵里数字的总个数。训练,就是调整这几十亿个数字。
张量形状流转图
二、概率论:模型的目标语言
大语言模型本质上在建模概率:给定前文,预测下一个 token 的概率分布。这句话是整个领域最重要的一句话,值得拆开理解。
- 概率分布:模型输出不是一个词,而是词表里每个候选词各有一个概率,全部概率加起来等于 1。词表通常有 3 万到 15 万个条目。
- 最大似然(Maximum Likelihood):训练目标是让"真实出现的下一个词"拿到的概率尽量大。如果训练文本里"今天天气很"的下一个词是"好",就调整参数让 P(好 | 今天天气很) 升高。对海量语料的每个位置都做这件事,加总起来就是训练损失(交叉熵)。
- 采样:生成时从分布里抽词。温度参数控制随机性——温度低,分布尖,总选最高概率的词,输出稳定但呆板;温度高,分布平,偶尔抽到低概率词,输出多样但容易跑偏。第 7 章的解码策略会细讲。
一个容易被忽略的推论:因为目标是"像训练数据那样说话",而不是"说真话",所以模型不保证事实正确。幻觉问题的数学根源就在这里——第 10 章的安全治理、第 8 章的评估,都是对这个根源的外部补救。
再补一个后面会用到的概念:条件概率链式分解。一句话的概率可以分解成每个词在给定前文下的条件概率连乘:
P(w1, w2, ..., wn) = P(w1) × P(w2|w1) × P(w3|w1,w2) × ... × P(wn|w1,...,wn-1)
语言模型学的就是右边每一个条件概率。自回归生成——一次一个词、把生成的词接到后面继续生成——就是对这个分解的直接执行。
三、优化理论:训练的本质
训练模型 = 调整参数让损失最小。怎么调?靠梯度。
- 损失函数(Loss):一个标量,衡量模型输出与真实值的差距。损失越低,模型越"像"数据。
- 梯度(Gradient):损失对每个参数的偏导数组成的向量,指向"损失上升最快的方向"。
- 梯度下降(Gradient Descent):沿梯度反方向更新参数,每次走一小步:
参数_new = 参数_old − 学习率 × 梯度
为什么是反方向?梯度指向损失上升最快处,我们要下山,自然往反方向走。可以用一个一维例子手推:设损失 L(w) = (w − 3)²,导数 L'(w) = 2(w − 3)。当前 w = 0,学习率 0.1:梯度为 −6,更新 w = 0 − 0.1 × (−6) = 0.6;再算一次,w = 0.6 − 0.1 × (−4.8) = 1.08……可以看到 w 一步步逼近最小值点 3。真实训练只是把"一个参数"换成"几十亿个参数",把"解析导数"换成"反向传播自动算"。
实践中没人用全量数据算梯度(太贵),而是用小批量随机梯度下降:每次抽一小批数据估计梯度,方向有噪声但便宜得多,且噪声本身有助于跳出局部坑洼。
⚠️ 常见误解:以为梯度下降一步到位,或者认为训练能找到全局最优。实际情况是:损失曲面维度极高、局部最优极多,训练找到的是"足够好的解",靠的是足够的迭代次数、恰当的学习率和一点点运气。工程上的"训练失败",多数是发散(loss 变 NaN)或停滞(loss 不降),而不是"找到了一个坏的最优"。
四、三块数学如何串成一个训练故事
现在把三块拼起来,你会发现"训练大模型"这个庞然大物,骨架只有三句话:
- 线性代数说:模型是层层矩阵乘法,参数是矩阵里的数字(怎么算)。
- 概率论说:目标是让真实下一个词的似然最大,损失用交叉熵(算什么)。
- 优化理论说:用反向传播算梯度,沿反方向小步更新,迭代万亿次(怎么调)。
后续章节的所有名次——预训练、指令微调、RLHF、LoRA——都没有跳出这个骨架,只是换了数据、换了损失函数的形状、换了更新的参数子集。抓住骨架,名词就吓不到你。
常见问题
问题:我数学不好,能学大模型吗?
能。本教程用到的数学就是本节这些,理解"向量是数组、矩阵乘法是变换、梯度指方向"三个直觉即可应付主线内容。想深入研究论文推导时再回炉线性代数与概率论也不迟。
问题:为什么矩阵乘法这么重要,连芯片都围着它转?
因为模型 95% 以上的计算量都是矩阵乘法,它高度规则、可并行、无分支,恰好是 GPU 数千个小核心最擅长的负载。第 7 章会看到,推理优化的本质就是把矩阵乘法做得更省(量化降低数字精度)或更少(KV 缓存避免重复计算)。
问题:最大似然和最小化交叉熵是一回事吗?
在语言模型语境下可以划等号:最小化交叉熵等价于最大化似然。看到两个词混用不必困惑。
五、三个动手练习
数学手感靠手算养成,这里给三个可以直接在纸上完成的练习,难度递进:
练习一(向量与相似度):设两个词向量 a = (1, 2, 1),b = (2, 4, 2),c = (1, 0, -1)。计算 a 与 b、a 与 c 的点积与夹角余弦。你会发现 a 与 b 方向几乎相同(语义相近),a 与 c 正交(语义无关)——这就是第 9 章 RAG 向量检索的最底层运算,整条检索链不过是它的亿万次重复。
练习二(矩阵乘法):用正文里那个 2×2 的例子,把 x 换成 (3, 1),重新算一遍 y。再做一个小实验:把 W 的第二行乘以 10,观察输出的哪个分量变了——体会"权重矩阵的行控制输出的哪个维度"这件事,第 6 章 LoRA 修改的正是这些矩阵。
练习三(梯度下降):设损失 L(w) = (w − 2)²,学习率 0.3,从 w = 5 出发手推四步更新。观察每步离最小值点 2 的距离变化;再把学习率改成 1.1 推两步,感受发散。做完这两个小实验,"学习率太大发散"就不再是书上的警告,而是你亲眼见过的现象。
三个练习共用一个中心思想:大模型的所有计算,都是这三个练习的规模化重演。规模带来复杂度,但不带来新数学。
常见追问:需要学到能推导公式吗?
分目标看。工程实践需要的是"形状直觉"(维度对不对得上)与"方向直觉"(梯度往哪走),这两个 2.1 节都给了手算级例子。论文复现与前沿研究才需要推导能力(比如自己推出注意力的梯度表达式)。建议的路径:先把直觉用到熟,工作中遇到推导需求再回头补——以任务驱动学习数学,效率远高于系统刷教材。
再追问:怎么快速判断自己数学是否够用?
一个五分钟自测:看到"矩阵乘法要求内维相同"能立刻明白是什么意思;能口算二维向量点积;理解"概率分布所有取值加起来等于一"的含义;能解释"梯度是损失上升最快的方向"为什么反而要反向走。四条全过,你的数学足以支撑本教程全部内容;有迟疑的条目,回到 2.1 对应段落读两遍即可——不需要报班,不需要教材,缺的只是这几个具体概念。
最后一问:还有哪些数学以后可能用到?
三块按需补:信息论(熵与困惑度——第 5 章讨论语言模型质量时会遇到,理解"交叉熵越低越好"的量化根源);概率图与贝叶斯思想(理解不确定性建模的进阶内容);数值计算基础(浮点精度、数值稳定性——第 7 章量化的深层原理)。三块都不急,遇到再补;2.1 的地基足够支撑你走到需要它们的那一天。
补记:单位与量级的速记
三个值得记住的量级锚点:现代大模型的隐藏维度在数千级、层数在数十到百余层、词表在数万级——三者相乘即是参数量的来源。看到任何模型规格,先在脑中做这道乘法,参数世界的"大"就不再是抽象数字,而是可拆解的工程量。这个心算习惯建议现在养成,第 6、7 章会反复用它。
最后留一道综合思考题:语言模型每一步的输出是一个上万维的概率分布,而 softmax 之前模型算出的其实只是一组打分——请用本节的概念解释"从一组打分到一个合法分布"经历了什么运算,以及温度参数在这个运算的哪一步介入。能独立答出(softmax 归一化、温度在指数前缩放打分)的同学,2.1 节可以正式结业了。
本节要点回顾
- 大模型运算 = 大规模矩阵乘法(
y = W·x + b的层层堆叠),GPU 因它而关键。 - 语言模型本质是建模下一个词的条件概率分布;训练目标 = 最大似然(= 最小化交叉熵)。
- 生成 = 从分布中采样;"像数据"不等于"说真话",这是幻觉的数学根源。
- 训练 = 梯度下降:
参数 −= 学习率 × 梯度,小批量、迭代亿万次。 - 三块串联:线性代数(算)+ 概率(目标)+ 优化(方法),后续所有训练名词都在这个骨架内。
下一节把这些数学装配成结构:神经元怎么组成网络,"深度"从哪来、又带来什么麻烦。