2.2 神经网络与深度学习原理
2.2 神经网络与深度学习原理
本节摘要:神经网络是大模型的结构基础。本节从单个神经元的最小计算讲起,经过前向传播、激活函数与"深度"的意义,抵达一个关键认识:大模型并不是一种全新的数学,而是把本节的朴素结构推到极深极宽的工程结果。深度带来的梯度消失问题,以及残差连接与归一化这两个救命设计,也在本节埋下伏笔。
学完你能
阅读完本节,你应当能够:
- 写出单个神经元的计算式并解释每个符号
- 描述多层网络的前向传播过程与"层"的抽象含义
- 解释为什么必须有激活函数,区分 ReLU/GELU/Softmax 的用途
- 说明"深度"的价值与代价(梯度消失/爆炸)
- 理解残差连接与归一化在深网络中的作用
一、神经元:基本计算单元
一个神经元做的事情简单到让人怀疑:加权求和,加偏置,过一个激活函数。
y = f(w·x + b)
w 是权重向量,x 是输入向量,b 是偏置标量,f 是激活函数。这个公式在数学上就是 2.1 节的一次矩阵乘法(当层里有很多神经元并列时,各神经元的 w 拼成权重矩阵)。所谓"神经元"只是借了神经科学的名字,和生物神经元的关系大概相当于纸飞机和波音 747。
每个神经元可以被理解成一个"可调的小判断":w 决定它关注输入的哪些维度、关注多少;b 决定它的触发门槛;f 决定判断的输出方式。训练,就是在调整几十亿个这样的小判断。
二、前向传播:数据在网络中的流动
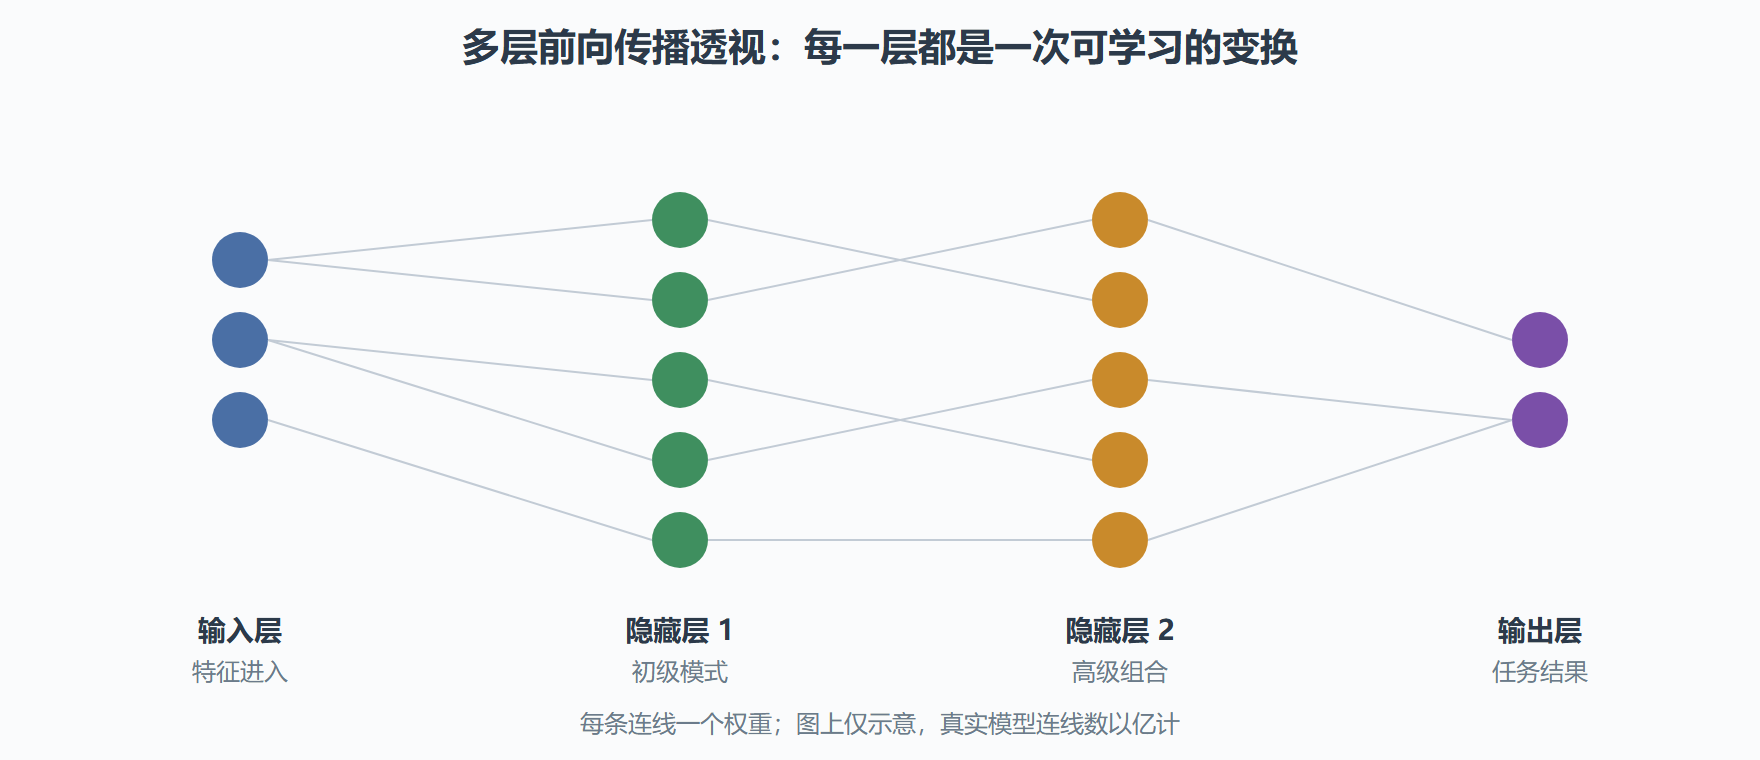
把很多神经元组织成层,信号从输入层流向输出层,每层做一次"乘权重、加偏置、过激活",这就是前向传播。
输入 x → 第1层:h1 = f(W1·x + b1) → 第2层:h2 = f(W2·h1 + b2) → 第3层:h3 = f(W3·h2 + b3) → 输出层:y = W4·h3 + b4
"层"是一个灵活的抽象:在早期的全连接网络里,一层是一个矩阵乘法;在卷积网络里,一层是一次卷积;在 Transformer 里,一层是"注意力 + 前馈网络"的组合模块(第 4 章)。抽象不变的是:输入一个张量,做一个可学习的变换,输出一个张量。
全连接网络分层透视
三、激活函数:没有它,深一万层也没用
如果去掉激活函数 f,会发生什么?线性变换的复合还是线性变换——不管叠多少层,整个网络等价于一个矩阵乘法,连"深度"这个词都失去意义。激活函数通过引入非线性,让网络能拟合曲线、边界和一切复杂关系。
| 函数 | 形状特点 | 常用位置 |
|---|---|---|
| ReLU | 小于 0 输出 0,大于 0 原样输出 | 卷积网络与早期模型隐藏层主力 |
| GELU | ReLU 的平滑版,处处可导 | Transformer 的默认选择 |
| Sigmoid | 把任意数压到 0~1 | 二分类输出、门控(LSTM 里会再见到它) |
| Softmax | 把一组数变成概率分布 | 多分类输出、语言模型最后一层 |
两个后面会反复遇到的细节:语言模型最后一层用 softmax 把原始打分(logits)转成"下一个词的概率分布"——2.1 节的概率故事在这里落地;GELU 在 Transformer 前馈网络中担任激活,平滑性让它在深网络里梯度表现更好。
四、深度:为什么堆这么多层
"深度"指隐藏层数量多。它的价值在于层次化抽象:浅层抓局部、表面的模式(视觉里的边缘、语言里的词组搭配),深层把这些模式组合成高层语义(视觉里的物体、语言里的句法与篇章逻辑)。人类视觉系统也是类似的分层加工,深度学习算是撞上了同一条路线。
但深度有代价,而且代价很具体:梯度消失/爆炸。反向传播用链式法则逐层相乘来传梯度(2.3 节细讲),如果每层把梯度缩小一点,传到浅层时梯度趋近零——浅层参数等于学不到东西,这就是梯度消失;反之放大则是梯度爆炸,训练直接数值溢出。早期人们试图训十几层的网络,屡战屡败,就是卡在这里。
两个救命设计在 2015 年前后出现,直接为后来的百层大模型铺平了道路:
- 残差连接(Residual Connection):让每层学习"增量"而不是"全量"——输出为
层变换(x) + x。当梯度回传时,加法分支提供了一条无衰减的高速公路,深网络从此训得动。Transformer 每个子层都带残差。 - 归一化(LayerNorm 等):把每层的输出数值拉回稳定范围,防止逐层放大或缩小。Transformer 用 LayerNorm,现代变体改用更稳定的 RMSNorm(第 4 章)。
💡 一个值得记住的判断:残差连接是"深"的前提。没有它,百层网络在数学上就不可训练——一个一行代码的设计,决定了整个大模型时代的可能性边界。这种"小设计撬动大格局"的模式,在本教程后面还会反复出现(KV 缓存、LoRA 的低秩假设都是同类故事)。
五、宽与深之外:从神经网络到大模型
大模型在结构上是超深(几十上百层)、超宽(隐藏维度数千)、参数数十亿到数千亿的 Transformer 网络。它没有引入新的数学——前向传播还是矩阵乘法加激活,训练还是梯度下降。变的是规模与结构细节:注意力机制取代固定连接来处理序列(第 3、4 章),数据与算力把参数量推过涌现临界点(第 1 章的图景)。
所以本节的定位是"结构连续性":从 y = f(w·x + b) 到千亿参数,是一条连续的工程演化线,中间没有魔法跳变。理解了这一点,第 4 章读 Transformer 时你只需要专注一个新东西——注意力——其余组件(层、激活、残差、归一化)本节已全部备齐。
常见问题
问题:神经元越多、层越深就一定越好吗?
不是。容量要与数据量和算力匹配:参数远超数据能支撑的规模会过拟合;深度超过优化能力则训不动。第 4 章的规模定律会给出"给定算力下最优的深宽配比",答案是规模要成套地长,不是单维度猛堆。
问题:为什么 Transformer 用 GELU 而不是 ReLU?
经验选择:GELU 平滑、处处可导,在深 Transformer 中的训练稳定性和最终效果都略好。差异不大,但大模型训练成本极高,哪怕 1% 的改善也值得换。
问题:残差连接会不会让网络"跳过"学习?
不会。它只是保证"至少不比输入差"的底线,主干仍然要学习有用的增量。经验上残差网络的浅层学到低层特征、深层学到高层语义的分层规律依然成立。
六、从 2.2 到大模型:一张自检清单
本节结束前,给一份自检清单——以下每一条都是后续章节的直接依赖,能用自己的话答出来,第 4 章就会读得很顺:
一、给一个输入向量和一层权重,能否写出输出式并算出形状?这是读注意力公式(第 3.3 节)的门槛。
二、能否解释"没有激活函数,深等价于浅"?这是理解一切非线性结构(门控、注意力加权)价值的钥匙。
三、能否说出 softmax 在语言模型最后一层的具体作用?把一组打分变成概率分布——第 5 章的训练目标和第 7 章的采样解码,都从这一个函数出发。
四、能否解释残差连接为什么能救深网络?加法分支让梯度无衰减通过——第 6 章 LoRA 的旁路设计、第 7 章投机解码的验证机制,用的都是同构的"额外通路"思想。
五、能否说明归一化解决什么问题?数值逐层漂移会让训练崩坏,归一化把它拉回稳定区间——第 4 章 Pre-LN 与 RMSNorm 的讨论直接建立在这个理解上。
答不上来的条目,回到对应小节重读;都答得上来,恭喜——你已经具备读懂几乎所有大模型论文方法部分的结构性知识。剩下的新东西(注意力、掩码、位置编码)会在下一章悉数登场。
常见追问:为什么不再发明新的基本单元?
神经网络的基础研究八十年代就基本定型(神经元、层、激活、反向传播),此后三十多年的主旋律是"如何把这套单元组织得更好、训得更深"——残差、注意力、归一化都是组织术而非新单元。这个视角能帮你识别炒作:真正值得关注的创新通常在"结构组合"与"训练方法"层面,宣称"颠覆性新神经元"的工作,历史上极少兑现。判断一项"新突破"的位置(单元层还是组织层),是快速过滤技术新闻的实用技能。
再追问:深度学习与传统机器学习(如决策树)的本质区别?
两个视角的回答。表示视角:传统模型用人工特征加浅层模型,深度学习让"特征提取"本身可学习——层层抽象这件事从手工变成了自动,这是它在图像、语言等原始信号上碾压的根源。工程视角:传统模型小而透明、深度模型大而黑盒,两者的取舍贯穿第 1.2 节的对比矩阵。理解这两层区别,你就能准确预判"什么时候梯度提升树仍然够用"(表格数据、小样本、需要解释)——这也是资深工程师的常见判断题。
最后一问:网络到底"学会"了什么?
一个有启发的回答:学会的是"表示的变换"。输入的原始向量经过层层变换,最终变得"线性可分"或"可被下一步预测"——所谓学习,就是找到那一系列恰当的变换矩阵。这个视角下,深度的意义(层层抽象)、残差的意义(保底通路)、微调的意义(微调最后一组变换)都统一起来了。带着"变换"这个透镜重读本章,很多细节会再次连通。
补记:一张对照速查
入门阶段最容易混淆的四组概念,做成速查:权重与偏置(可学习的系数与门槛);层与深度(一次变换与变换的次数);宽度与维度(每层神经元的数量,即向量维度);训练与推理(调整参数的过程与使用参数的过程)。四组词在本章各出现多次,对照清楚后,第 4 章的架构讨论里它们将以组合形态高频出现。
最后留一道观察题:找一个大模型的公开规格表(任选一家),记下它的层数与隐藏维度,用本章的神经元视角换算一下——它相当于多少个"加权求和加激活"的基本单元在协同工作。换算出的数字会大到没有直觉,但这正是"规模"的数学含义:没有新原理,只有同一原理的亿万次重复。这个认识是抵御一切神秘化叙事的最好疫苗。
本节要点回顾
- 神经元 = 加权求和 + 偏置 + 激活:
y = f(w·x + b),是矩阵乘法的最小形态。 - 前向传播:张量逐层流过可学习变换;"层"是统一抽象。
- 激活函数引入非线性,否则深等价于浅;Transformer 用 GELU,语言模型输出用 softmax。
- 深度的价值是层次抽象,代价是梯度消失;残差连接与归一化是深网络可训练的前提。
- 大模型与本章结构一脉相承,新东西只有注意力——留给第 4 章。
结构有了,下一节装发动机:损失怎么定义、梯度怎么算回来、参数怎么更新。