3.1 文本预处理与词向量表示
3.1 文本预处理与词向量表示
本节摘要:模型不认得文字,只认得数字。把语言数字化的流水线分两步:分词(tokenization)把文本切成 token,词向量(embedding)把 token 映射成携带语义的稠密向量。本节讲 BPE 子词分词的机制与取舍、词向量"语义相近则向量相近"的原理,以及从 word2vec 静态向量到上下文向量的关键跃迁——后者是大模型能理解歧义的基础。
阅读目标
阅读完本节,你应当能够:
- 解释为什么需要分词,以及词级、字级、子词三种方案的取舍
- 描述 BPE 的构建流程
- 说明词向量如何让语义可计算,并能举出向量运算的例子
- 区分静态词向量与上下文向量,解释为什么后者是大模型的必需品
一、分词:把文本切成 token
神经网络吃的是数字,第一步是决定"数字的基本单位",也就是分词单位的选择:
- 词级:按词切(英文按空格,中文需分词工具)。问题:词表巨大(几十万词),且永远处理不了新词。
- 字级:按单字/单字母切。问题:序列太长(同样一句话 token 数翻几倍,后面会看到注意力对序列长度的开销是平方级的),且单字携带的语义太少。
- 子词(subword):折中方案——高频词保留整体,低频词切成碎片。大模型的标准答案。
**BPE(Byte Pair Encoding,字节对编码)**是最常用的子词算法,构建过程像压缩算法一样朴素:从字符开始,统计语料里最频繁出现的相邻符号对,合并成新符号,重复几万次。语料里"机器"总是一起出现,就会被合并成一个 token;"transformer"若频率低,可能被切成 "trans" + "former"。派生算法 WordPiece(BERT 用)与 SentencePiece(支持无空格语言、多语言大模型常用)思路同源。
一个具体例子,看中英混合文本怎么被切:
输入:我爱吃苹果,iPhone 15 很好用。 切分(示意):我 | 爱 | 吃 | 苹果 | , | iPhone | 15 | 很 | 好用 | 。
"苹果"作为高频词整体保留;标点也是 token。实际大模型词表 3 万到 15 万条,中文常用双字词、英文常用整词直接进表。
词表大小是个真实的工程取舍:词表越大,同样的文本 token 数越少(推理越便宜、上下文窗口装得越多),但嵌入矩阵越大(参数与显存开销),且低频 token 训练不充分。主流大模型把词表定在 5 万到 15 万之间,就是这个平衡的产物。
💡 一个常被忽略的实用事实:中文的 token 效率问题。早期以英文为主的词表里,一个汉字常被切成 1–2 个 token,同样内容中文消耗的 token 数是英文的 1.5–2 倍,直接推高中文用户的 API 成本。新一代模型的词表都专门扩充了中文条目。你评估大模型服务成本时,"我们语言的 token 效率"是个该问的问题。
二、词向量:让语义可计算
token 只是离散的 id(词表里的编号),模型需要把它变成连续向量才能做矩阵运算。词向量(word embedding)就是把每个 token 映射成一个固定维度的稠密向量——实现上就是一张可学习的查找表:嵌入矩阵,行数等于词表大小、列数等于向量维度,token id 是几就取第几行。
这张表为什么"语义相近的词向量也相近"?因为它是被训练出来的。word2vec(2013)的思路极其简洁:一个词的上下文和另一个词的上下文相似,这两个词的向量就会被推近。"银行"总在"存款、利率"附近出现,"储蓄"也是,两者的向量自然靠近。语义相似性从共现统计中浮现,不需要任何人工标注。
语义可计算最著名的例子:
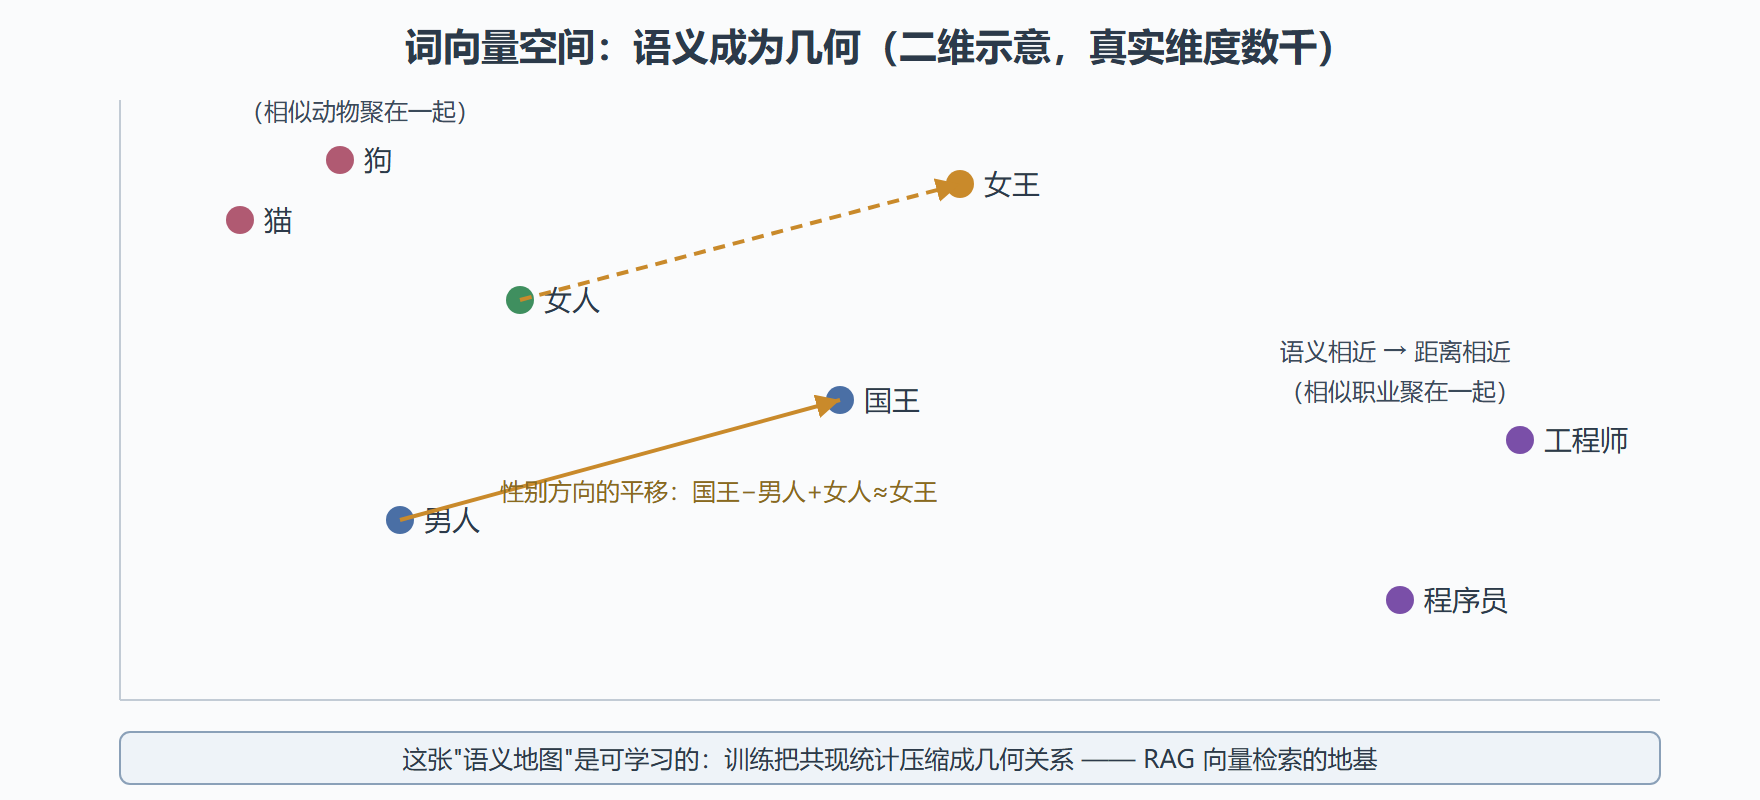
向量(国王) − 向量(男人) + 向量(女人) ≈ 向量(女王) 向量(巴黎) − 向量(法国) + 向量(中国) ≈ 向量(北京)
类比关系被编码为向量空间里的方向偏移。这组例子第一次让人看到"意义"变成了可运算的几何对象,整个 embedding 概念(词向量、句子向量、文档向量,乃至多模态里的图像向量)都源于这里。第 9 章讲 RAG 检索时,向量检索就是把"语义相近"当成数据库的查询条件——根子在本节。
词向量空间示意
三、静态词向量的天花板:一词多义
word2vec、GloVe 这类静态词向量有一个先天缺陷:一个词不管出现在哪,向量固定不变。"苹果"在"我吃了个苹果"和"苹果发布了新手机"里意思完全不同,但静态向量给的是同一个——它只能取两种意思的某种平均,两边都不像。
NLP 领域为此奋斗了多年(给每个词做词义标注、分别训练),收效有限。真正的解法来自架构革命:上下文向量。大模型里,token 先经过嵌入层得到一个"底版"向量,然后穿过几十层 Transformer(第 3.3、4 章),每一层都根据上下文动态调整它。走出网络时,"苹果"在水果语境和公司语境里已经是两个相距很远的向量。
这就是为什么说从静态到上下文是大模型理解力的地基:歧义消解不再是一个单独的步骤,而是被吸收进端到端的表示计算里。
⚠️ 常见误解:以为词向量表是模型的核心知识库。其实嵌入层只是入口走廊——真正重的语义理解发生在后面的 Transformer 层对上下文的动态建模中。证据之一:你可以把模型的嵌入层换成随机初始化再微调,损失能恢复;但把中间层打乱,模型立刻废掉。
四、完整的入口流水线
把本节内容串成一条管线,它就是每个大模型处理输入的第一段路:
原始文本 → 规范化(统一全半角、清理乱码、unicode 归一化) → 分词器切成 token 序列(BPE / SentencePiece) → 查嵌入表得到向量序列(批次 × 序列长 × 维度) → (加上位置编码,第 3.3 节) → 进入 Transformer 层
第 5 章讲数据清洗时会回到第一步(规范化做得不好,分词器会产生大量垃圾 token);第 7 章讲成本时会回到 token(API 按 token 计费、上下文窗口按 token 计容量)。入口虽小,影响贯穿全书。
常见问题
问题:token 就是词吗?
不完全是。英文一个词可能被切成多个 token(长词、生僻词),中文高频词是一个 token、低频词可能被切成字或字节。判断"一段文本消耗多少 token"要用具体模型的分词器实际数,不能按词数估。
问题:词向量维度多少合适?维度越高越好吗?
主流模型 2000 到 8000 维。维度高容量大,但参数与计算随之增长;经验上维度要与其他规模成比例增长(第 4 章规模定律)。孤立地比维度没有意义。
问题:大模型还有必要单独学 word2vec 吗?
建议理解思想即可,不必实操。它的"上下文相似则向量相近"原则以更深的形态活在每个大模型里;直接学嵌入层加 Transformer 的版本更贴近当下。
五、亲手数一次 token
纸上得来终觉浅。花十分钟做这个小实验,token 的所有抽象概念都会落地:找一段两百字左右的中文说明文,对照你的输入法或任意公开的 tokenizer 演示页面(各大模型厂商的文档里通常都有计数工具),数一数它被切成了多少个 token;再把同样内容的英文翻译版数一遍。
你会观察到几个值得记住的现象:其一,中文的 token 数通常明显多于英文(早期词表尤其严重,一个汉字两个 token 的情况并不少见),同样的业务含义,中文用户的接口成本更高——这也是评估服务成本时必须用自己语言实测的原因。其二,专有名词、生僻词会被切碎("深度学习"可能是一个 token,某个罕见的人名可能是五六个),高频与低频词的待遇差异极大。其三,数字的切分方式各模型不同,有的三位一组、有的逐位切——这对处理编号、金额的精度有实际影响。
再进一步:把文本里的标点全删后重新计数,看看 token 数变化——你会直观感受到预处理规范化的价值,一次全角半角混乱就能让 token 数膨胀百分之几。第 5.1 节数据清洗的每一条规则,最终都落在这类细节上。
常见追问:为什么不让模型直接看字符?
字符级输入看似"无损"(任何词都能表示),代价是序列极长——同样一段话的字符数是子词数的好几倍,而注意力的开销随序列长度平方增长(第 3.3 节),加上长序列让模型更难捕捉跨越几十个位置的词组语义。子词分词是"表示能力与序列长度的最优折中",它让高频概念占据一个位置、生僻内容退化为多位置组合,两头的效率都被照顾到。这个"折中"思想在 Token 设计之外也反复出现,是工程设计的通用智慧。
再追问:不同模型的分词器不兼容会带来什么问题?
三个实际影响:迁移提示词时效果衰减(为甲模型调优的提示词,在乙模型的分词下是另一串 token 序列);训练数据不能直接复用(要用目标模型的分词器重新处理);成本估算失真(不同分词器的 token 效率差百分之几十很常见)。所以任何"换模型"的评估,第一步是确认新模型的分词效率——这是最容易被忽略、又最容易量化的迁移成本。
最后一问:词向量技术还在演化吗?
在演化,方向是从"静态查表"走向"上下文化的深度融合"——现代模型的嵌入层越来越薄,语义理解越来越依赖层间的动态计算(正文说过),同时检索专用的嵌入模型在对比学习的推动下快速进步(第 9 章 RAG 的受益者)。对你而言的实操结论:不要花太多时间精读 word2vec 的实现细节,理解"语义成为几何"的思想即可,重心放在现代嵌入模型的选型与使用上。
补记:术语对齐
本章术语在不同语境有别名,对齐一下:token 也叫词元或子词,分词器也叫 tokenizer,词向量也叫嵌入或 embedding,上下文向量也叫动态表示。读不同来源资料时对不上号,多数是别名问题——这份对齐表值得留在手边,直到术语成为本能。
本节要点回顾
本节要点回顾
- 分词把文本切成 token;大模型用子词分词(BPE/SentencePiece),词表 3 万–15 万,平衡覆盖与开销。
- 词表大小是工程取舍:大词表省 token、费参数;中文 token 效率直接影响成本。
- 词向量是可学习的查找表,语义相近则向量相近,语义关系成为向量运算——RAG 检索的地基。
- 静态向量一词一向量,无法处理歧义;大模型用上下文向量,歧义消解被吸收进端到端计算。
- 嵌入层只是入口,重活在 Transformer 层;入口流水线(规范化→分词→嵌入→位置编码)贯穿全书后面多个话题。
有了向量序列,下一节看第一代消化它的模型:循环网络——以及它们留给历史的两个未解难题。