3.2 循环神经网络:RNN、LSTM 与 GRU
3.2 循环神经网络:RNN、LSTM 与 GRU
本节摘要:在 Transformer 之前,处理序列的主力是循环神经网络(RNN)。本节讲 RNN 的逐步循环结构、它被梯度消失卡住的长程依赖问题、LSTM/GRU 用门控做的补救,以及它们最终退场的真正原因——串行计算无法并行扩展。理解这一节困境的深度,才能理解下一节 Transformer 胜利的分量。
学习目标
阅读完本节,你应当能够:
- 写出 RNN 的循环更新式并解释隐藏状态的含义
- 解释沿时间的梯度消失如何导致长程依赖失败
- 描述 LSTM 三个门与细胞状态的作用,说明它为什么能缓解梯度消失
- 对比 GRU 与 LSTM 的取舍
- 说清 RNN 系列退场的两个结构性原因
一、RNN:按时间步循环
有了 3.1 的向量序列,下一个问题是:怎么建模"词与词的先后关系"?2014 年前后的答案是循环:每读一个 token,把当前输入和上一步的隐藏状态一起算出新隐藏状态。
h_t = tanh(W_h · h_{t-1} + W_x · x_t + b)
h 是隐藏状态——一个被反复改写的"记忆便签"。读第 1 个词时写下一些信息,读第 2 个词时在便签上增改,一路读到底,便签里压缩了整句话的信息,最后拿它做分类或预测。
这个设计在当年相当优雅:一套权重从头用到尾(参数共享),序列多长都能处理(天然变长),还能双向读(BiLSTM 正反各读一遍)。2013 到 2017 年,机器翻译、语音识别、命名实体识别的最好成绩几乎全部由 LSTM 家族保持。
二、致命问题:记不住句首的词
RNN 的隐藏状态是个不断被覆盖的便签,问题就出在"覆盖"。两个具体的失败场景:
场景一(容量):"把刚才第三句里提到的那个客户的订单金额改成正数"——指令需要回溯很远的指代。隐藏状态维度有限,一路上每个新词都在挤占旧信息的位置,读到句尾,句首的内容早就被冲掉了。
场景二(梯度):训练时,损失对第 1 步参数的梯度要沿时间步一路连乘传回去(2.3 节的链式法则在时间维度上展开)。若每步的局部导数普遍小于 1,连乘几十项后梯度指数级趋零——第 1 步的参数收到的学习信号约等于零,模型知道该记句首,却没有能力学会记句首。这就是梯度消失导致的长程依赖问题。导数大于 1 时则指数级放大,即梯度爆炸,训练数值直接崩掉(这个反而好治:梯度裁剪)。
一个手算就能感受的例子:每步梯度保留 0.9,100 步后剩 0.9^100 ≈ 0.00003——信号基本归零。换成保留 1.1,则是 1.1^100 ≈ 13781 倍——训练爆炸。维持连乘 100 次还落在合理区间,需要每一步都恰好接近 1,这个条件苛刻到难以自然满足。
三、LSTM:给记忆装上门
1997 年提出的 LSTM(长短期记忆网络)用了二十年被证明是最有效的药方。核心设计:不再让信息裸奔地穿过重复变换,而是修一条细胞状态的"信息传送带",再用三个门控制传送带上的进出:
- 遗忘门:决定传送带上哪些旧信息该清掉(读新段落时忘掉上一段的临时指代)。
- 输入门:决定哪些新信息值得写上传送带。
- 输出门:决定传送带上的哪些内容此刻要读出到隐藏状态。
"门"的实现是 sigmoid 函数(2.2 节的旧相识):输出 0 到 1 的系数,逐维度地对信息做"通过比例"的调节——0 是全关,1 是全开,中间是部分放行。
LSTM 门控结构透视
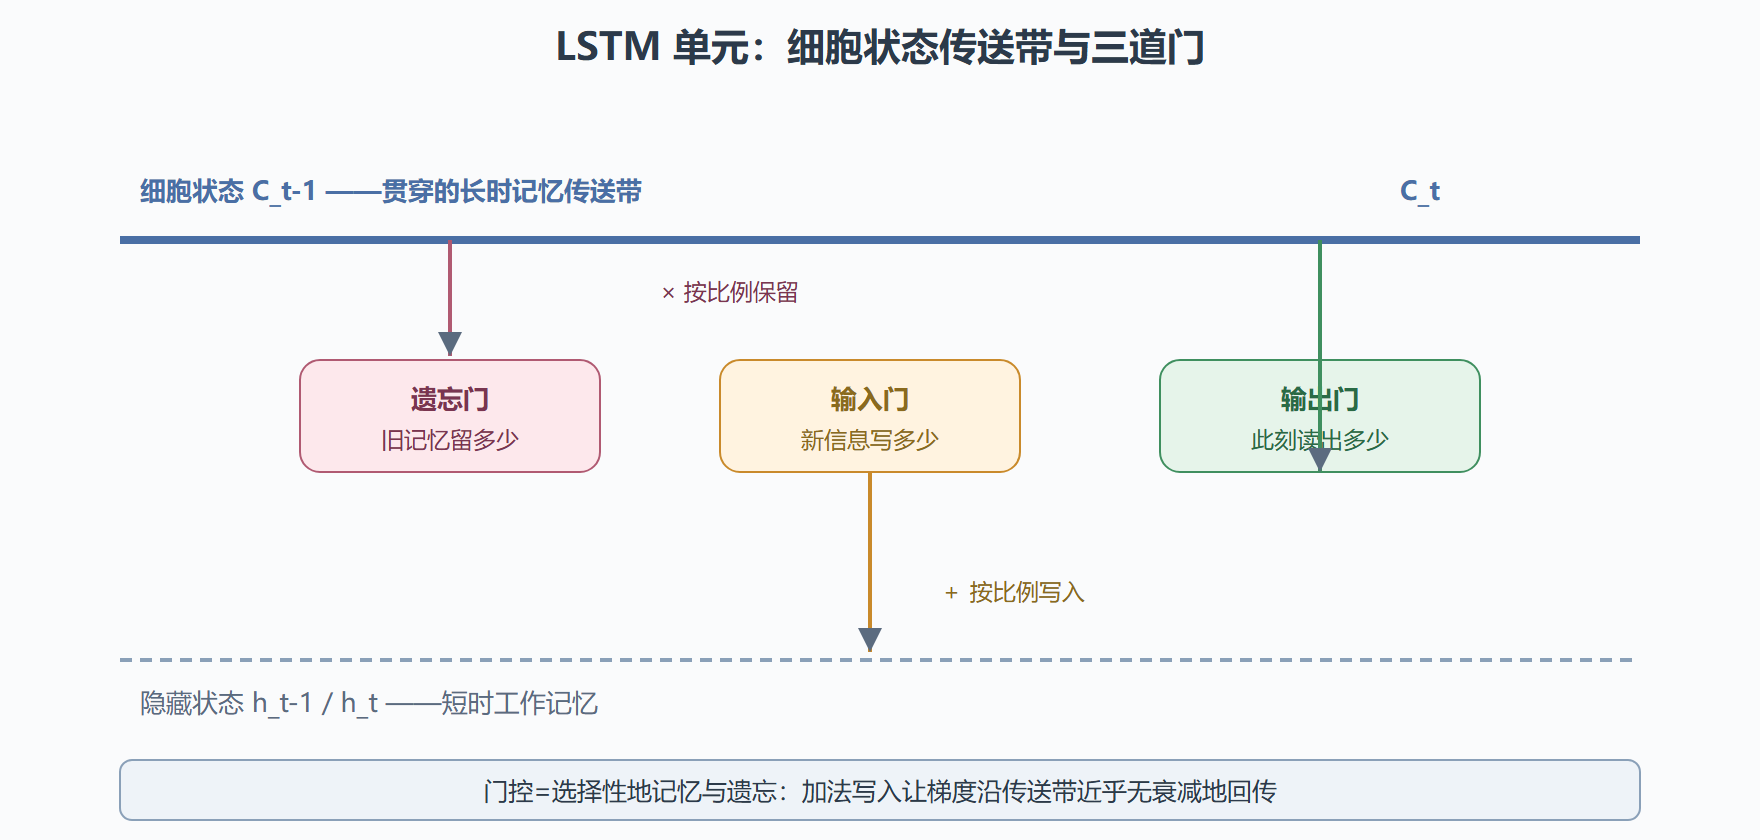
为什么门控能救梯度?关键在加法。原始 RNN 的更新是乘法串联(连乘衰减),而 LSTM 的传送带更新是 C_t = 遗忘门 × C_{t-1} + 输入门 × 新信息——只要遗忘门接近 1,梯度沿加法分支几乎无衰减地一路传回第 1 步(和 2.2 节残差连接是同一个数学思想,两处独立发明)。工程效果:LSTM 能稳定捕捉上百步的依赖,撑起了机器翻译的黄金年代。
GRU(门控循环单元)是 2014 年提出的简化版:三道门合并成两道(更新门、重置门),去掉独立的细胞状态。参数少约四分之一、训练更快,多数任务效果与 LSTM 相当,当年成为"性价比之选"。
| 模型 | 门数 | 参数量 | 长程能力 | 定位 |
|---|---|---|---|---|
| RNN | 0 | 最少 | 差 | 教学原型 |
| LSTM | 3 | 多 | 强 | 二十年主力 |
| GRU | 2 | 中 | 接近 LSTM | 轻量替代 |
💡 门控思想的余音:不是所有信息都值得同等对待,"该忘的忘、该记的记"这种选择性机制,后来在注意力的加权汇聚、甚至混合专家(MoE)的稀疏激活里反复回响。读懂一个门,等于读懂一族设计。
四、退场的真正原因:不是不够聪明,是跑不快
LSTM 已经解决了长程依赖的大部分问题,那它为什么还是被淘汰了?答案是 2017 年之后决定性的新约束:规模。
RNN 系列有一个无法用药方治愈的结构硬伤——串行。第 t 步的隐藏状态依赖第 t-1 步的结果,必须逐步顺序计算,无法并行。GPU 的算力再多,也只能干等当前步算完。序列长 1000,就串行 1000 步;想训更大模型、更长文本,训练时间线性甚至更糟地增长。当研究者的目标从"百万参数"变成"千亿参数",串行结构直接宣判了出局。
此外,虽然门控缓解了梯度问题,但信息通路仍是"逐步传递"式的——第 1 个词要影响第 100 个词,还是要走 99 步的接力;而注意力让两者一步直连。
所以 3.3 节 Transformer 的两大卖点——全并行(矩阵乘法吃满 GPU)与任意距离一步直连——恰好是对本节两大死穴的精确回应。历史线非常干净:不是 LSTM 做错了什么,而是任务的目标函数变了——从"在给定算力下做得更好"变成"把给定模型规模训得动"。
常见问题
问题:LSTM 今天完全没用了?
没有。在小数据、边缘设备、流式信号(传感器、股票 tick)等场景,轻量的 GRU/LSTM 仍是务实选择——它们参数少、按步推理内存恒定,适合单条序列持续更新的场景。被淘汰的是"作为大模型地基"这个位置。
问题:RNN 的思路后来有回归吗?
有。近年一些线性注意力与状态空间模型(如 Mamba 一类)以并行训练、递归推理的混合形态复活了"循环"思想,试图兼得 Transformer 的训练效率与 RNN 的推理常量内存。这印证了本节的判断:串行本身不是罪,训练期无法并行才是。
问题:双向 RNN 是什么?
正序读一遍、逆序读一遍,两个方向的隐藏状态拼接。它让每个位置同时看到左右上下文,用于理解类任务(如 BERT 的前身编码器),但不能用于生成——生成时右边的词还不存在。这个"单向/双向"的分野将在第 4 章升级为解码器/编码器架构之别。
五、一条被验证过的时间线
把循环网络的兴衰放进时间轴,能看到技术演化的典型节奏,这条节奏线在本教程后面还会重演:
九十年代,梯度消失让循环网络停留在玩具阶段;一九九七年长短期记忆网络提出,门控思想让它第一次能处理百步依赖,但受限于数据和算力,影响力局限在语音等窄领域。二零一零年代中期,大 语料与 GPU 到位,LSTM 迎来黄金五年——机器翻译、语音识别、命名实体识别的最好成绩全部姓 LSTM,工业级应用遍地开花。二零一七年 Transformer 问世,循环网络在两年内从王座跌落——不是它做错了什么,而是任务目标从"给定算力做好"变成了"把大模型训得动"。
这条时间线的三个启示值得带走:技术方案的寿命取决于问题环境,不取决于方案本身的优雅,LSTM 的门控设计至今仍在被借鉴;新范式取代旧范式时,淘汰顺序从最吃规模的场景开始,机器翻译这种数据巨大的任务最先迁移,小数据任务晚得多;"过时"不等于"无用",今天在端侧设备、流式信号处理上,轻量循环结构依然是务实选择。
读第 3.3 节时不妨带着这个背景:注意力不是从天而降的天才发明,而是站在循环网络两 大痛处的肩膀上——理解前者的困境有多深,才能理解后者的方案有多准。
常见追问:既然被淘汰,为什么还值得学?
三个理由。其一,面试高频——"为什么 Transformer 取代 RNN"几乎必考,答案的品质取决于你对旧困境的理解深度。其二,思想传承——门控的"选择性"活在注意力的加权里,加法通路救梯度的设计活在残差连接里,读懂 RNN 时代就等于读懂了这些设计的动机。其三,现实应用——流式信号、端侧轻量场景里循环结构仍在服役。技术史不是废纸堆,是理解现在与预判未来的参照系。
再追问:LSTM 的经验对理解现代模型还有什么用?
至少三处直接迁移:门控的"选择性通过"思想,帮助理解注意力里 softmax 权重的意义(都是"按比例放行信息");细胞状态的"传送带加加法更新",与残差连接同构,帮你理解为什么加法通路能保梯度;训练 LSTM 时代积累的超参直觉(学习率敏感、梯度裁剪保命),在大模型训练里原样适用。学旧技术时有意寻找"它活在新技术里的那部分",是提高学习复用率的关键习惯。
最后一问:还有必要跑一次 LSTM 实验吗?
有余力值得做一次——不是为简历,而是为体感:跑一个百级别参数的玩具 RNN 看它背短句,再看它在长句上崩溃,那种"亲眼看着梯度消失"的体验,比读十遍原理更牢固。半天即可完成,用任何主流框架的教学示例都能搭起来。做完这个实验再读注意力论文,你对"革命"二字的理解会完全不同。
补记:一个常用的快速类比
如果要用一个物理画面记住循环网络家族:隐藏状态像一条传送带上不断被增删货物的箱子——原始 RNN 每站都粗暴重装(旧货易丢),LSTM 配了仓管员按单据(门控)决定留什么卸什么。这个画面不精确,但足以让你在任何讨论中快速定位"门控在哪、梯度为何能存活"两个关键点。精确机制回到正文公式,画面只负责快速索引。
本节要点回顾
- RNN 用隐藏状态逐步循环处理序列,参数共享、天然变长,曾是序列建模主力。
- 梯度沿时间连乘导致指数衰减/爆炸:长程依赖是结构性失败,不是调参能救的。
- LSTM 用细胞状态传送带 + 三道门(遗忘/输入/输出)实现选择性记忆,加法更新让梯度近乎无衰减回传;GRU 是轻量版。
- 门控 = 选择性思想,在后续注意力、MoE 中反复重现。
- 退场原因:串行无法并行 + 规模化时代训练成本不可接受——Transformer 的两大卖点正是对这两点的精确回应。
下一节,看注意力如何一步直连所有位置、把序列建模搬到矩阵乘法上——大模型时代的大门在此打开。