3.3 注意力机制与 Transformer 架构
3.3 注意力机制与 Transformer 架构
本节摘要:2017 年一篇题为"注意力就是你所需要的一切"的论文,把序列建模从循环搬到了矩阵乘法上。本节用查字典的直觉讲清 Query/Key/Value 自注意力,解释它的两大革命性(全并行、任意距离一步直连),再引入多头、位置编码,最后组装出 Transformer 层——所有大模型共用的那块积木。
学完你能
阅读完本节,你应当能够:
- 用 Query/Key/Value 三元组描述一次注意力的完整计算
- 解释缩放点积注意力里除以根号 d 的原因
- 说明自注意力的两大革命性及其对应 RNN 的两大死穴
- 解释多头注意力与位置编码各自解决什么问题
- 画出 Transformer 层的结构并说明每个组件的作用
软性查字典:注意力让模型自己决定看哪里
先回到 RNN 留下的困境:信息要逐步接力,远处的影响传不动。换个思路——与其让信息接力,不如让每个位置直接看一眼全句,再决定从谁那里取多少信息。这就是注意力。
直觉用"软性查字典"最贴切。普通字典:拿查询精确匹配一个键,返回一个值。注意力字典:拿查询和所有键算相似度,得到一组权重,返回所有值的加权平均。相似度高的键贡献多,低的贡献少——"软"体现在不非此即彼,而是按相关程度分配。
三个角色,每个词各有一份:
- Query(查询):当前词发出的"我在找什么"。
- Key(键):每个词挂出的"我能提供什么"标签。
- Value(值):每个词真正携带的信息内容。
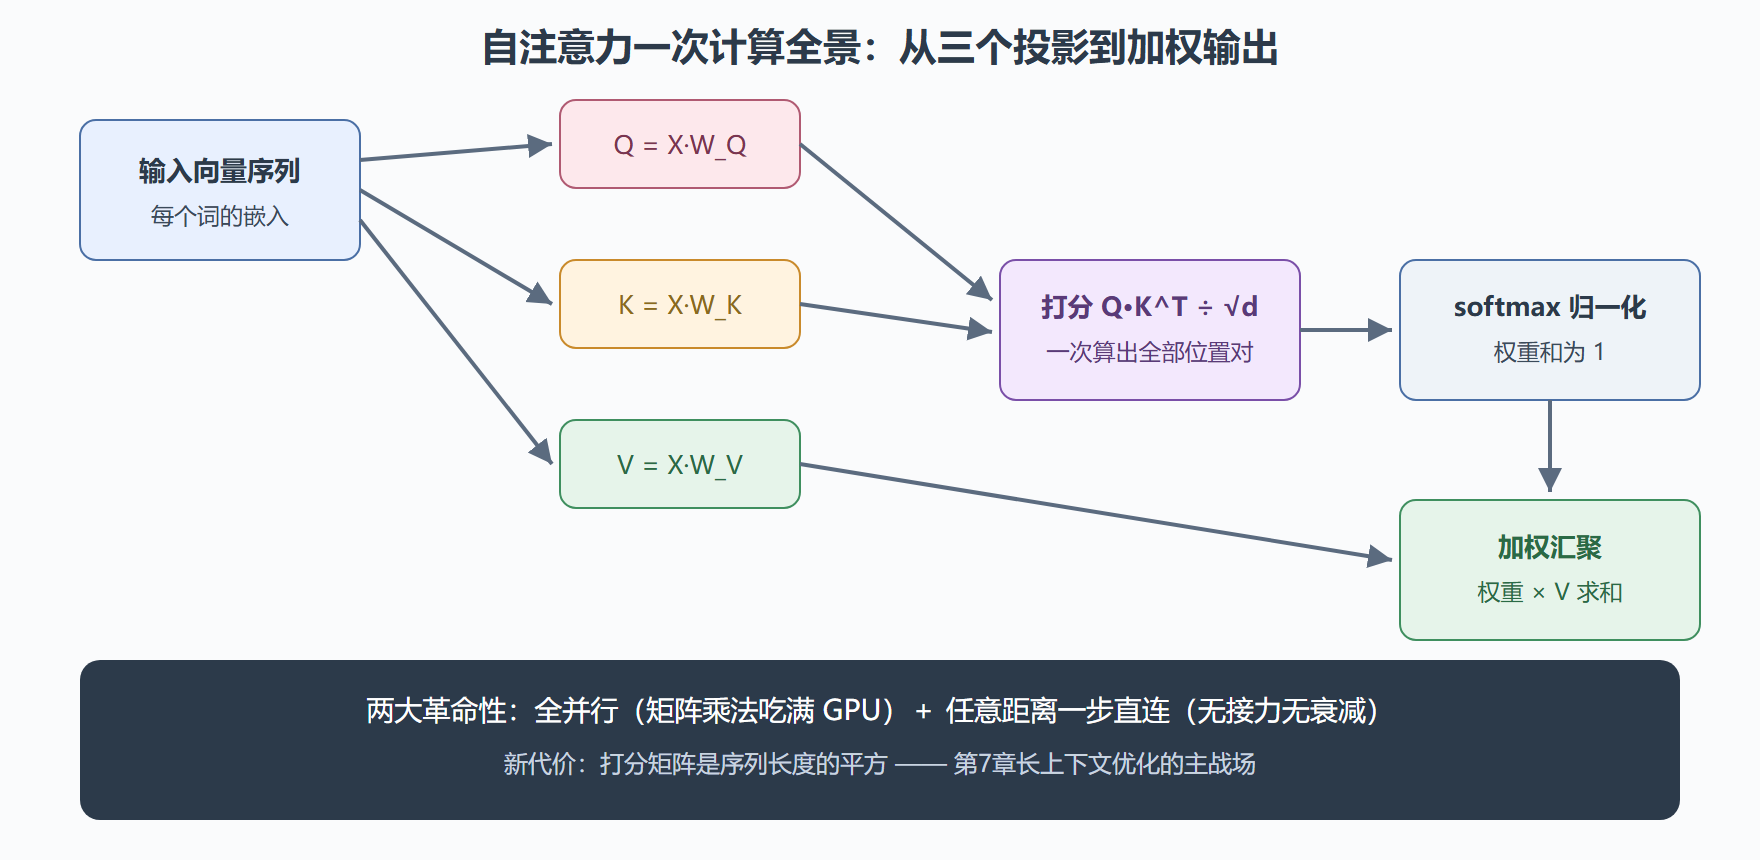
一次完整计算分四步:
1. 相似度:Q 与每个 K 做点积 → 打分 2. 缩放: 打分 ÷ √d(d 为 Key 维度) → 防止打分过大 3. 归一: 对打分做 softmax → 权重和为 1 4. 汇聚: 权重 × 各 V 加权求和 → 输出
写成一行就是注意力公式:Attention(Q, K, V) = softmax(Q·K^T / √d)·V。第 2 步的缩放最常被问:点积是 d 个乘积之和,维度高时数值容易过大,softmax 对大数值极敏感(会变成一家独大的硬选择,梯度消失),除以 √d 把打分方差拉回稳定区间——一个为了训练稳定性的小而关键的补丁。
二、自注意力:并行的、一步直连的
"自"注意力指 Q、K、V 全部来自同一个序列自身——每个词的向量分别乘三个可学习的投影矩阵 W_Q、W_K、W_V,得到它的查询、键、值三个分身。序列自己和自己做软查字典。
它对 RNN 两大死穴的回应精确到像回声:
全并行。 所有位置的注意力计算拼成一次大矩阵乘法(Q·K^T 一次算出所有位置对的打分),GPU 数千核心同时开工。RNN 的 1000 步串行,在这里是一步矩阵运算。训练吞吐量的差距以数量级计——这是千亿参数模型"训得动"的前提。
任意距离一步直连。 第 1 个词和第 1000 个词的交互是一次点积,不经过任何接力。梯度回传也没有长连乘链(每层内部注意力路径很短),梯度消失的旧病从结构上根除。
当然没有免费的午餐:注意力的打分矩阵大小是序列长度的平方——序列翻倍,计算与显存翻四倍。这个平方开销是 RNN 没有的新税,它催生了第 7 章的长上下文优化(KV 缓存、稀疏注意力),也是当前上下文窗口从几千推到几十万的主要工程战场。
自注意力计算全景
三、多头注意力:一组投影看一种关系
单组 QKV 只能学一种"关注模式"。但语言里的关系是多维的:语法依存(主谓一致)、语义关联("它"指代谁)、位置习惯(相邻词搭配)……一组投影顾不过来。
多头注意力的解法直截了当:把 Q、K、V 各自拆成 h 组(如 32 个头,每组维度为原维度的 1/32),每组独立做一遍完整的注意力,最后把各头输出拼接、过一个输出投影矩阵合回来。每个头在训练中自发分工,有的盯句法、有的盯指代、有的干脆主要看相邻位置——没有人给它们指定任务,分工是从数据中涌现的。
这是"分而治之再融合"的经典模式,代价是参数量约等于一个大单头(不是乘以头数——因为每组维度同比缩小),性价比极高。后来的可解释性研究(观察各头的注意力热图)也依赖多头结构——第 10 章可解释性话题会再提到。
四、位置编码:把顺序补回来
自注意力有一个隐藏副作用:它对输入顺序完全无感。"猫追狗"和"狗追猫"在纯注意力眼里打分一样——因为 Q·K 只看内容不看位置。而顺序对语言显然要命。
补丁是位置编码:给序列里每个位置一个向量,加到词向量上,让"第 5 个位置的猫"和"第 8 个位置的猫"向量不同。原始论文用固定的正弦/余弦函数(不同频率的波,像给每个位置发一张独一无二的"坐标身份证");后来的模型多改用可学习的位置嵌入;再后来旋转位置编码(RoPE)成为主流——它把相对位置信息编进注意力的打分里,外推到更长序列的性质更好(第 7 章长上下文的另一块基石)。
五、组装 Transformer 层
零件齐了,组装。一个标准 Transformer 层:
各组件分工一句话版:多头注意力负责"词与词交换信息"(混合),前馈网络(FFN,两层矩阵乘法夹一个 GELU,通常先把维度扩 4 倍再压回)负责"每个位置独立深加工"(变换)。有研究认为 FFN 承担了大量事实记忆的功能。残差与 LayerNorm 是 2.2 节讲过的深网络稳定器,缺一不可。
把这样的层堆叠几十上百次,就得到 Transformer——GPT、BERT、LLaMA、GLM 无一例外,差别只在堆多深、每层多宽、以及编码器/解码器取向(第 4 章的主题)。2017 年那篇论文的标题没有夸张:注意力之外,其余都是已有零件的成熟组装。
⚠️ 常见误解两则:其一,以为自注意力"只看前面的词"。纯自注意力是双向的,看全句;GPT 类生成模型才用因果掩码把它限制成只看前文——在 softmax 前把未来位置的打分设为负无穷即可实现。掩码与否,正是第 4 章编码器与解码器架构的分水岭。其二,以为注意力权重就是解释。权重高不等于因果重要,热图可作参考但不能当证据——这是第 10 章可解释性的核心警告。
常见问题
问题:注意力头的数量和维度怎么定?
头的维度通常取 64 或 128,头数 = 隐藏维度 ÷ 头维度。例如 4096 维、128 头。头数与层数、宽度一起按规模定律整体缩放(第 4 章),不是独立自由调节的旋钮。
问题:既然注意力平方开销大,为什么不用滑动窗口限制每个词只看邻居?
窗口注意力确实存在(长文本模型常用),但它牺牲长程直连性,属于"局部便宜、全局贵"的折中。当前主流做法是混合:底层看局部、高层看全局,或用 KV 缓存降低推理成本。详见第 7 章。
问题:BERT 和 GPT 都是 Transformer,区别在哪?
主要是掩码方向:BERT 用双向注意力做理解(完形填空式预训练),GPT 用因果掩码做生成(逐词预测式预训练)。这一分岔的完整故事在第 4 章展开。
六、一张公式的完整解剖
把注意力公式 softmax(Q·K^T / √d)·V 逐符号过一遍,作为本节的收束。建议拿纸笔跟着走一遍小例子,走完这个公式对你就是"自己的"了:
Q·K^T:查询矩阵乘键矩阵的转置,得到一个"序列长乘序列长"的打分表,第 i 行第 j 列是"第 i 个词对第 j 个词的关注度原始分"。注意这一步的输出尺寸与序列长度平方成正比——第 7.1 节 KV 缓存与注意力优化的全部讨论,源头就在这个尺寸上。
÷ √d:d 是每个头的维度(如 64)。点积是 d 个乘积之和,维度越高数值越大,softmax 会饱和成一家独大、梯度消失。除以根号 d 把方差拉回稳定区间——一个小补丁,救了整个训练的稳定性。
softmax:对打分表的每一行做归一化,变成"第 i 个词把注意力按什么比例分给各个词"的权重表,每行和为一。因果掩码就施加在这一步之前——把未来位置的打分设为负无穷,softmax 后权重即为零,模型"看不到未来"。
乘 V:用权重表对值矩阵做加权求和,第 i 行输出是"全序列信息按注意力比例的混合"。每个词的新表示由此诞生。
四个步骤,每一步都只是矩阵乘法、逐元素运算和一个归一化——没有超出第 2 章的数学。大模型的秘密不在数学的深度,而在结构的组合方式。下一章我们把这颗积木堆成高楼。
常见追问:注意力权重能当作"模型在看哪里"的证据吗?
只能当线索,不能当证据。权重高不代表因果上重要(打分高但内容可能未被后续真正使用),且同一输入的权重分布会随训练随机性变化。可解释性研究的共识是:单看注意力热图容易得出误导性结论,严谨的做法要配合干预实验(改动某个输入观察输出变化)。这个提醒在第 10 章的可解释性讨论中会正式展开——对"模型解释"保持审慎,是这一领域的基本素养。
再追问:自注意力的平方开销,具体在哪个数字上体现?
算一笔账:序列长一千时,打分矩阵是一千乘一千即一百万个元素;序列长一万时变成一亿——十倍长度、百倍开销。这就是上下文窗口从四千扩到十二万,工程难度跨越数个量级的原因,也是第 7 章种种优化(稀疏、分页、缓存压缩)轮番上阵的战场。记住"平方"这个词的分量,你在长上下文相关的成本讨论里就不会被任何宣传话术绕晕。
最后一问:读原始论文有必要吗?
强烈推荐读一次那篇奠基论文——不是为了赶时髦,而是检验本章成果:如果通读下来发现"每一步都能看懂、只是符号更密集",说明本章目标达成;如果某段卡壳,卡点恰好指向你该回复习的小节。这篇论文是检验第 2、3 章学习的天然试金石,也是你通向第一手文献的第一级台阶。
本节要点回顾
- 注意力 = 软性查字典:Q 找、K 标、V 装货;打分 → 缩放(÷√d 稳数值)→ softmax → 加权汇聚。
- 自注意力两大革命:全并行(回应 RNN 串行)与任意距离一步直连(回应长程依赖);新代价是平方级开销。
- 多头 = 多组投影分工多种关系;位置编码补回顺序信息(正弦 → 可学习 → RoPE)。
- Transformer 层 = 多头注意力(混合)+ FFN(变换)+ 残差/LayerNorm(稳定),层层堆叠即大模型骨架。
- 因果掩码把双向注意力改造成"只看前文"的生成模型——编码器/解码器分野的开关。
积木到手。第 4 章用它搭出真正的大模型:三大架构流派、规模定律、以及那些改变行业格局的名字。