4.1 Transformer 模型深入解析
4.1 Transformer 模型深入解析
本节摘要:第 3 章讲清了注意力这块积木,本节把它们组装成一台完整的大语言模型:从 token 进来到概率分布出去的完整数据流、位置编码的演化、FFN 为什么占参数大头、残差与归一化的工程变体,最后算一笔"千亿参数到底存在哪"的明细账。读懂这笔账,第 6 章的参数高效微调与第 7 章的推理优化才有着力点。
学完你能
阅读完本节,你应当能够:
- 完整描述大模型从 token 到输出分布的五步数据流
- 说出位置编码三代方案(正弦、可学习、RoPE)的演化逻辑
- 解释 FFN 的结构与它承担的功能假设
- 说明 Pre-LN、RMSNorm 相对原始设计的改进
- 手算一个中等规模模型的参数量分布
一、从 token 到输出:完整数据流
一个大语言模型处理一段输入的完整路径只有五步,没有任何隐藏环节:
1. 分词:文本 → token id 序列 2. 嵌入:查嵌入矩阵 → 向量序列,加位置编码 3. 主体:连续通过 N 层 Transformer(每层 = 掩码多头注意力 + FFN,各带残差与归一化) 4. 出口投影:最后一层的向量 × 输出矩阵(与嵌入矩阵常常共享权重)→ 词表维度打分 5. softmax:打分 → 下一个 token 的概率分布
第 3 步是主体,前两步与后两步是入口和出口。值得建立的一个空间感:整个过程中张量形状基本不变(批次 × 序列长 × 隐藏维度),变的是内容——同一个位置的向量从"词的底版"逐层演化成"融合了全句语境、可预测下一个词"的深层表示。第 3.1 节说的"上下文向量",就是在这几十层的演化中被逐步塑形的。
Transformer 模型分层透视
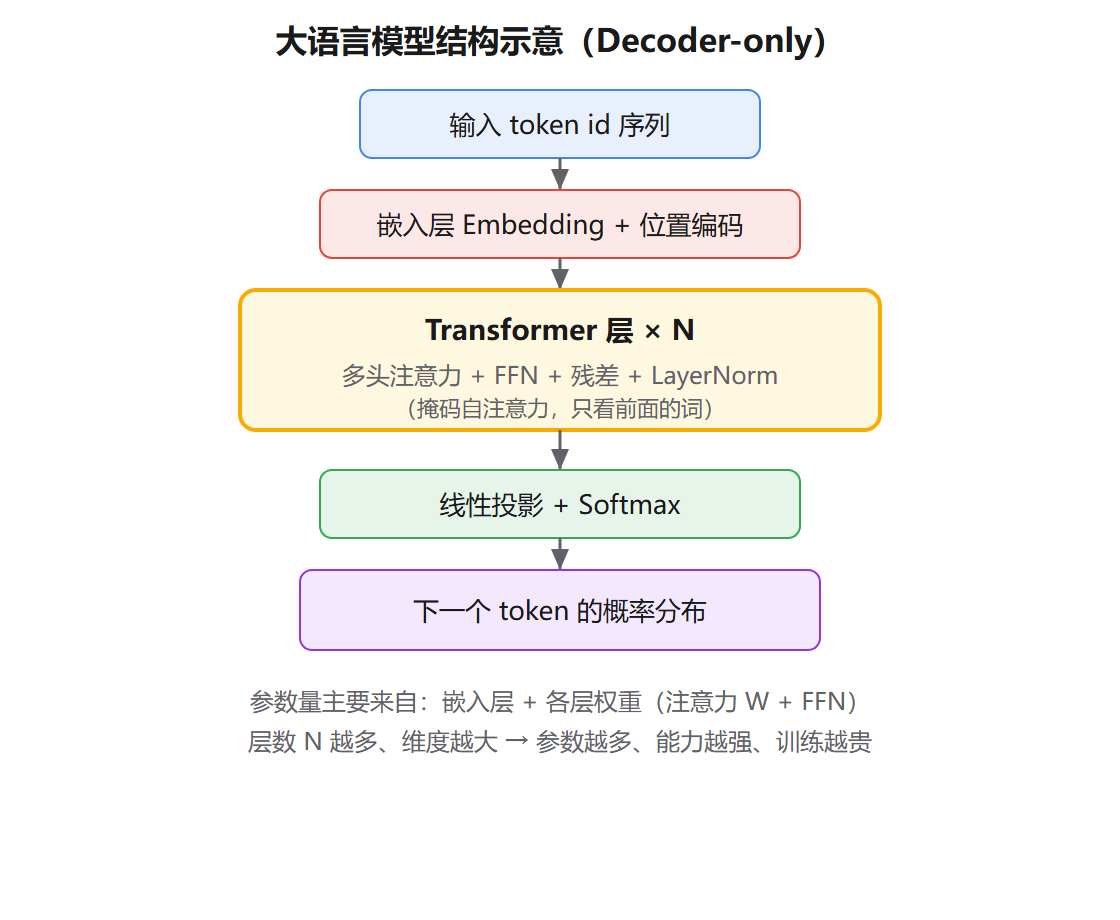
上图把一个典型 decoder-only 模型竖切开来:底部是嵌入与位置信息注入,中部是重复 N 次的 Transformer 层(左半注意力混合信息、右半 FFN 深加工),顶部是输出投影与 softmax。看图时注意两个"同形贯穿"的结构:残差连接的主干(贯穿所有层的加法通道)与归一化层的位置(现代模型把归一化放在子层之前,见下文)。
二、位置编码的三代演化
3.3 节说过自注意力对顺序无感,需要外部注入位置信息。这件事的实现方式演化了三代,每一代都是为了解决上一代在新问题下的不足:
第一代:正弦位置编码(2017)。 用不同频率的 sin/cos 函数给每个位置生成固定向量。优点是无需学习、理论上可外推到训练没见过的长度。缺点是加到嵌入上的方式比较"浅",长序列外推实际效果一般。
第二代:可学习位置嵌入(GPT-2 时代)。 给每个位置一个可训练的向量,像普通参数一样学。效果更好,但长度被训练长度焊死——训练 2048 就只能处理 2048,超出即乱。
第三代:旋转位置编码 RoPE(当前主流)。 思路升级:不再给词向量加位置,而是把相对位置"旋转"进注意力的打分里——两个词的 Q、K 向量按各自位置旋转后再点积,打分自然带上"相差几个位置"的信息。相对位置比绝对位置更贴近语言本质,且配合位置插值等技术,训练 4K 的模型可以扩展到 128K 上下文——第 7 章长上下文优化的数学根基就在这里。
三、FFN:被低估的参数巨头
每个 Transformer 层里,注意力之后紧跟一个前馈网络(FFN):对每个位置独立地做两层变换,中间夹 GELU 激活,典型配置是先把维度扩到 4 倍再压回(例如 4096 → 16384 → 4096)。
功能上,注意力负责"词与词之间横向交换信息",FFN 负责"每个位置纵向深加工自己的表示"——一横一纵,缺一不可。近年可解释性研究给出了更大胆的假设:FFN 的两层结构像一个巨大的键值记忆库(第一层矩阵的行是"模式探测器",第二层的列是被激活后写出的"知识片段"),模型的大量事实性知识(首都是哪里、API 怎么调用)存储在 FFN 权重里。这个假设解释了为什么"知识编辑"技术(修改模型的某个具体事实)大多瞄准 FFN,也再次印证第 3.1 节的提醒:嵌入层只是入口,知识住在层里。
现代变体值得一提:**MoE(混合专家)**把单个大 FFN 换成多个并行的"专家"FFN,每个 token 由路由器只激活其中一两个——总参数量可以做到数千亿,而每次前向只动用一小部分,"容量"与"计算量"解耦。DeepSeek、Mixtral 等模型走的就是这条路,第 10 章会作为架构演进再讨论。
四、残差与归一化:稳定性的工程进化
残差连接(y = x + 子层(x))保证梯度的高速公路(2.2 节),归一化防止数值逐层漂移。这两个保命设计本身也在进化:
- Post-LN → Pre-LN:原始 Transformer 把 LayerNorm 放在子层之后(Post-LN),深了难训,必须小心翼翼配 warmup;把归一化挪到子层之前(Pre-LN),梯度沿残差主干无阻碍地流动,深模型训练稳定得多。现代大模型清一色 Pre-LN 或其变体。
- LayerNorm → RMSNorm:LayerNorm 要减均值再除标准差;RMSNorm 发现减均值那步可以省掉,只做均方根缩放,效果几乎不变、计算更省。主流开源模型已普遍换用。
这一小段演变再次体现本教程的主线:大模型的架构史,一半是注意力的故事,另一半是"怎么让几十层网络数值稳定地训完"的工程史。
五、算一笔参数账
"千亿参数"具体在哪里?以一个 70 亿参数级的 decoder-only 模型为例(隐藏维度 4096、层数 32、词表 32000),逐项估算:
嵌入层: 32000 × 4096 ≈ 1.3 亿(输出投影常共享,不另计) 每层注意力: Q/K/V/O 四个投影 4 × 4096 × 4096 ≈ 6700 万 每层 FFN: 3 × 4096 × 4096 ×(升维系数,若 4 倍则 3×4=12 个等价大矩阵的 1/4……)
用典型系数粗算,单层 FFN 约 2.2 亿、注意力约 0.7 亿——FFN 约占单层参数的四分之三,全模型累计:32 层 × 2.9 亿 ≈ 93 亿,与标称 70 亿量级吻合(实际模型用分组查询注意力等技巧压缩了注意力部分)。结论可以记住:参数大头在 FFN,其次注意力投影,嵌入层反而只占零头(词表 3 万 × 维度 4096 = 1.3 亿,占比不到 2%)。
这笔账后续两章直接复用:第 6 章 LoRA 把低秩适配器插在注意力投影(有时也加 FFN)上,正是因为这里是"可塑性"最划算的入口;第 7 章讲显存占用时,权重规模(70 亿参数 × 2 字节 ≈ 14 GB)决定了量化前一张消费级显卡根本放不下。
⚠️ 常见误区:把"参数多"等同于"每一层都更聪明"。层数、宽度、数据、训练 token 数是联动的——4.3 节的规模定律会说明,给定算力预算下参数与数据存在最优配比,单维度猛堆是浪费。
常见问题
问题:为什么输出投影常与嵌入矩阵共享权重?
两者形状互为转置(词表 × 维度 vs 维度 × 词表),共享可省一大块参数,且让"输入输出用同一套语言"有轻微正效果。部分模型为效果分离两者,属于工程取舍。
问题:层数和宽度,哪个对能力贡献更大?
经验上同等参数量下,深一点略优于宽一点(更长的加工链),但过深受训练稳定性与序列并行效率限制。主流做法是按规模定律整体等比放大,不单维度倾斜。
问题:MoE 的"专家"真的分工明确吗?
部分是。统计上能看到某些专家偏向特定类型 token(数字、代码、标点),但整体分工是训练涌现的,粒度比人想象的粗。它的首要价值是省计算,不是可解释性。
六、用参数账做一次决策
本节的参数账不只是知识,更是决策工具。看两个应用场景:
场景一:选微调方案。团队想微调一个七十亿参数模型,显卡只有二十四 GB 显存。查账:全参数微调要上百 GB(权重加梯度加优化器状态),全参出局;LoRA 只训练千分之一参数,优化器状态随之缩小两个量级,加上量化基座的 QLoRA 方案,二十四 GB 够用——第 6.3 节的结论就是这笔账算出来的。
场景二:评估模型能不能进笔记本。七十亿参数、fp16 精度,权重就要约十四 GB,加上系统开销超出普通笔记本内存;换四比特量化约三点五 GB,加上 KV 缓存的动态开销,一台十六 GB 内存的机器可以流畅运行——第 7.2 节的量化决策同样是这笔账的延伸。
方法论的启示:参数量 × 每参数字节数这个乘法,是大模型工程的第一心算题。见到任何模型规格,先心算三笔账——推理显存(参数 × 精度字节)、训练显存(再乘六到八倍,含优化器)、KV 缓存(随并发与上下文增长)。三笔账在手,绝大多数"能不能跑、要不要买卡"的讨论可以直接终结,不依赖任何记忆的规格表。
常见追问:为什么 FFN 中间层要扩维四倍?
扩维给每个位置提供了更大的"临时工作区"——先把表示投影到高维空间做非线性变换(可以理解为在更多方向上做模式匹配),再压缩回原维度。经验上扩四倍是效果与成本的良好平衡点,成为约定俗成的默认值;部分新架构(如某些 MoE 与现代变体)为省参数改为更小的系数,属于工程微调而非原则变更。记住"四倍是默认、可调"即可,面试与评审中这属于体现知识细度的加分点。
再追问:为什么大模型几乎全是 decoder-only 的堆叠,而不混用编码器?
纯粹工程与生态的结果,而非原理禁令。decoder-only 结构单一,层间形状一致,做深做宽、做并行、做缓存(KV 缓存依赖统一的因果结构)都最顺;混入双向层会让推理路径复杂化,缓存与掩码逻辑都要分支处理。规模时代"简单结构的规模化红利"再次胜过"复杂结构的精巧设计"——这个模式你在三大架构之争里已见过一次,在此再见一次,后面还会遇到。
最后一问:配置表里的隐藏维度、头数、层数,要背吗?
不要背,要会"用规模定律 sanity check":层数乘宽度应与总参数量大致吻合(用 4.1 的参数账验算)、头数乘头维度应等于隐藏维度。掌握这两条验算关系,任何模型发布时你都能在三十秒内判断"这个规格表是否自洽、宣传的参数量是否掺水"——这比记住任何一个具体配置有用得多。
本节要点回顾
- 数据流五步:分词 → 嵌入+位置 → N 层(注意力混合 + FFN 加工)→ 投影 → softmax;张量形状不变,内容逐层演化。
- 位置编码三代:正弦 → 可学习 → RoPE;RoPE 编码相对位置,是长上下文扩展的数学根基。
- FFN 是参数巨头(约占四分之三),且被假设为事实知识的存储地;MoE 用稀疏激活把容量与计算解耦。
- 稳定性进化:Post-LN → Pre-LN,LayerNorm → RMSNorm——深模型可训练的工程保障。
- 参数账:FFN > 注意力投影 >> 嵌入层;这笔账直接通向第 6 章微调入口与第 7 章显存估算。
结构清楚了,下一节看这个结构上最重要的一个自由度——注意力方向——如何分出三大架构家族。