4.2 三大架构:编码器、解码器与编解码
4.2 三大架构:编码器、解码器与编解码
本节摘要:同一个 Transformer,因注意力"能看哪些词"这一个自由度的不同,分出三大家族:双向的编码器(BERT,擅长理解)、单向掩码的解码器(GPT,擅长生成)、两端结合的编解码(T5,擅长转换)。本节讲清三者的结构差异、预训练目标与适用边界,并回答一个行业级问题:为什么 decoder-only 最终统一了大模型江湖。
学习目标
阅读完本节,你应当能够:
- 用注意力方向区分三大架构,并说出各自的代表模型
- 把 MLM、CLM、Seq2Seq 三种预训练目标与架构一一对应
- 解释双向与单向各自的结构代价
- 陈述 decoder-only 胜出的三个理由及其争议
- 为理解、生成、转换三类任务选择合适架构
一个掩码开关分出三族模型
Transformer 的架构差异,浓缩起来就是 3.3 节末尾那个"因果掩码"开关:
- 编码器(Encoder-only):不加掩码,双向注意力——每个词同时看前文与后文。看到完整句子再编码,理解最深。代表:BERT 及其家族。
- 解码器(Decoder-only):加因果掩码,单向注意力——每个词只看自己和前文。天然匹配"从左到右生成"的过程。代表:GPT、LLaMA、GLM、Qwen。
- 编解码(Encoder-Decoder):两段式——编码器双向压缩输入成一组向量,解码器单向自回归地生成输出,并额外通过"交叉注意力"随时回看编码结果。代表:原始 Transformer、T5、BART,以及多数翻译模型。
一个帮助记忆的具体场景,三种架构对"我喜欢苹果,因为它很甜"的处理方式完全不同:编码器一眼看全句,"它"直接绑定到"苹果"(双向的好处);解码器读到"它"时还看不到后面,只能靠前文猜指代(单向的代价);编解码把整句吃进编码器,再让解码器逐词产出摘要或译文(两段式)。
三大架构对比矩阵
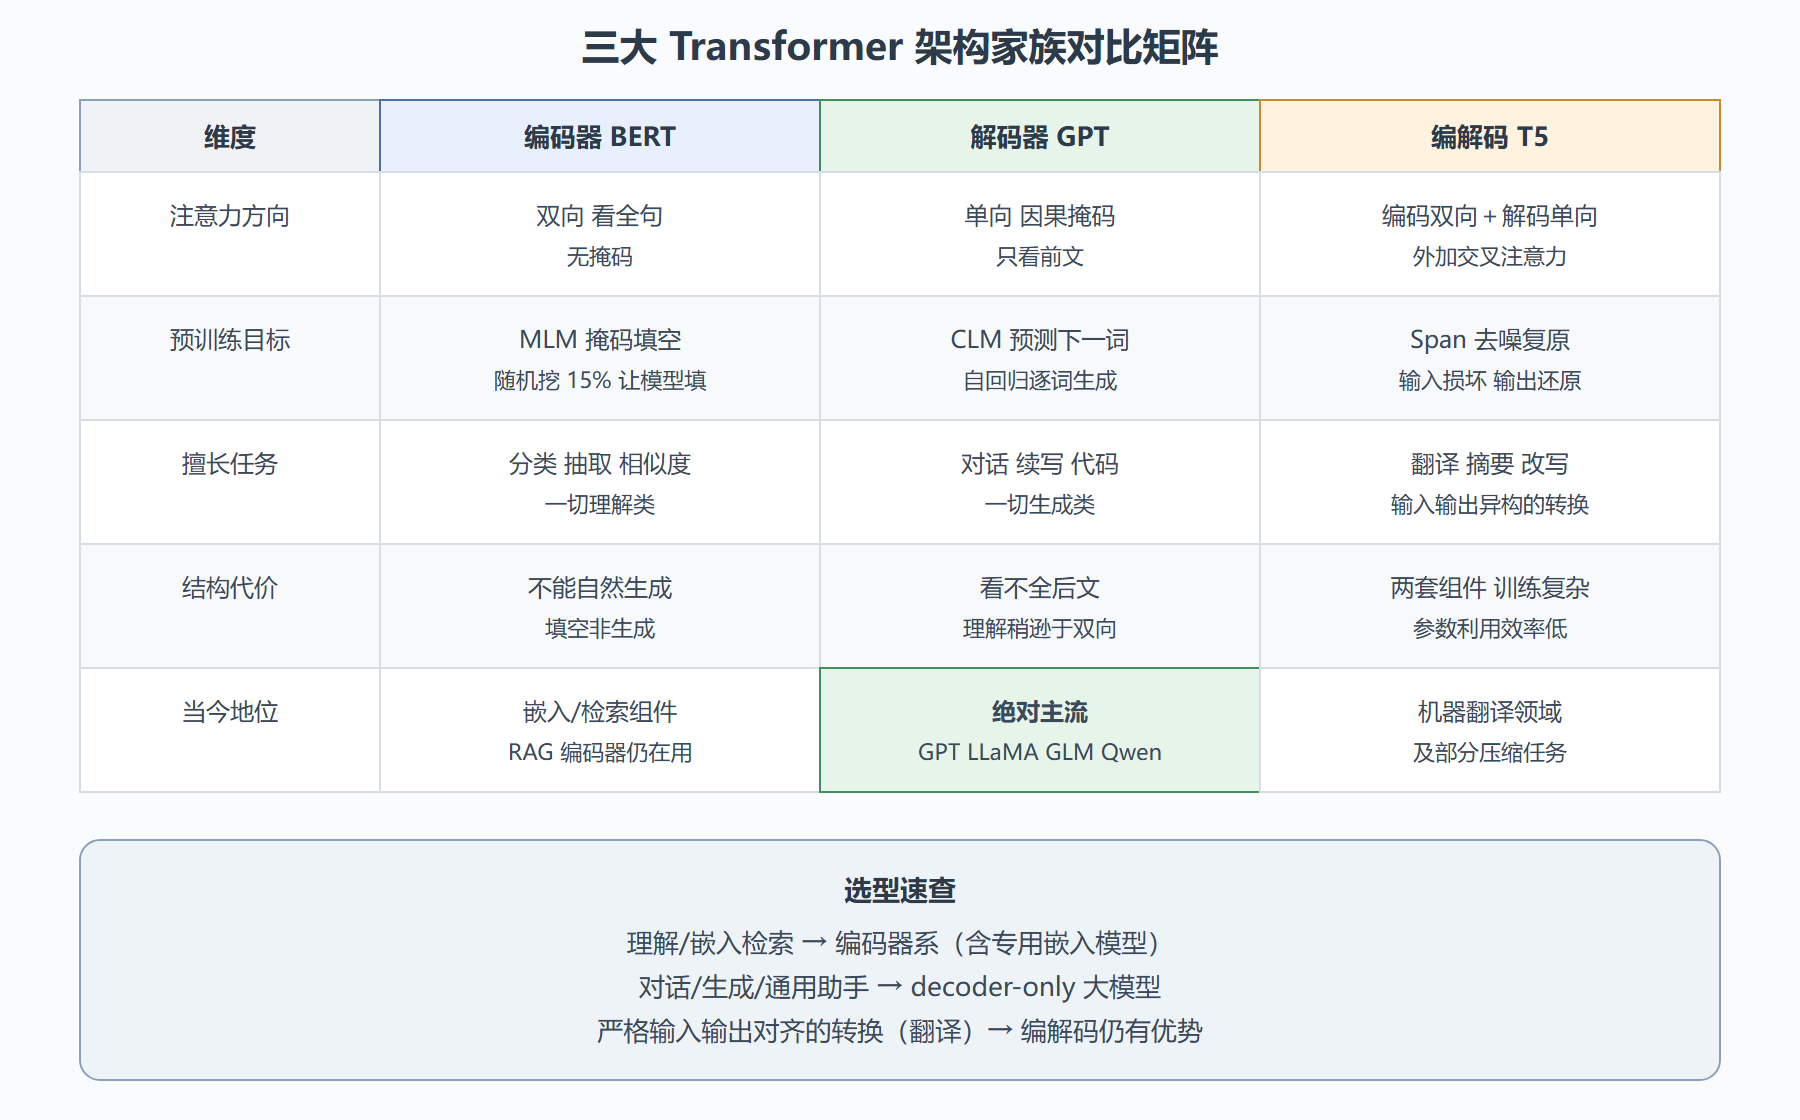
二、预训练目标与架构的绑定
架构决定了"能看什么",预训练目标决定"拿看到的东西练什么",两者是绑定的:
- BERT 用 MLM(掩码语言模型):随机遮住句中约 15% 的 token,让模型根据双向上下文猜出被遮的词——完形填空。任务与双向结构天作之合:填中间的空必须两边都看。
- GPT 用 CLM(因果语言模型):给定前文预测下一个 token,逐词右移。任务与单向掩码严格一致:训练即生成,生成即训练,训练目标和最终使用方式完全同构——这一点是它后来居上的暗线。
- T5 用 Span 去噪:随机删掉连续片段,让模型还原原文,一切任务统一表述为"文本到文本"。编解码结构正合适:编码器读损坏的输入,解码器产出完整输出。
三、为什么 decoder-only 统一了江湖
2018 年前后,业界普遍押注 BERT 式编码器(理解任务多、训练效率高);2020 年之后风向彻底倒向 GPT 式解码器。转折的解释有三层:
第一,训练与使用的同构性。 CLM 训练的每一步就是生成时的每一步——预训练做的正是"无限量的生成练习"。而 BERT 的填空能力无法直接迁移为对话能力,要生成还得改造。规模化的每一分投入,decoder-only 都直接存进"生成能力"这个最终被市场验证的账户。
第二,规模化的涌现表现更好。 实践中发现 decoder-only 随参数与数据扩大的能力曲线更陡,推理、指令遵循等涌现能力在它身上更显著。语言建模这个看似简单的目标,恰好是把语法、事实、推理、常识一次性打包的最通用接口。
第三,工程统一与复用。 一个 decoder-only 模型可以靠提示词同时服务理解与生成任务(理解任务改写成生成即可:情感分类变成"输出正面或负面"),而编解码架构需要为不同任务设计输入输出格式。统一架构让训练管线、推理引擎、优化手段(第 7 章全部内容)都能标准化复用。
⚠️ 两个别绝对化的提醒:其一,"decoder-only 理解不如双向"在实践中已被规模补平——大模型靠长上下文与指令数据,理解类基准全面超过 BERT 时代;其二,编解码并未死透,机器翻译等输入输出异构的任务上它仍有结构优势,且一些新架构(如早期多模态模型的视觉编码器 + 语言解码器)本质是编解码思想的复活。
四、给选型的落地建议
结合第 1.2 节的选型框架,架构层面的具体建议:
- 做检索/向量库(RAG 的编码端):用专用嵌入模型(现代版的编码器传人,对比学习训练),不要用通用大模型凑合——嵌入质量直接决定召回。
- 做通用能力或产品助手:decoder-only 大模型,无悬念。
- 做高质量机器翻译或结构化转换:可以评估编解码模型或专门的翻译模型,成本效率往往优于通用大模型。
- 自己微调:第 6 章会展开,但先记一句——decoder-only 的指令微调生态(数据、工具、经验)最成熟,是默认选项。
常见问题
问题:BERT 现在还有用吗?
有,但阵地收缩:轻量级理解任务(分类、NER)在资源受限场景仍是性价比之选;更重要的是它的思想活在嵌入模型里——今天 RAG 用的向量编码器,多数是对比学习训练的编码器架构,血统上就是 BERT 后代。
问题:GPT 系列和 LLaMA 这类开源模型架构一样吗?
主体一样(decoder-only + CLM + RoPE 等标准件),差异在工程细节:归一化位置、注意力效率变体(分组查询注意力)、FFN 系数、词表与数据。4.3 节的模型地图会给出逐项对照。
问题:为什么编解码做翻译更好?
翻译的输入与输出长度不同构(中文 20 字对应英文 30 词),decoder-only 必须在单一序列里"读完再写",注意力要在源文与已生成译文间分配;编解码用交叉注意力把源文完整保存在编码器里,解码时随时精确回看,结构上更省力。
五、架构演化的三段启示
三大架构的兴衰史浓缩了大模型领域最值得学习的决策模式,提炼三段启示:
启示一:胜负常在问题定义之外。 编码器路线当年数据效率更高、任务覆盖更广,是更"合理"的选择;但生成式对话被市场验证后,训练与使用同构的解码器路线价值飙升。技术选型的最优解依赖应用形态的判断——赌对应用方向比把当前任务做好一分更值钱。这提醒我们:评估任何架构时,除了看基准分数,更要问"它服务的应用形态会变大还是变小"。
启示二:统一架构的红利随时间复利。 decoder-only 一统后,训练管线、推理引擎、量化方案、微调生态全部围绕它标准化,后来者享受全链条成熟度——即使某个新架构在单点效率上更优,也要先补齐整条生态的差距。这就是为什么第 10.2 节的新架构至今以混合形态存在。生态位的价值,常常超过技术指标的价值。
启示三:败者的思想会被胜者吸收。 编码器没有消失,而是以嵌入模型的形态活在检索管线里;编解码的交叉注意力活在多模态模型中(视觉编码器加语言解码器)。技术演化更像器官移植而非物种替代——学"死掉"的技术并不亏,它的思想大概率还在现役系统里运转。
带着三段启示往回看,本节的架构矩阵就从静态的知识表,变成一张会流动的地图。
常见追问:BERT 类模型今天还有学习价值吗?
有,且性价比不低。其一,企业里大量存量系统仍是 BERT 系小模型在跑(分类、抽取),维护与优化它们需要懂其原理;其二,现代嵌入模型(RAG 的地基)血统上就是编码器加对比学习,第 5、9 章都会用到;其三,理解"填空式预训练与生成式预训练的差异"是理解当代模型能力边界的重要参照。把它当"历史包袱"跳过的读者,往往在第 9 章搭检索系统时回来补课。
再追问:怎么判断一个新模型属于哪族?
看三处即可:一查任务形态——只能续写与对话的是解码器系,能填空与做嵌入的是编码器系;二查自述文档的架构关键词——"decoder-only""auto-regressive"标明身份,"cross-attention"暗示编解码或多模态结构;三查预训练目标描述——"next token prediction"对应 CLM,"masked"对应 MLM。三步之内,任何新模型都能放进本章的坐标系——分类是理解的第一步,尽管它远非终点。
最后一问:面试中如何展示超出背诵的理解?
给一个高级答题动作:主动谈反例与边界——比如"decoder-only 统一主流,但我在做检索嵌入时仍会选编码器系的专用模型;做翻译选型时会评估编解码方案"。能说出"主流之外的例外与原因",等于向面试官证明你的知识是"用过筛过的",而不是"背过一遍的"。这一小步,是候选人之间的分水岭。
补记:术语速查
架构讨论的高频术语对齐:encoder-only 也叫双向编码器或 BERT 系;decoder-only 也叫因果解码器或自回归模型(GPT 系);encoder-decoder 也叫序列到序列(Seq2Seq)模型;因果掩码也叫下三角掩码或单向注意力。交叉注意力是编解码架构特有的组件(解码器回看编码器输出的通道)。这份对齐能消除读不同资料时的名词障碍。
最后补一个观察练习:打开你常用的两个 AI 产品,判断它们的底层大概率属于哪族架构、用了哪些本节的架构特征(流式逐字输出指向自回归解码器、图片理解暗示额外的编码器)。把架构知识对到活的产品上,是检验本章内化程度最直接的方式——你会发现"看得见的交互细节"与"看不见的架构选择"之间存在清晰的因果线。
再补一个易考细节:三大架构的"参数效率"差异。同等参数量下,编解码架构的参数要分摊在两套组件上,单一任务可用容量反而更少;decoder-only 的全部参数都服务于同一条生成路径,规模利用率最高——这是"编解码并不因两头而更强"的量化解释之一,也是 4.2 节选型建议背后的又一个论据。
本节要点回顾
- 架构分型的开关是因果掩码:编码器双向、解码器单向、编解码两段式加交叉注意力。
- 目标与架构绑定:MLM 填空(BERT)、CLM 预测下一词(GPT)、Span 去噪(T5)。
- 各有所长:编码器理解、解码器生成、编解码转换;各有结构代价。
- decoder-only 胜出的三层原因:训练使用同构、规模化涌现好、工程统一复用。
- 选型:检索用嵌入模型、通用用 decoder-only、翻译类可评估编解码。
家族地图画完,下一节拉远镜头:是什么规律决定了各家敢砸几十亿训练费——规模定律与主流模型一览。