4.3 模型规模、预训练目标与常见大模型
4.3 模型规模、预训练目标与常见大模型
本节摘要:为什么各家敢押注几十亿的训练费?答案是规模定律(Scaling Laws)——损失随参数、数据、算力按幂律可预测地下降,这是大模型时代的行业宪法。本节讲清幂律的含义与最优配比结论、三种预训练目标的谱系,并纵览从 BERT 到当代开源旗舰的模型地图,最后给出开源与闭源的选型框架。
学习目标
阅读完本节,你应当能够:
- 陈述规模定律的幂律形式及其可预测性
- 解释"给定算力预算下的最优配比"这一核心结论
- 区分 MLM、CLM、对比学习三种目标各自的适用面
- 按架构与定位归类主流大模型
- 在开源与闭源之间按场景做出选型判断
一、规模定律:大模型时代的宪法
2020 年前后,研究者系统实验后发现一个惊人规律:模型损失随参数量 N、数据量 D、训练计算量 C 按幂律平滑下降——在对数坐标下是一条漂亮的直线。粗略形式:
损失 L ≈ A · N^(-α) + B · D^(-β) + 不可约损失
幂律的含义有两层。第一是可预测:你在 1 亿参数的小模型上量出曲线,就能外推出百亿、千亿模型的损失——训练前就知道结果大概在哪,几十亿投入的风险因此变得可计算,这是各家敢下注的根本原因。第二是平滑无台阶:损失层面没有魔法跃迁,第 1 章讨论的"涌现"更多发生在下游能力的度量上,两件事并不矛盾——底层平滑改善,跨过任务门槛后宏观能力才显形。
更有工程价值的是最优配比结论:给定算力预算 C,参数量与数据量应按近似固定的比例共同放大(经典的估算约是"每个参数配 20 个 token"量级;更新的研究把这个数字推得更高,强调"小模型喂更多数据"常常更划算)。两个直接推论:
- 盲目堆参数是浪费:70 亿参数只喂 100 亿 token,远不如喂 1.4 万亿 token 的 70 亿模型——这正是 LLaMA 系列的策略:参数不冒进、数据管够,用"小而喂饱"的模型打赢"大而挨饿"的对手。
- 过度训练是常态:出于推理成本的考虑,厂商故意把 70 亿级模型喂到配比的好几倍——训练多花一次钱,每次推理都省钱,这笔账在部署规模大时极其划算。
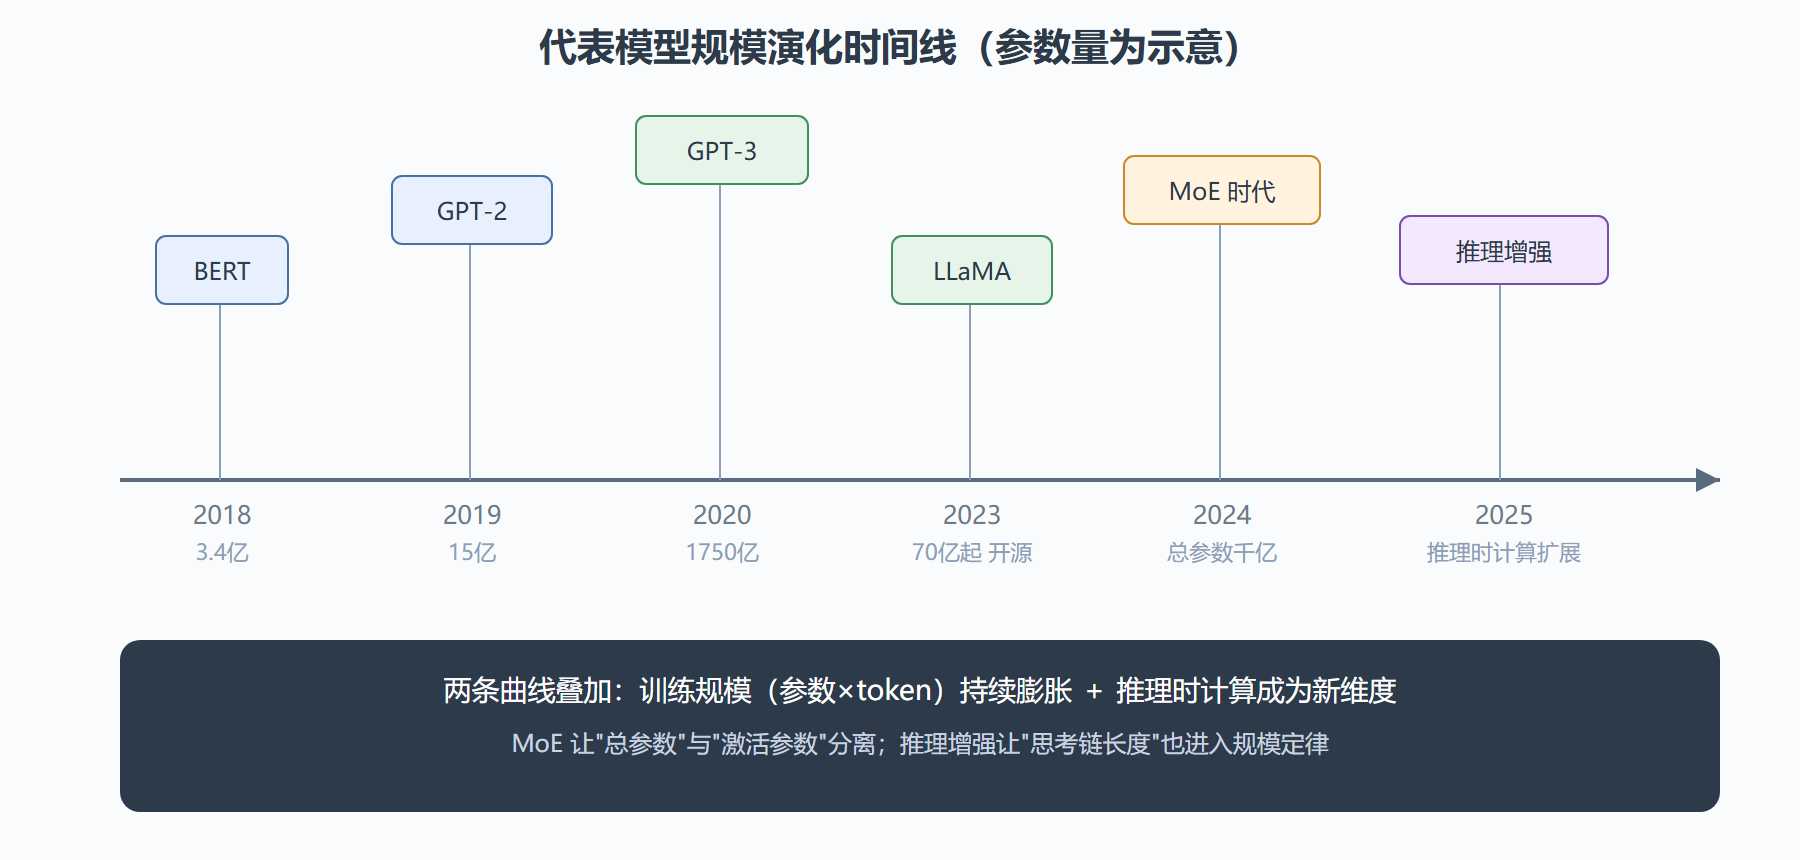
代表模型规模演化时间线
二、预训练目标谱系
4.2 节把目标与架构绑定了,这里补全谱系视角:
- MLM(掩码语言模型):理解取向。看上下文猜空格,训练信号密集(一句可挖多个空),但预训练与生成脱节。当今主要活在编码器血统的嵌入模型里。
- CLM(因果语言模型):生成取向。训练即生成,规模化涌现最好,decoder-only 的标配。缺点是每个位置只有一个监督信号(真实的下一个词),数据效率略低——靠规模补。
- 对比学习:表示取向。让语义相近的文本对在向量空间靠近、不相关的远离,损失函数是 InfoNCE 一类。它是嵌入模型与多模态对齐的目标函数——图文模型"把图片和它的描述对齐"、RAG 检索器"把问题和答案段落对齐",背后都是它。第 9 章多模态一节会用到这个结论。
实践中三种目标常组合使用:一个多模态模型可能先 CLM 预训练语言能力,再对比对齐图文,最后 CLM 统一微调。
三、主流大模型地图
把常见名字放进坐标系(架构 × 开源属性),混乱立即变清晰:
| 模型 | 架构 | 参数定位 | 记忆点 |
|---|---|---|---|
| BERT(2018) | 编码器 | 3.4 亿 | 理解任务奠基者,MLM 范式开创 |
| GPT 系列(2018– ) | 解码器 | 十亿到万亿级 | CLM + 规模化 + 对齐,商业化标杆 |
| T5(2019) | 编解码 | 110 亿 | "一切皆文本到文本"的统一框架 |
| LLaMA 系列(2023– ) | 解码器 | 7B 到数百 B | 开源生态引爆者,"小模型喂饱"策略 |
| GLM 系列 | 解码器 | 多规格 | 中英双语与工具能力,国产代表 |
| Qwen 系列 | 解码器 | 全尺寸覆盖 | 尺寸梯度最全的开源家族之一 |
| Mistral / DeepSeek | 解码器(部分 MoE) | 混合专家 | MoE 路线代表,激活参数小、总容量大 |
看地图的正确姿势:家族间架构差异远小于数据、配比与对齐方法的差异。当代模型几乎全是"decoder-only + CLM + RoPE + RMSNorm +(可选)MoE"的标准件组合,真正拉开差距的是数据质量(第 5 章主题)与后训练(第 6 章主题)。这也是面试高频考点:别再答"某某模型架构更先进",要答"标准架构 + 数据与对齐的差异"。
四、开源与闭源的分野
| 维度 | 闭源 API(GPT、Claude、Gemini) | 开源权重(LLaMA、GLM、Qwen、DeepSeek) |
|---|---|---|
| 效果上限 | 旗舰级,通常领先 | 追赶迅速,头部开源接近上代闭源 |
| 成本结构 | 按 token 计费,量大后昂贵 | 自建推理,边际成本低 |
| 数据隐私 | 数据出域 | 可完全私有化 |
| 定制能力 | 提示词与微调接口有限 | 全参数微调、任意改造 |
| 工程负担 | 几乎为零 | 显存、部署、监控全套自己扛 |
选型框架延续 1.2 节的四问,加两条经验法则:其一,先用闭源 API 验证产品逻辑,跑通且量大后再评估开源迁移——过早自建是创业公司最常见的资源错配;其二,私有化不是二元选择,专用小模型 + 通用 API 的混合部署(敏感数据走本地小模型,通用任务走 API)在多数企业里是更现实的落点。
⚠️ "开源"的细节坑:不同模型的许可证条款差异很大,有的限制商用规模、有的要求衍生品开放权重;另外"开放权重"不等于"开放数据与训练细节",可复现性各不相同。商用前务必核对许可证原文。
常见问题
问题:Scaling Law 会不会失效?
修正过几次而非失效。2024 年前后业界发现经典幂律在极大规模下出现收益递减的调整,同时"推理时计算"(让模型思考更久)被证明是新的可扩展维度——规模定律没有终结,而是在加新自变量。
问题:70 亿参数的模型够用吗?
取决于任务。日常对话、摘要、分类、RAG 问答,精调过的 7B~14B 模型已可胜任且成本极低;复杂推理、长文档理解、高难代码,头部大模型仍有明显优势。第 7 章会给出"小模型 + 量化"的成本账。
问题:新出的模型永远更好吗?
基准分数在涨,但具体任务未必:风格、格式遵循、中文语感、工具调用格式兼容性都可能在换代时变化。生产系统换模型前要在自己的评测集上回归(第 8 章的主题),不要只看榜单。
四点五、把规模定律用在日常决策里
规模定律听起来像厂商的战略工具,其实在日常工程决策里有非常实用的三个推论,值得单独拎出来:
推论一:小模型实验可以外推大模型结论。 需要验证某个数据配方或训练技巧在大模型上是否有效?在最便宜的小尺寸上跑对照,趋势大概率保留。这是研究与工业界做实验设计的基本功——前提是两个尺寸都落在幂律的平滑区间内。
推论二:单位能力的边际成本在下降,但不会免费。 同样的钱,两年后买到的模型能力远超今天(硬件、算法、市场三重红利);但"再好一点的价钱永远在涨"——旗舰能力的价格始终高昂。做产品规划时按"能力成本逐年降、旗舰永远贵"双假设定价,两头都不会错太多。
推论三:推理成本主导总拥有成本。 规模定律只讲训练,产品寿命期内的推理费用通常远超训练(第 10.2 节的账)。所以"选多大模型"的正确姿势是先估算生命周期调用量,再倒推训练与推理的总账——被训练费用吓退、或为省训练费选了过小模型导致推理量堆不上去,都是算错了总账。
三个推论合起来是一个态度:规模定律不是论文里的曲线,而是你做预算、排实验、选模型时的隐形计算器。
常见追问:普通开发者该盯模型发布日历吗?
建议"订阅但不守候"。新模型发布对普通开发者的实际影响是:选型候选多了、同样预算的能力强了——这两点按季度评估一次足够,日常工作几乎不被影响。真正值得即时关注的是两类事件:你在用的模型或框架的废弃与破坏性更新公告(影响生产),以及安全漏洞披露(影响防御)。把注意力从"发布会"移向"变更日志与安全通告",是从围观者到工程师的心态分界。
再追问:模型名字后的数字(7B、70B)该怎么用?
把它当容量标签,第一用于显存心算(数字乘每参数字节数得权重体积,第 4.1 节),第二用于能力预期的粗定位(同代同系内更大通常更强,跨系比较无意义),第三用于成本预估(推理成本大致随激活参数线性)。三个用途都成立的前提是"同代同系"——脱离数据与对齐水平,单比参数量的比较都是耍流氓,这句话在选型会上值得原样复述。
最后一问:选模型时"代际"和"参数"哪个重要?
代际(发布时间与数据质量水平)通常比参数更重要——新一代的七千亿分之一……更正:新一代的七十亿参数模型,常常胜过上一代的三百亿模型(数据、对齐、架构细节的代际进步所致)。所以选型顺序应是先选代际(最新的稳定版本),再在代际内按参数选档(按成本与能力需求)。只按参数选模型的清单式思维,是选型错误的高发原因。
补记:模型规格表阅读法
拿到任何模型发布规格,按固定顺序读五项:架构(decoder-only 还是变体)、参数量(注意 MoE 的总参数与激活参数两个数)、上下文长度(与成本直接挂钩)、训练数据规模(判断能力潜力的关键)、许可证(商用条件)。五项读完,这个模型的定位与适用性基本清晰——这个流程化的阅读习惯,能把你从"被宣传带着走"变成"按需提取信息"。
本节要点回顾
- 规模定律:损失随参数/数据/算力幂律下降,训练结果可预测——行业敢下注的依据。
- 最优配比是核心工程结论:参数与数据成套放大;"小模型喂饱"(LLaMA 策略)与"过度训练换推理便宜"都是配比思想的运用。
- 预训练目标谱系:MLM 理解、CLM 生成、对比学习对齐,多模态与检索用对比。
- 模型地图:主流皆为 decoder-only 标准件组合,差距在数据与后训练;MoE 把容量与计算解耦。
- 开源闭源按成本结构、隐私、定制、工程负担四维选;推荐"先 API 验证、再开源迁移",并核对许可证。
架构与地图讲完,第 5 章进入实操:海量数据从哪来、怎么洗,预训练到底怎么跑。