5.1 预训练数据集构建与清洗
5.1 预训练数据集构建与清洗
本节摘要:数据决定大模型的上限。本节讲预训练语料从哪来(网页、书、代码、对话的来源谱系)、怎么洗(多级流水线:抽取、去重、质量过滤、去毒)、怎么配(决定能力偏向的混合比例),并用公开证据说明一个反直觉结论——在当代规模下,数据质量与配比的杠杆已大于单纯堆量。
阅读目标
阅读完本节,你应当能够:
- 列出预训练数据的主要来源及各自的优劣
- 描述多级清洗流水线的每个环节与工具思路
- 解释精确去重与模糊去重(MinHash)的区别与必要性
- 说明配比如何影响模型能力偏向
- 把"质量优先"原则迁移到自己的微调数据构建中
一、数据从哪来:来源谱系
预训练需要万亿 token 级的通用文本,没有单一来源能撑起这个量,主流语料是多种来源的混合:
- 网页爬取(Common Crawl 等):体量之王,占语料大头。但也是问题之王——乱码、广告、SEO 垃圾、重复转载,"量大质杂"四个字的完美写照。
- 书籍与长文:连贯、书面、有深度论证,对长程理解与深度写作的价值远超其占比。
- 百科与知识库:密度最高的结构化知识来源,覆盖面广且相对可靠,占比不高但性价比极高。
- 代码(GitHub 等):当代模型的标配成分。代码对推理能力的贡献被反复验证——这有点反直觉,但代码是最严格遵循逻辑的自然文本形式,学写代码顺带练了形式推理。
- 学术论文:专业知识与术语密度高,代价是文风狭窄。
- 对话数据:为对话能力储备,质量参差,需要更严的过滤。
各来源的可用比例极不均衡:Common Crawl 原始爬取可达数百 TB,清洗后通常只剩百分之几——这条"漏斗"是本节下一部分的主角。
二、清洗:一条多级流水线
原始数据"生、脏、杂",直接喂给模型等于让学生的学习教材里一半是传单。清洗是拿时间换质量的漏斗,工业级流水线大致五级:
预训练数据清洗流水线
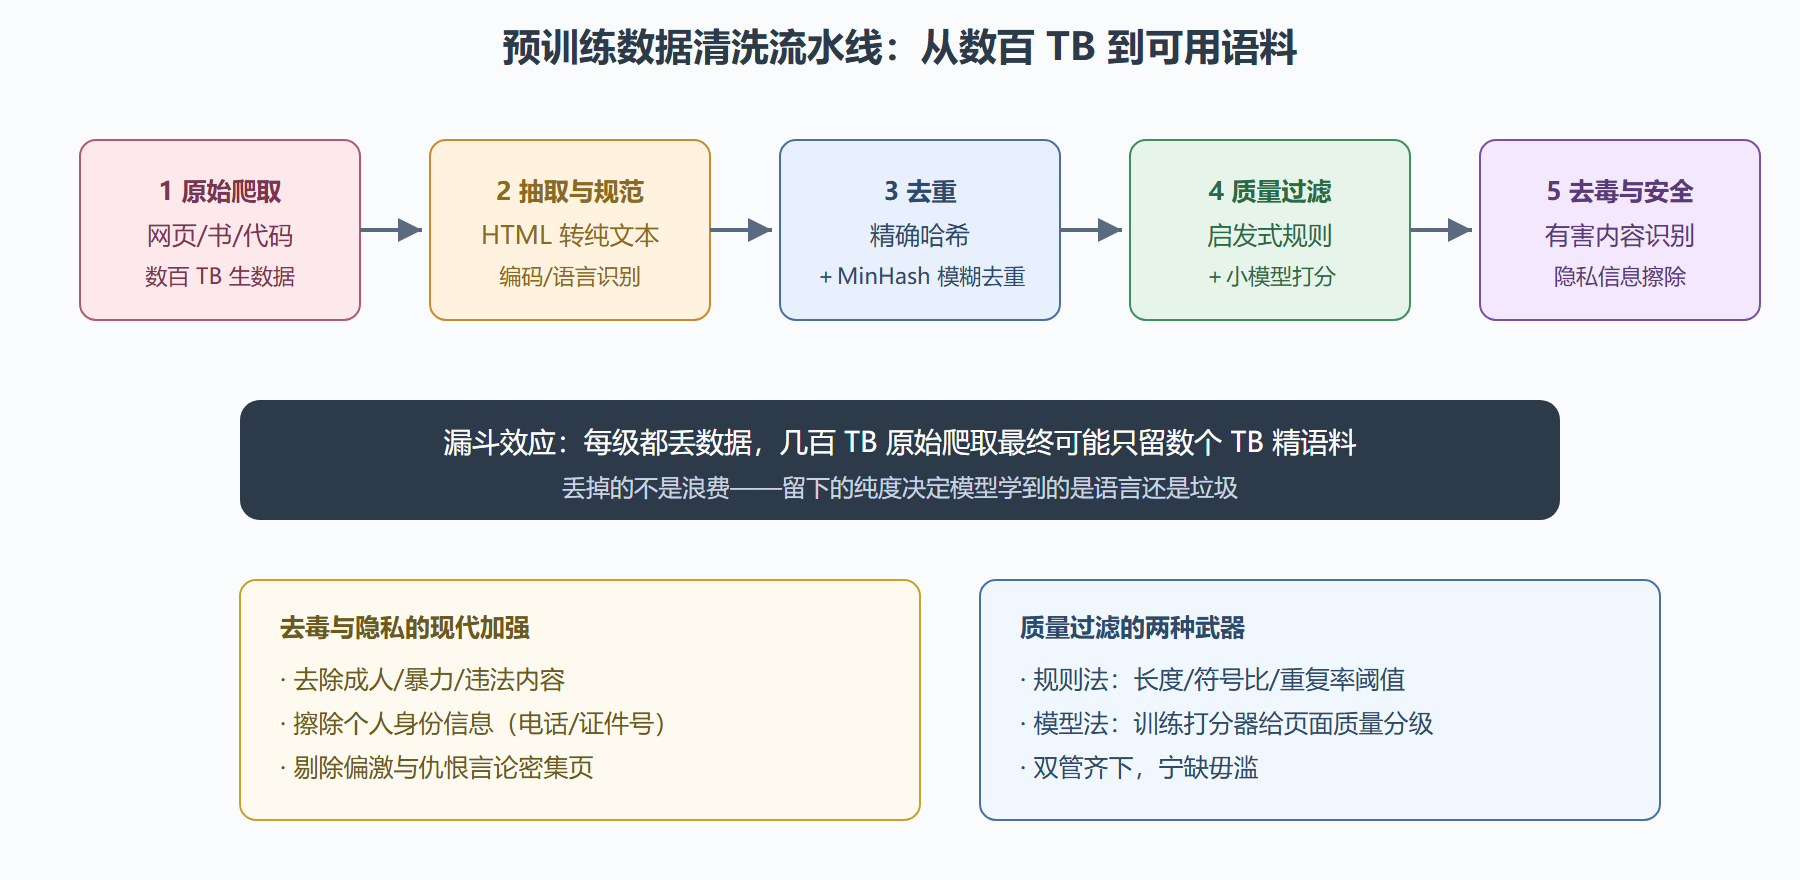
几个环节值得展开:
抽取与规范化:网页要先从 HTML 里抽出正文(去掉导航、广告、评论框),处理编码错误与乱码,识别语言并分流。这一步做不好,后面全是垃圾进垃圾出——3.1 节提过的"规范化影响分词质量"在这里兑现。
去重是最被低估的环节。 精确去重(哈希比对完全相同的文档)只解决最表层;互联网上大量内容是"洗稿式"的近似重复(同一新闻稿被几百个站转载、仅改标题),需要模糊去重:MinHash 把文档压成一组指纹签名,局部敏感哈希让相似文档的指纹碰撞到一起,从而批量识别近似重复。为什么重复如此致命?重复数据让模型"背"而不是"学"——记忆特定副本浪费容量,还放大了重复内容里的偏见与错误(一句错的话重复一万遍,模型就把它当真理)。公开研究给出的量级概念:不做模糊去重的语料训练出的模型,在同规模下明显落后。
质量过滤:早期用启发式规则(文档长度、平均词长、符号字符比例、停用词占比),后来普遍加一层"质量打分器"——训练一个小模型给每篇文档打分(思路接近:以维基等高质量语料为正例训练分类器),阈值过滤。风险是过滤器自身带偏差,可能错杀小语种与口语化内容,所以现代流水线会监控过滤器的"误杀率"。
去毒与隐私:识别并移除色情暴力违法内容;擦除个人身份信息(电话、证件号、邮箱)。这部分既是伦理要求(第 10 章),也是合规底线——欧盟等地的数据法规对训练数据里的个人信息有明确约束。
三、配比:决定能力偏向的暗手
清洗后的语料怎么混合,直接塑造模型的"性格":
- 代码占比高 → 逻辑推理与代码能力强(有研究专门验证了代码数据对推理的正迁移)。
- 网页占比高 → 常识广、口语自然,但深度与准确性受网页质量牵制。
- 学术占比高 → 专业知识强,闲聊变"论文腔"。
- 多语言占比 → 决定各语种能力;中文模型必须专门扩中文语料配比。
配比是各家最核心的不传之秘,论文里通常只给模糊区间("网页约六成、代码一成上下"这类量级)。原因很简单:同样的数据、不同的配比,训出的模型在能力测评上可以差出明显的档位——这是花真金白银试出来的经验曲线。
另外一个现代趋势:课程式分阶段训练。先喂通用数据打基础,后期加大高质数据或目标领域数据的浓度(类似基础教育后再学专业)。有厂商在预训练末期加入指令式数据,让基座"预先适应"后训练,效果类似给学生考前划重点。
四、质量决定上限:证据与推论
"数据质量比数量更重要"不是口号,有几类公开证据:其一,用小而精的语料(清洗到极致的几百 GB)训出的模型,能打过用粗洗数 TB 语料训的同规模模型,这类对照实验在多篇论文中反复出现;其二,第 4 章讲过 LLaMA 的"小模型喂饱"策略成功的前提,正是"喂饱"喂的是精料;其三,业界的普遍观察——架构红利已薄,数据工程成为训练差异化竞争的主战场。
💡 对读者的迁移价值:这个结论在你的尺度上同样成立。做微调(第 6 章)时,两千条精洗、覆盖分布均匀的指令数据,效果通常好于两万条混杂噪声的数据。"先把数据洗到每一条都愿意自己读"——这是微调项目最划算的投入。
⚠️ 常见误区:以为数据越多越好。低质数据堆量不仅不涨点,还会挤占高质量数据的有效梯度份额、放大其中偏见。数量是规模定律的燃料,质量是燃料的辛烷值——两个都要,优先级在后。
常见问题
问题:个人或小团队能拿到什么预训练数据?
公开研究语料(各家的开放数据集、Common Crawl 的开源处理版本、代码与百科语料)足以支撑从零训一个小型模型的学习实验。但要清楚:复现工业级模型的能力,瓶颈在数据工程深度与算力,不在数据可得性。
问题:清洗会不会把有用的信息也洗掉?
会,这是precision与recall的取舍。规则太严会错杀口语化、方言、小语种内容;所以现代流水线会抽样人工复核被过滤内容,并用"过滤前后训出模型对比"来校准阈值——数据工程同样是实验科学。
问题:合成数据能用吗?
当代预训练已大量使用高质量合成数据(用强模型生成教材式内容再过滤),尤其数学与代码领域。原则是"合成补短板、需严过滤",全合成语料训练的模型有模型塌缩(多样性递减)风险,纯天然与合成的配比仍在探索。
五、一次数据审计的实战清单
把本节方法论压成一份可直接执行的清单,适用于任何人接手一份微调或继续预训练数据的场景。按顺序过,每条都是半小时内能完成的检查:
第一查重复:随机抽五百条,按精确文本查重,再看近似重复(长前缀相同)比例。重复率超过百分之几就值得警惕——正文讲过,重复让模型背诵而非学习。
第二查分布:按任务类型、长度、语言(如多语)分组统计。最常见的病灶是分布畸形——八成数据是同一模板生成的,或长度集中在某一段,模型会把这个偏斜学成品格。
第三查质量:每层抽二十条亲自读。重点看三类坏样本:事实错误、指令与回答不匹配(问甲答乙)、格式不一致(该是表格的成了散文)。人读一百条比任何自动指标都更早发现问题。
第四查泄漏:如果同时有评测集,用最长公共子串或模糊匹配查训练数据里是否混入了评测题。混入即污染,评测结果作废。
第五查安全与隐私:正则扫个人身份信息(电话、证件号模式);过一遍敏感词清单看密度。企业场景这一查是合规硬要求。
五查通过,数据才算"见过人"。清单本身不产生价值,价值在于养成"先审数再开训"的肌肉记忆——绝大多数"模型训出来不对劲"的事故,事后都能在数据审计里找到病灶。
补充:数据工程的成本观
值得算一笔账:同等算力预算下,把两成预算投给数据工程,通常比全部投给训练时长带来更大的收益提升——因为脏数据造成的浪费是隐性的(模型把容量花在记忆垃圾上),而清洗的收益是全面的。多家团队的公开复盘都指向类似的结论:数据管线每优化一轮,相当于模型规模白涨一档。下一次预算讨论时,"数据工程投入"值得单独列一行。
常见追问:合成数据的边界在哪里?
当前共识:合成数据擅长"补短板"(数学推理步骤、代码示例等有明确对错的领域),要配严格过滤;不适合"造世界"(全合成语料训练会导致模型塌缩,多样性逐代递减)。一个务实的判断标准——如果任务有客观判分(代码能跑通、数学能验算),合成数据可靠;如果任务依赖真实分布的多样性(闲聊、风格、常识),天然数据仍不可替代。
再追问:数据工作的投入什么时候能停止?
几乎不能。语料会老化(世界在变)、过滤器会过时(内容形态在变)、偏见认知会更新(社会标准在变)——数据工程是持续运营而非一次性项目。企业侧同理:知识库不维护,RAG 效果就衰减。给数据工作设定"保鲜机制"(定期回补新语料、复审过滤规则)比追求一次完美更现实,这个认知能帮你正确规划长期预算。
本节要点回顾
- 来源谱系:网页(量大质杂)、书籍长文、百科、代码、论文、对话——单一来源撑不起万亿 token。
- 清洗流水线五级:抽取规范 → 去重(精确+MinHash 模糊)→ 质量过滤(规则+打分器)→ 去毒 → 隐私擦除;漏斗丢弃率极高但必要。
- 去重最被低估:重复让模型背诵而非学习,还放大偏见与错误。
- 配比塑造能力偏向(代码→推理、网页→常识、学术→专业),是各家核心 know-how;课程式分阶段是现代趋势。
- 质量决定上限,且结论可直接迁移到微调数据构建:两千条精洗胜过两万条混杂。
数据备好了,下一节看监督信号从哪来——不用人工标注的自监督学习。