5.2 自监督学习:MLM、CLM 与对比学习
5.2 自监督学习:MLM、CLM 与对比学习
本节摘要:预训练的魔法在于"自监督"——不用人工标注,从数据自身构造监督信号:挖掉一部分让模型填回(MLM)、看前文猜下一个词(CLM)、拉近相似推远不相似(对比学习)。本节讲清三种目标的机制、各自学到什么,并回答那个最著名的问题:为什么"预测下一个词"这么简单的目标,能逼出推理、翻译、写代码这些复杂能力。
学习目标
阅读完本节,你应当能够:
- 解释自监督如何绕开标注瓶颈
- 描述 MLM 与 CLM 的训练过程并能各举一例
- 说明对比学习的正负样本构造与损失直觉
- 阐述"CLM 为何强大"的因果链条
- 判断一个新场景(嵌入、生成、对齐)该选哪种目标
监督信号从数据自己身上长出来
先看传统监督学习的死结:模型能力要靠数据喂,但人工标注贵且慢——标注十亿级句子,按每条几秒算也需要几百年人力。预训练范式能起飞,前提是解开这个结。
解法优雅得近乎取巧:文本自己就是标注。把一句话挖掉一个词,被挖掉的词就是标准答案;把一句话遮住后半段,后半段就是标准答案。答案原本就在数据里,只是出题方式让它"藏"起来——出题(构造输入)与答案(保留原文)都自动完成,零人工。这就是自监督学习,人类语言宝库因此第一次可以被整体利用。
与第 4.2 节呼应:目标的选择和架构绑定(双向架构配填空、单向架构配续写),本节聚焦目标本身的机制。
二、MLM:完形填空
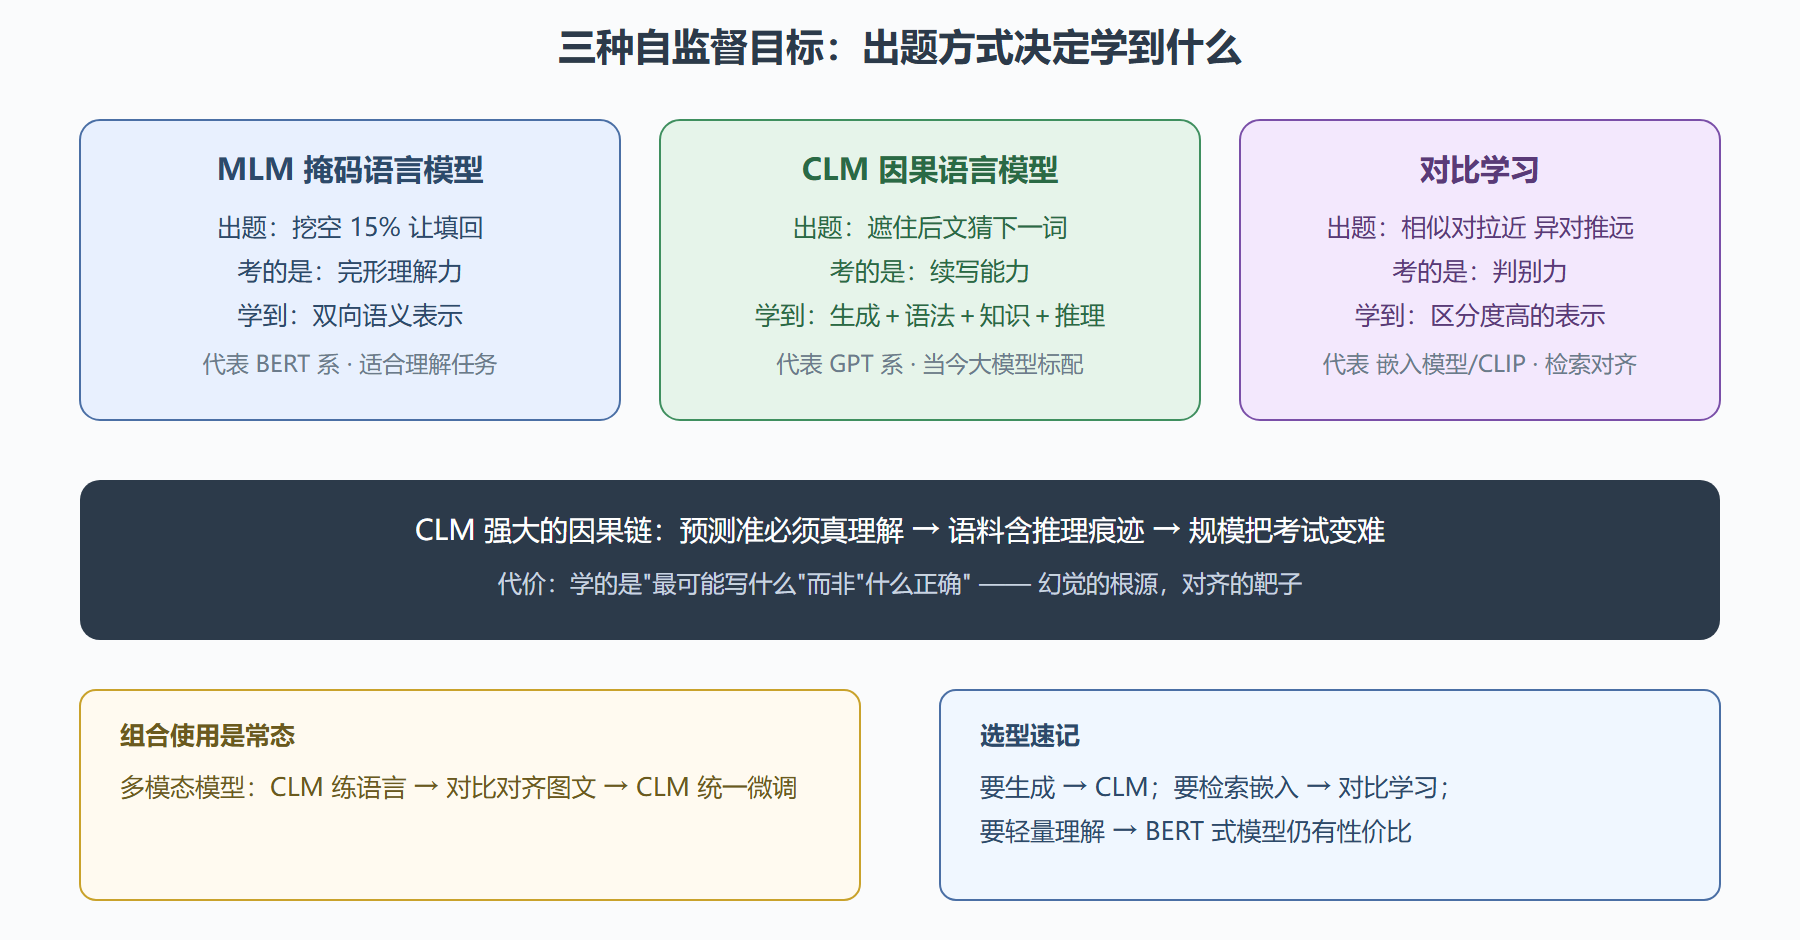
掩码语言模型的做法:随机选 15% 左右的 token,替换成特殊掩码符号,让模型根据剩余上下文预测被掩的词。
原文: 预训练 让 模型 从 海量 数据 中 学习 掩码: 预训练 让 [MASK] 从 海量 [MASK] 中 学习 目标: [MASK]₁ → 模型 [MASK]₂ → 数据
要填对第一空,模型必须懂"让什么从数据中学习"的句法语义;要填对第二空,必须知道"海量"后面接什么名词搭配。每个掩码都是一道微型理解题,且因为能看到左右两边(双向架构),题目考的是完形理解力。BERT 靠它统治了 2018–2020 年的一切理解类任务。
MLM 的两个结构性弱点在后来显现:其一,填空能力不能直接变成生成能力(4.2 节讲过);其二,被掩的 15% 才产生监督信号,数据利用率不如 CLM——同一句话,CLM 的每个位置都是训练信号。
三、CLM:无限的续写练习
因果语言模型的做法:把输入右移一位当目标,让模型在每个位置预测下一个 token。
输入: 预 训 练 让 模 型 目标: 训 练 让 模 型 ……
每个位置一个监督信号,整句话没有任何浪费。更关键的是训练与使用同构:预训练做的事(看前文出下一个词的概率分布)就是生成时做的事(采样、拼接、再预测),第 4.2 节说的"decoder-only 胜出暗线"就是这一条。
四、为什么"猜下一个词"能逼出推理能力
这是本节最值得想透的问题。表面看,预测下一个词像高级自动补全,怎么会涌现出多步推理、翻译、代码能力?因果链条有三环:
第一环:预测准的唯一途径是真理解。 想在"三角形的内角和是____"后预测对,必须知道几何事实;想在长定语从句后接对动词形式,必须懂句法;想在代码里预测对下一行,必须懂程序逻辑。下一个词的概率分布是全部语言规律与世界知识的综合考试,浅层模式匹配只能拿到浅层分数——压低损失的压力把模型推向深层理解。
第二环:语料本身包含推理的完整痕迹。 人类文本里到处是"因为……所以……"、证明过程、解题步骤。模型要预测证明的中间步,等于被逼着模拟推理过程。数学与代码语料占比提高后推理能力上涨(5.1 节的配比话题),正是这一环的证据。
第三环:规模把"考试"变难。 万亿 token 的考题覆盖从闲聊到论文到代码的一切文体,任何靠局部套路应考的策略都会在某个语料域露馅。规模越大,"理解"越是压低损失的最优策略。
反过来说也成立:它学的终究是"接下来最可能写什么",不是"什么是对的"——2.1 节埋下的幻觉根源,在第 6 章对齐与第 10 章安全中会被反复针对。
三种自监督目标对比
五、对比学习:学"分得开"而不是"写得出"
第三种目标的逻辑完全不同:它不预测内容,而是塑造表示空间的几何结构——语义相近的文本对在向量空间里拉近,不相关的推远。
训练需要一个"正负样本对"的构造:正样本对来自同一语义(同一问题的两种问法、图片与它的文字描述),负样本从批次里随机抽其他样本充当。损失函数(InfoNCE 一类)的直觉:在一批候选里,模型要能把正样本从一堆负样本中认出来——像治安里"把嫌疑人从人群中指认出来"的队列指认训练。负样本越多、指认越难,学到的表示区分度越高。
对比学习是两件当代基础设施的目标函数:嵌入模型(RAG 检索的向量编码器,3.1 节的向量空间在这里被精修)与多模态对齐(CLIP 类模型把图片和文本拉进同一空间,是 9.3 节多模态应用的地基)。做检索类应用时,你会直接消费它的产物。
常见问题
问题:MLM 和 CLM 能混用吗?
能,且有成功案例(在 CLM 语料里掺入部分填空任务作为辅助)。但工程复杂度上升、收益有限,主流 decoder-only 模型基本只用 CLM 加数据策略,不做目标混合。
问题:对比学习的负样本为什么重要?
负样本决定"推远"的方向。只用简单负样本,模型学到的是表面差异(不同句子长度)就能分开;加入困难负样本(同领域不同含义的句子),表示才被逼向语义层面。嵌入模型质量差距,很大程度在困难负样本的挖掘上。
问题:既然 CLM 那么强,为什么嵌入模型不用 CLM 训?
因为目标决定能力:CLM 训出的是"会续写"的模型,其内部向量未必在检索意义上可比。嵌入模型用对比学习直接优化"向量相似度=语义相似度",目标与用途同构——又见 4.2 节那条"训练与使用同构"的暗线。
六、一个自监督设计的思想实验
为巩固"出题方式决定学到什么",做一个思想实验:假如让你为"客服对话理解"设计自监督目标,你会怎么出题?
方案一,套用完形填空:把客服对话里的关键词挖掉让模型补。模型会学到对话的表层统计(哪些词常出现),但对"如何回应"无感——填空考理解,不考行为。
方案二,套用下一词预测:给客户的话,预测客服的下一句。模型学到"什么样的客户消息之后,优秀的客服会说什么"——这正是需要的能力,且监督信号(真实客服的回复)就在日志里,零标注成本。事实上,多家企业的客服模型正是这么从历史对话里预训练出来的。
方案三,对比学习:把"同一个会话的问题与优质回答"拉进,与"无关回答"推远。学到的是匹配度判断——可用于路由(该转人工还是机器答)与检索,但不直接产出回复能力。
三种方案没有对错,只有与目标的匹配度:要生成能力选方案二,要检索与路由能力选方案三,方案一在这个场景基本无用。这个思想实验的答案结构——先问目标、再选出题方式——比记住"三大自监督"更重要。第 6 章讲微调目标、第 9 章讲应用架构时,你会反复用到这套思考法。
补充:自监督的边界与监督的回归
自监督解决了"有没有监督信号",但不代表人工监督消失——它换了个位置。对齐阶段的人类偏好标注(第 6.2 节)是监督;评测集的人工判分(第 8 章)是监督;红队测试的攻击样本标注(第 10.1 节)还是监督。演化的真相是:廉价的自监督铺底、昂贵的监督精修,人力从"标注一切"转向"只标注判断与偏好"。理解这个分工,就理解了现代大模型团队里标注工作的真实形态——不是标数据,是标判断。
常见追问:预训练目标可以同时用多个吗?
可以,但要算清两笔账。一笔是计算账——每个目标都要在数据上过一遍,多目标直接多倍成本(或分摊数据量);另一笔是干扰账——不同目标的梯度方向可能冲突,需要加权调和,权重本身是要调的超参。实践中多目标预训练多见于多模态场景(语言用 CLM、对齐用对比),纯语言模型几乎都单目标加数据策略——简单目标的规模化红利,至今仍跑赢复杂目标的精巧设计。
再追问:为什么"预测下一词"没有被更复杂的目标取代?
因为简单目标与海量数据的组合,胜过复杂目标与有限数据的组合——这是规模化时代反复验证的规律。复杂目标(多任务、结构化监督)在小数据上确实高效,但它们的"每 token 信息密度优势"会被数据量的劣势吞没。近年一些增强(如填空式辅助目标、去噪变体)被尝试过,收益边际。记住这条规律的判断力价值:当有人宣称"新训练目标碾压 CLM"时,先问它验证时的数据量是否在同一量级。
最后一问:能不能自己设计一个新的自监督目标?
可以,而且这是很好的练手——拿一个小语料,设计一个"你认它能逼出某种能力"的目标(比如打乱句子顺序让模型复原,考篇章结构感),训个小模型看效果。多数自创目标会失败(信号太弱或太容易),失败的复盘过程恰恰是最好的学习——你会亲身体会"出题的难度",从此对 CLM 的朴素设计多一分敬意。
本节要点回顾
- 自监督从数据自身构造监督信号(挖空、遮后文、构造正负对),解开标注瓶颈,海量无标注数据首次可用。
- MLM=完形填空,学双向理解(BERT);弱点是数据利用率与生成脱节。
- CLM=逐词续写,训练与使用同构;强大的因果链是"预测准必须真理解 + 语料含推理痕迹 + 规模把考试变难"。
- 对比学习塑造表示空间几何,是嵌入模型与多模态对齐的目标函数,负样本质量决定上限。
- 选择口诀:生成用 CLM、检索用对比、轻量理解用 BERT 式。
目标定了,下一节开炉:千卡集群上把万亿 token 的训练循环稳定跑完,是另一场硬仗。