5.3 预训练过程与优化技巧
5.3 预训练过程与优化技巧
本节摘要:预训练一个千亿模型是一场持续数月的系统工程:数据与模型就绪后,要在千卡集群上把训练循环跑上万亿 token,全程不掉链子。本节讲完整流程、三种分布式并行(数据/张量/管道)的分工与组合、稳定性技巧(warmup、梯度裁剪、混合精度)、故障恢复,最后算一笔成本账,说明为什么多数开发者的主战场在微调而非预训练。
阅读目标
阅读完本节,你应当能够:
- 描述预训练的完整流程与各阶段产出
- 区分数据并行、张量并行、管道并行的工作层次
- 列出防止训练发散的四道防线
- 说明检查点与故障恢复的工程考量
- 估算预训练的成本量级并理解其门槛含义
一、完整流程:从语料到基座
预训练项目的生命周期可以拆成六段,每段有明确的产出与验收:
1. 数据准备(5.1) 产出:token 流(分词后的二进制大文件) 2. 模型初始化 产出:随机初始化的参数(标准差按宽度缩放) 3. 训练循环(2.3 的骨架) 喂 token 流:前向 → CLM 损失 → 反向 → 更新 4. 全程监控 盯损失曲线、梯度范数、硬件状态 5. 检查点管理 定期保存,崩溃可回滚续训 6. 收尾评估 小规模基准 + 采样生成检查,确认基座健康
两个容易外行看不出门道的细节。第一,token 流的工程形态:清洗好的语料会预分词成二进制 token 文件(数万亿 token 约合数十至上百 GB),训练时按需顺序读取——训练框架绝不在训练中临时分词。第二,初始化不是小事:权重随机初始化的标准差要与层宽度匹配,且嵌入层、输出层有专门的缩放策略;初始化错了,训练第一步就发散——这是新手复现训练时最常见的翻车点之一。
二、分布式训练:三种并行的分工
千亿模型一张卡放不下(权重加优化器状态要几 TB 显存),一次训练一张卡也跑不完,必须把"模型"和"数据"都切开分到上千张卡。三种并行各管一个层次:
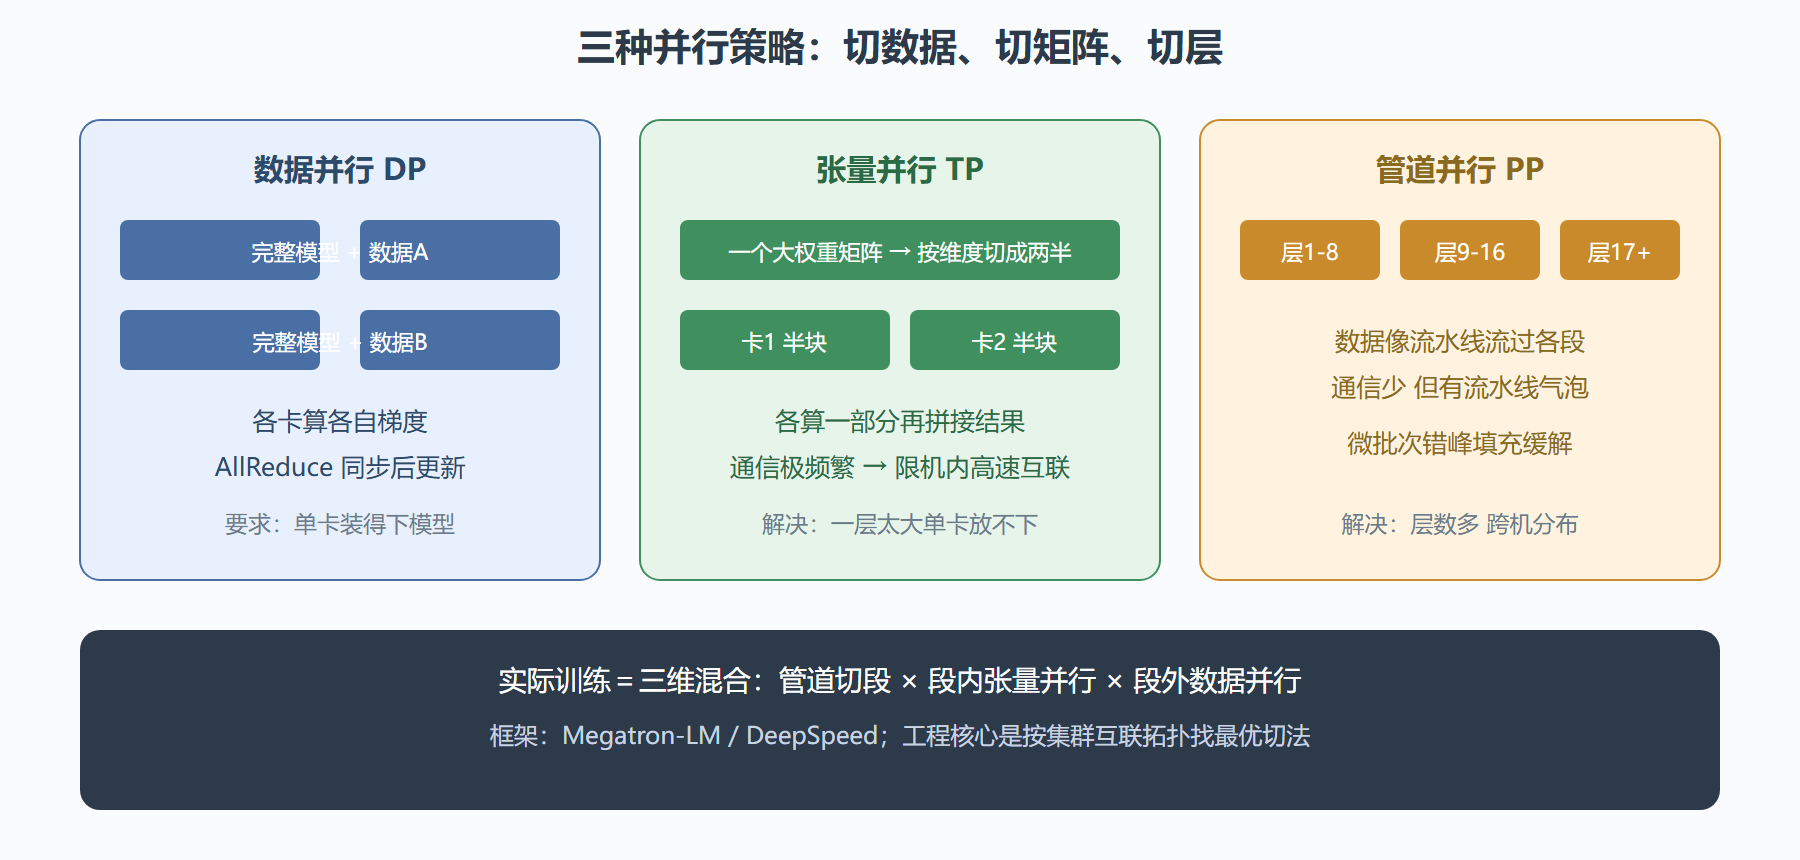
数据并行(DP):每张卡(或每组卡)装一份完整模型,各自处理不同的数据批次,各自算梯度,然后全组同步梯度(AllReduce 通信)统一更新。简单成熟,但单卡装不下整个模型时不可用。
张量并行(TP):把单层的权重矩阵按维度切开分到多卡——一次大矩阵乘法变成多卡各算一小块再拼接。解决"一层太大单卡放不下",代价是卡间通信极频繁,通常只用在一台机器内部的高速互联(NVLink)之内。
管道并行(PP):把不同的层放到不同卡上——第 1–8 层在卡组 A,第 9–16 层在卡组 B,数据像流水线一样流过。通信量小(只传层间激活),但有个"气泡"问题:流水线启动和排空阶段有的卡在等,通过把一个批次切成多个微批次错峰填充来缓解。
实际的大模型训练是三者的三维混合:几百张卡先按管道切成 N 段,每段内部做张量并行,段外再复制多份做数据并行。主流框架(Megatron-LM、DeepSpeed 等)把这些组合做成了配置项。工程师的日常不是发明并行算法,而是根据集群的互联拓扑(卡间带宽、机间带宽)找最优切法——同一笔算力,切法好坏可差出两三成吞吐。
分布式训练并行策略
三、稳定性:四道防线
大模型训练的稳定性问题集中表现为 loss 尖峰与发散(loss 突然飙升或变 NaN),防线的顺序大致是:
- 学习率 warmup + 余弦衰减(2.3 节):最根本的一道。初期梯度方向不可靠,小步试探;峰值的选取参考规模定律与同类模型公开配置。
- 梯度裁剪:每次更新前检查全局梯度范数,超过阈值就等比缩小——发散的保底闸门,几乎所有训练配置默认开启。
- 混合精度 bf16:训练用 16 位浮点(显存减半、速度近乎翻倍)。关键细节:新硬件上的 bf16 格式指数位与 fp32 相同,数值范围不吃亏,比早期 fp16 稳定得多,训练基本告别"精度下溢"这个老病灶;敏感的累加仍用 fp32。
- 架构内置稳定性:Pre-LN/RMSNorm(4.1 节)、合理的初始化——结构性保障,配错则前几步即崩。
即便四道防线齐备,数月训练中遇到 loss 尖峰仍是常态。处置流程也标准化了:暂停 → 回滚到最近健康检查点 → 跳过引发尖峰的数据批次 → 降低学习率或加长 warmup → 恢复。为此检查点策略要做取舍:存太频繁占存储(单个检查点数 TB),太稀疏则回滚损失大。常见折中是近期检查点密、远期稀疏保留。
⚠️ 一个真实的工程事实:公开报告显示,超大规模训练中百分之几的步骤会因硬件或数据问题重启,千卡集群平均几天内必有卡故障。所以"训练能跑完"本身是个可靠性工程问题——冗余存储、备用节点、自动检测换卡,与损失曲线同样重要。
四、成本账:门槛的含义
粗略量级(随硬件价格变化):千亿 token 级训练消耗的 GPU 时数以千万计,千卡集群跑数月,加上电费、人力、数据工程,从头预训练一个旗舰模型的成本在千万美元量级;训一个"能用"的几十亿参数小模型,也需数十万美元级。这份账单决定了行业格局:
- 从零预训练:只有头部厂商与少数研究机构负担得起。
- 继续预训练(在开源基座上灌领域数据):中等成本,企业常用——医疗、法律、金融领域的私有知识注入走这条路,本质是"站在巨人肩上再喂专业课"。
- 微调与后训练:普通团队与个人的主战场,第 6 章的全部内容。
所以理解本节的正确姿势:大概率你不会亲手跑这些,但你需要知道预训练的能力来源与边界——基座的知识截止于训练数据、领域盲区要靠继续预训练或 RAG 补、loss 发散类事故解释了为什么有些模型版本"训坏过"。这些判断力在架构选型与问题诊断时每天都在用。
常见问题
问题:怎么判断预训练"训好了"?
没有单一信号。看损失是否进入平台期、验证集困惑度、小基准曲线、以及采样生成的质量(早期输出乱码、中期通顺但啰嗦、后期连贯有信息量)。实际项目按预设 token 预算停(规模定律决定了预算与效果的对应关系),不等到"收敛"。
问题:训练中途换数据配比可以吗?
可以且常见——课程式训练(5.1 节)就是这么做的,后期提高高质量或目标领域数据浓度。注意换配比时学习率调度的衔接,突变太大易引发不稳定。
问题:个人想体验预训练该怎么做?
从零训一个千万到亿级参数的小模型(如复现一个迷你 GPT),单卡数天可完成,学习价值极高。重点体会数据准备、初始化、学习率调度的手感,而不是追求效果。
六、从小训练学来的四条直觉
即使永远不做预训练,亲自从零训一次小模型(第 10.3 节的动手路线也推荐了)会给你四条纸面学不来的直觉,这里先剧透,供你验证:
直觉一:损失曲线会"说话"。 起步损失约等于均匀猜(对数词表大小),随后快速下降、进入长尾缓降。每一段的斜率变化都有含义——早期不降是学习率或数据出了问题,中期突跳是坏数据或不稳定,尾部平台是正常收敛。训过一次之后,你看到曲线三秒就有判断。
直觉二:发散前有征兆。 损失尖峰前,梯度范数通常先异常增大、验证损失先于训练损失回升。监控这两个领先指标,多数发散可以在变成不可挽回之前处置——这也是正文强调"监控不只是看损失"的原因。
直觉三:数据顺序影响初期走向。 同样的数据换个顺序,前几千步的曲线可以明显不同(梯度噪声的方向不同),但收敛终点的差距远小于过程差异。理解这一点,就不会被"跑了两种配置曲线不一样"迷惑——判断配置好坏要看终段趋势,不看早期抖动。
直觉四:检查点比直觉可靠。 "感觉这次会更好"在训练领域是最贵的错觉。固定评测、按步数对比检查点,让数字说话——这条纪律从最小的实验就要开始养,因为它在最大 的项目里同样适用。
补充:为什么开源权重很少包含训练代码
一个常见困惑:开源社区能看到模型权重,却很少看到完整的训练配方(数据配比、超参曲线、故障记录)。原因有三:数据配比是核心竞争力(5.1 节),超参来自昂贵试错(本节),故障处置日志涉及基础设施细节。技术报告披露的通常是"能讲的八成",复现时剩下的两成要靠自己实验补齐——这也是为什么"完全复现某模型"比想象中难,读论文时对未披露的部分保持敏感,是一种必要的职业素养。
常见追问:什么是"损失尖峰"的常见诱因?
按出现频率排序:坏数据(超长重复、乱码,一个批次就能把训练带偏)居首;学习率在高损失区域偏大次之;混合精度的数值边界问题第三(现代 bf16 已大幅缓解);硬件位翻转这类随机故障最少见但最难排查。处置顺序与频率排序一致:先跳批重试,无效则回滚降学习率,仍无效才怀疑深层问题。这套顺序本身就是各大团队踩坑经验的结晶。
再追问:训练中断后为什么不能简单续跑?
可以续跑但要处理三个衔接:优化器状态要随权重一起恢复(Adam 的动量与方差丢了会导致更新方向突变);数据流要从断点位置继续(重复喂已见数据等于变相多训一轮);学习率调度要接续原曲线(重走 warmup 反而打断节奏)。这正是检查点必须存"权重加优化器加步数"三件套的原因——只存权重的检查点,恢复的代价接近重训。
本节要点回顾
- 流程六段:数据 token 化 → 初始化 → 训练循环 → 监控 → 检查点 → 收尾评估;token 预分词与初始化缩放是易翻车的细节。
- 三种并行:DP 切数据、TP 切矩阵(机内)、PP 切层(跨机),实际为三维混合,切法按互联拓扑优化。
- 稳定性四道防线:warmup+衰减、梯度裁剪、bf16 混合精度、Pre-LN/RMSNorm;尖峰处置靠回滚+跳批+降学习率。
- 千卡集群故障是常态,训练是可靠性工程。
- 成本账决定格局:从零预训练(头部)→ 继续预训练(企业)→ 微调(你);理解预训练的价值在于判断能力来源与边界。
基座出炉只是半成品——它只会续写不会对话。第 6 章讲怎么把基座调教成好用的助手:SFT、RLHF 与参数高效微调。