6.1 微调与监督式微调(SFT/指令微调)
6.1 微调与监督式微调(SFT/指令微调)
本节摘要:预训练模型是"会续写的原料",微调把它加工成"会听指令的产品"。本节讲预训练与微调的边界、监督式微调(SFT)的机制与数据形态、指令微调如何把千百种任务统一成一种行为模式、指令数据的构建方法与质量命脉,以及微调超参的工程直觉。这是从 GPT-3 到 ChatGPT 的第一跳。
学完你能
阅读完本节,你应当能够:
- 划清预训练、继续预训练、SFT、对齐四个阶段的边界
- 写出 SFT 的训练数据格式与损失计算方式
- 解释指令微调的统一性思想及它为何奏效
- 用三条命脉(质量、多样性、格式)评审一份指令数据集
- 设置微调的基本超参(学习率、轮数)并知道何时停
一、先划边界:四个容易混淆的阶段
"微调"这个词被用得太宽,先精确化。从基座到产品,参数被更新的阶段有四个,目的与数据完全不同:
| 阶段 | 数据 | 目的 | 成本量级 |
|---|---|---|---|
| 预训练 | 万亿 token 无标注 | 通用语言与世界知识 | 千万美元级 |
| 继续预训练 | 百亿 token 领域文本 | 注入领域知识(医疗/法律) | 数万美元级 |
| SFT/指令微调 | 万到百万条指令对 | 学会听指令、按格式回答 | 数百到数千美元 |
| 偏好对齐(RLHF/DPO) | 万级偏好排序 | 回答更好、更安全 | 与 SFT 同量级 |
边界意义在于诊断:模型缺知识该补数据(继续预训练或 RAG),缺行为该做 SFT,缺品质该做对齐——很多失败项目的根因是阶段错配,比如想用 SFT 灌知识(数据量差三个数量级,事倍功半),或想靠提示词弥补格式能力(SFT 一小时就能解决)。
二、SFT 的机制:换个数据集的同一循环
SFT(Supervised Fine-Tuning)在机制上没有任何新东西——就是第 2.3 节的训练循环,换成"输入-输出"对的标注数据。数据形如:
输入(prompt):请把下面这段话总结成三点:……(长文) 输出(answer):1. …… 2. …… 3. ……
损失计算有个关键细节:只在输出部分算损失,输入部分不计。模型学的是"给定这个指令,产出这样的回答",而不是学着复述指令。实现上用一个标签掩码把 prompt 部分的损失置零即可——这是自己动手微调时最容易漏掉的一处。
底层损失仍是 CLM 交叉熵(5.2 节):逐 token 预测答案的下一个词。所以更准确的理解是:SFT = 在高质量指令数据上做有监督的续写训练,把"续写什么"导向"回答指令"。
三、指令微调:把千百种任务变成一种行为
早期 SFT 针对单一任务(一个摘要模型、一个翻译模型)。指令微调的关键跃迁是把任务形式统一:
指令:把这句话翻译成英文:…… 指令:用三点总结这段文字:…… 指令:写一个快排函数,带注释 指令:判断这条评论是正面还是负面:……
千百种任务,一种格式(指令-回答)。模型学到的不是每个任务的解法,而是**"看到指令,理解意图,按要求组织输出"这个通用行为模式**。这解释了指令微调的泛化性:训练集里没见过的任务类型,模型也能应对——因为它学的是"听指令"本身,不是任务清单。
FLAN、InstructGPT 等工作系统验证了这条路:数据多样性(任务种类、指令表述)比数据数量对泛化更关键。这和 5.1 节"质量优先"一脉相承——两千条覆盖均匀的指令,好过两万条同质重复。
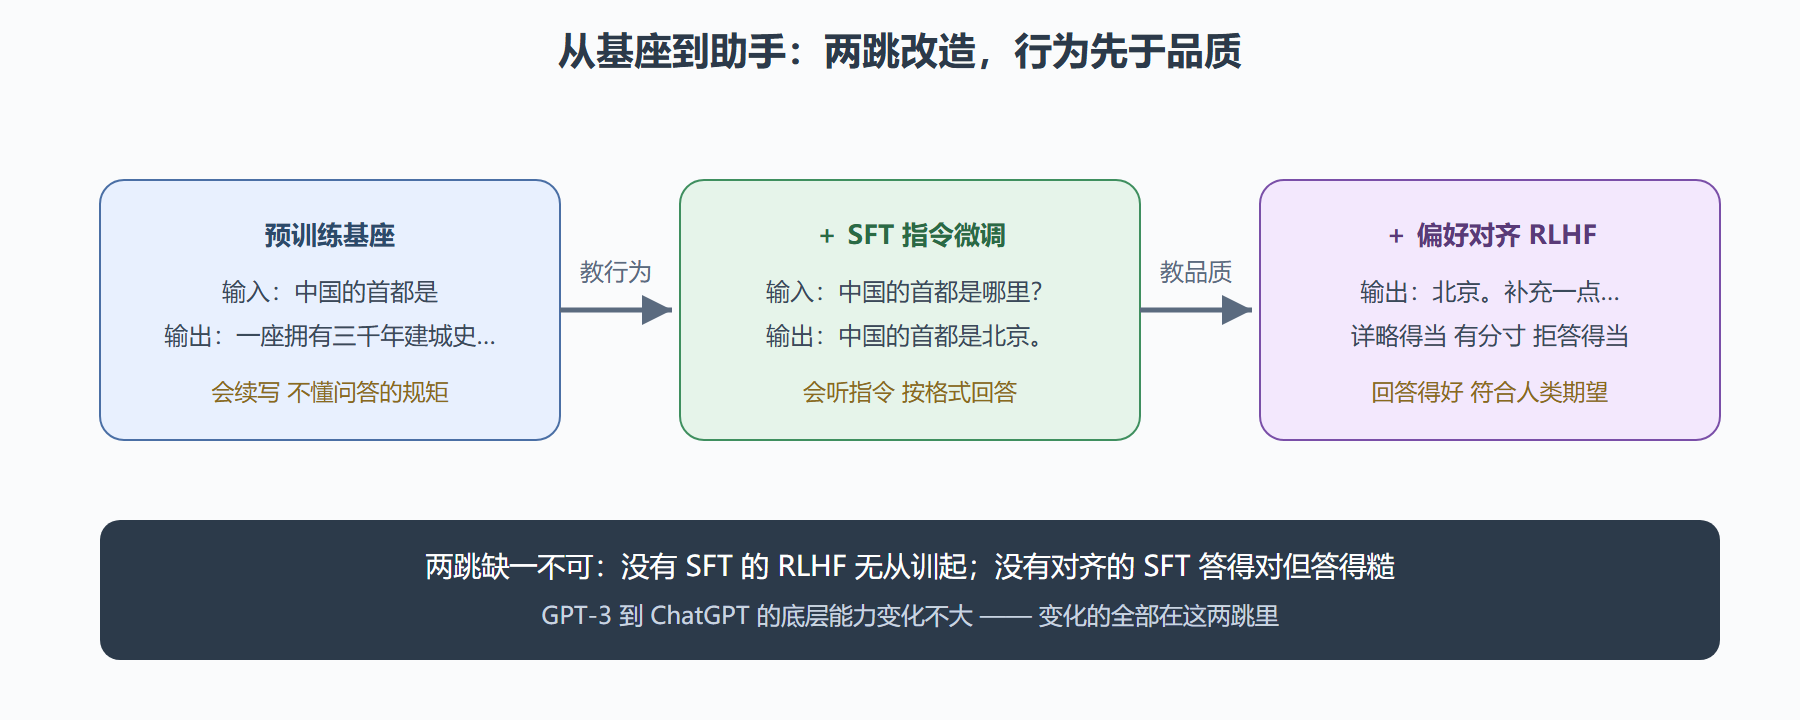
从基座到助手的两跳
四、指令数据怎么构建
指令数据的三条命脉,按重要性排序:
第一条:质量。 每条数据的回答都要"你自己愿意署名"。错例、含糊、前后矛盾的回答会被模型忠实学走。实践做法:小规模人工精写种子数据(几千条足矣)建立质量基线,再决定是否用模型批量扩充。
第二条:多样性。 两个维度都要够:任务类型多样(生成、改写、抽取、推理、代码、闲聊、拒答……)与指令表述多样(同一意图的多种问法)。多样性不足的典型症状:模型只对训练时的问法反应好,换个说法就退化的"模板过拟合"。
第三条:格式与一致性。 想让模型输出 JSON,训练数据里就要有大量规范 JSON 的示例;想要模型"不确定时明说",数据里就要有承认不知道的样例。模型的数据分布就是它的世界观——你不给示例的行为,别指望它无师自通。
获取路径三类:人工编写(质量最高、贵)、强模型蒸馏(用大模型生成指令对再人工抽检,当代主流,注意许可证与"模型输出训练模型"的条款限制)、开源数据集复用(起步方便,但需按自己的场景筛洗)。一个务实的组合:开源数据打底 + 蒸馏扩面 + 人工精写核心场景。
五、微调超参与停机
工程直觉版参数表(7B 级模型、LoRA 或全参适用):
- 学习率:比预训练小一到两个数量级(全参 1e-5 量级、LoRA 1e-4 量级)。太大把预训练能力冲掉(灾难性遗忘),模型"训傻"输出重复。
- 轮数:指令微调常 1–3 轮就够。数据少轮数多极易过拟合——训练损失还在降,实际对话质量已开始变差。
- 止损信号:验证集指标平台或下降、生成出现重复退化、基座原有通用能力明显下滑(拿几个通用问题当"哨兵"每轮测)。
⚠️ 最常见的翻车清单:一,忘了在 prompt 部分掩掉损失;二,学习率照抄预训练量级,几步训傻;三,数据里混入大量同一模板,模型学成复读机;四,只看训练损失不看对话效果——损失降不代表你喜欢输出。四条都是新手实际高频踩的坑,逐条自查能省一周调试。
常见问题
问题:多少条指令数据够用?
按目的分:教基本格式与听指令,几千到几万条即可;特定领域行为(如企业客服话术),一两条高质量种子加蒸馏扩到几千条常见;试图注入知识,多少条都不合适——换继续预训练或 RAG。
问题:SFT 之后通用能力会掉吗?
会,这叫对齐税或灾难性遗忘,程度取决于数据配比与学习率。缓解办法:指令数据里掺一部分通用指令与拒绝样例、控制轮数与学习率、用 LoRA(冻结主干天然保住底层能力)。
问题:指令微调和提示词工程是什么关系?
提示词工程是"不改参数地引导行为",便宜但每次请求都要带长提示;SFT 是"把行为写进参数",一次性成本换推理时的简洁与稳定。顺序建议:先用提示词验证行为可行,验证后高频场景再 SFT 固化——第 1.2 节的选型逻辑在更细粒度上的重演。
六、从一份真实的数据规格说起
给一个可直接参考的指令数据规格,帮以上原则落地。假设目标是客服话术微调,一套两千条的合格数据应包含:
核心场景数据(约六成):高频业务问题的标准问答,覆盖退换货、物流、售后等主要类目,每类至少几十条且问法多样(同一个退换货问题至少五到八种措辞)。回答要符合品牌语气规范,重要场景提供多轮对话(含用户追问)。
边界与拒答数据(约两成):模型不该答的问题(超出业务范围、涉及竞品、需要人工介入的情况)配"礼貌转人工"的标准回答;模糊问题配澄清式回答("请问您指的是订单退款还是运费退款")。没有这类数据,模型会硬答一切问题——客服场景最常见的翻车点。
通用能力保持数据(约两成):闲聊、常识、简单写作等通用指令,防止灾难性遗忘(第 6.3 节的哨兵思路前置到数据层)。
每条数据的格式统一为指令、输入、回答三字段;回答长度与风格在同类内保持一致。这份规格的每个比例都可按业务调整,但三类成分缺一不可——多数失败的微调数据集,缺的正是后两成。
补充:一个数据配比的对照实验
关于正文提到的"通用数据防遗忘",给一个可参考的对照:某团队微调写作助手,纯领域数据训出的版本,写作能力合格但常识问答明显退化;掺入两成通用指令数据重训,通用能力基本保住,领域能力略降三两个百分点;掺到四成,遗忘几乎消失但领域风格明显变淡。两成是这个案例的最优配比——你的最优值要靠自己的哨兵问题测出来,但"两成上下起步、按哨兵表现微调"是可用的初始锚点。
常见追问:微调后的模型还能当通用模型用吗?
取决于微调的深度与数据构成。用 LoRA 且掺了通用数据,通用能力基本无损,适配器摘掉即完全恢复原模型;全参微调且纯领域数据,通用能力会有可感知的退化(对齐税的一种)。生产上的稳妥做法是"专模专用"——微调版只服务目标任务,通用任务走原模型或路由分发,两个版本并存比一个折中版本更清晰,成本增量在 LoRA 场景几乎可以忽略。
再追问:同一个模型可以叠加多次微调吗?
可以但收益递减、风险递增。串行多次微调(在微调版上再微调)容易累积灾难性遗忘;并行多个 LoRA 按需切换(第 6.3 节)是更干净的方案——各任务互不干扰,还能合并使用。经验法则:需要第二项能力时,优先回基座训新适配器,而不是在旧适配器成果上继续训——"从主干分叉"永远比"链式叠加"可控。
最后一问:指令微调的数据能全用模型生成吗?
不建议全生成,混入人工是质量保险。纯生成数据的问题在分布单一(缺少真人提问的杂乱与歧义)与误差遗传(教师的错误风格被学生继承)。推荐比例:人工精写的核心场景至少占两三成,生成数据负责扩面,且生成后必须人工抽检。这个比例不是教条,但"完全无人工"的数据集,几乎必然在某类真实输入上露怯。
本节要点回顾
- 四阶段边界:预训练(知识)→ 继续预训练(领域知识)→ SFT(行为)→ 对齐(品质);诊断问题先定阶段。
- SFT 机制=指令数据上的 CLM 训练,只在回答部分算损失——掩码是最易漏的细节。
- 指令微调的统一性:千百任务统一为"指令-回答",模型学到的是听指令这个通用行为,故能泛化到未见任务。
- 数据三命脉:质量 > 多样性 > 格式一致性;"数据分布就是模型的世界观"。
- 超参直觉:学习率小一到两个数量级、1–3 轮、盯通用哨兵问题防训傻。
SFT 教会了"做什么",下一节解决"怎么做更好"——用人类偏好当训练信号的 RLHF。