6.2 人类反馈的强化学习(RLHF)
6.2 人类反馈的强化学习(RLHF)
本节摘要:SFT 教模型"听指令",RLHF 教模型"答得好"——更符合人类偏好(有用、无害、诚实)。本节讲清"好"为什么写不成规则、三步流程(偏好收集 → 奖励模型 → 强化学习优化)、奖励模型作为"偏好代理"的角色、reward hacking 这一核心风险,以及 DPO 等简化路线如何把对齐做得更便宜。
学习目标
阅读完本节,你应当能够:
- 解释"好回答"为什么无法用规则或损失函数直接定义
- 描述 RLHF 三步流程及每步的输入输出
- 说明奖励模型的角色与它的失败模式
- 理解 KL 惩罚为何必要
- 阐述 DPO 相对 PPO 的简化逻辑
先面对这个问题:好回答写不成规则
SFT 之后的模型会听指令,但回答质量参差:有时啰嗦、有时答非所问、有时一本正经地胡说。想继续优化,遇到一个根本困难——"好"无法形式化。
试着给"好回答"写规则:要准确?多准确算准确,谁核对?要简洁?多短算简洁,会不会牺牲关键信息?要安全?边界在哪?每条规则都能写出反例。更麻烦的是,这些目标之间经常冲突(详细的回答更准确但更啰嗦),权衡本身就是主观判断。
但人类做这个判断毫不费力——给两个回答,一眼排出高下。RLHF 的核心思路由此而来:与其定义"好",不如让人类示范"哪个更好",把这个偏好信号变成训练目标。这也是"对齐"(alignment)一词的由来:让模型的行为对齐到人类偏好上,而人类的偏好是通过比较显形的。
二、三步流程
RLHF 三阶段全景
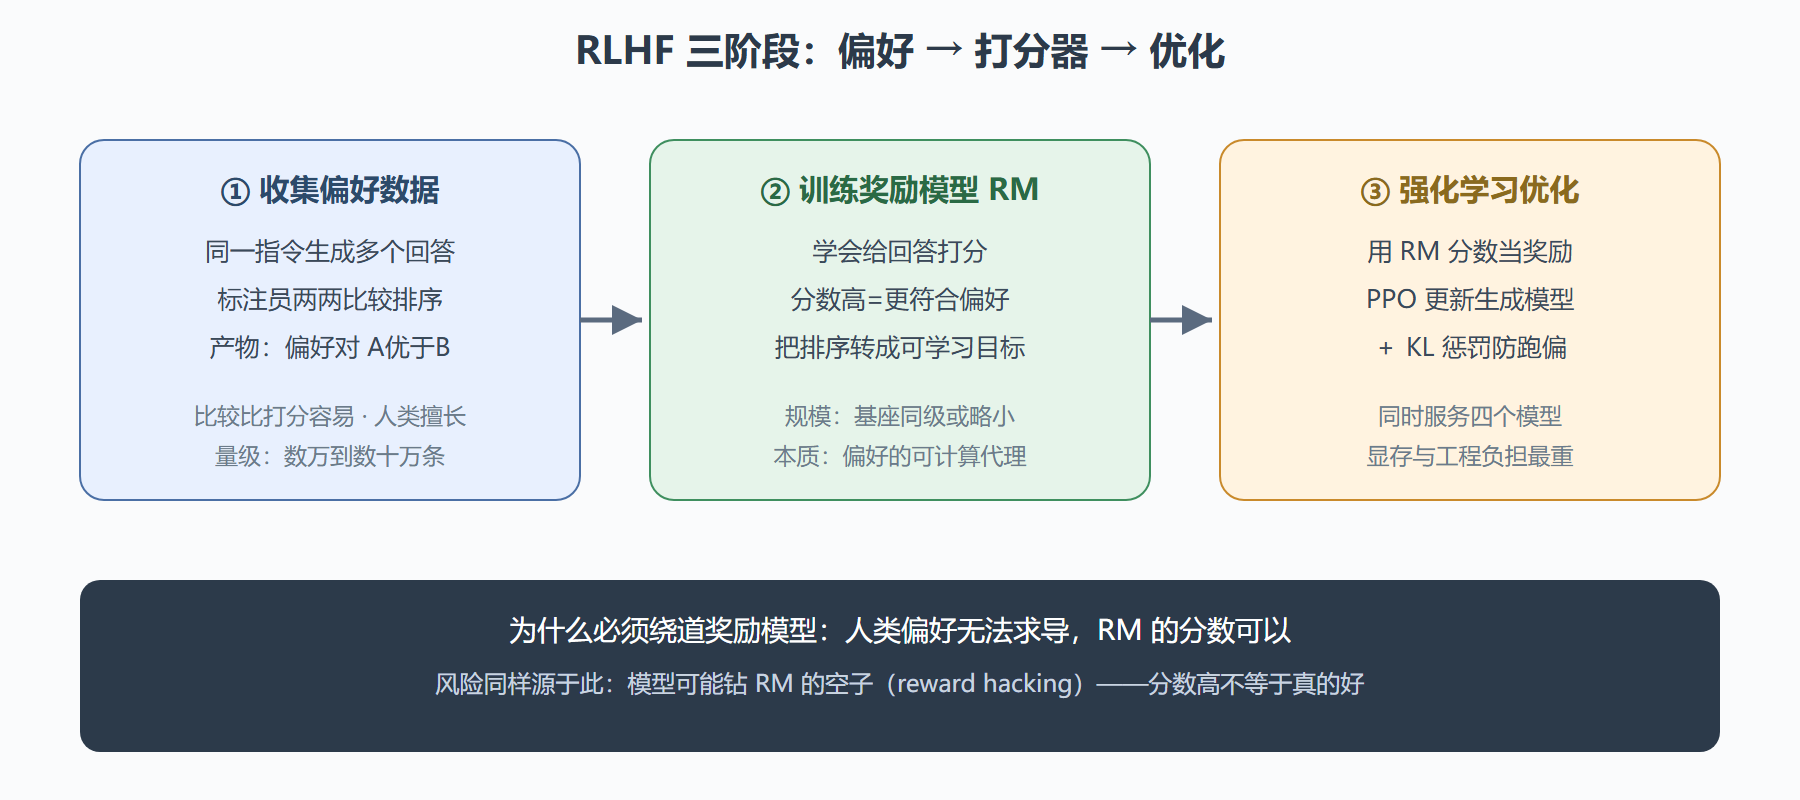
第一步:收集偏好数据。 对同一指令,让当前模型采样多个回答,人类标注员两两比较、给出排序。关键设计是比较而非打分:让人给回答打 1–10 分,不同人标准漂移严重;比较 A 优于 B,一致性高得多——人类天生更擅长相对判断。这一步需要专业标注团队与详细的标注手册(什么算"有害"、详略怎么权衡),是整个流程里人力最重的环节。
第二步:训练奖励模型(RM)。 用偏好对训练一个打分器:输入(指令,回答),输出标量分数,训练目标是让被偏好的回答分数更高。RM 的规模通常与基座同级或略小——太小则学不会微妙偏好。RM 把"人类偏好"这个不可求导的东西变成了一个可求导的分数函数,是整个方案的关键枢纽。
第三步:强化学习优化。 用 PPO 算法微调生成模型:模型生成回答,RM 打分当奖励,策略朝高分方向更新。训练时同时要跑四个大模型(生成模型、参考模型、奖励模型、价值模型),显存与工程复杂度是全流程之最——这也是后面 DPO 兴起的直接原因。
三、KL 惩罚:不能为了高分丢了语言能力
第三步有个必须理解的细节。目标函数不是纯奖励最大化,而是"奖励减去一个 KL 散度惩罚":KL 项度量新模型与 SFT 模型的输出分布差异,惩罚偏离过远。
为什么必须有它?因为纯粹的奖励最大化有一个灾难性捷径:模型发现某些怪异输出模式(重复特定词、胡言乱语的某类格式)恰好能骗过 RM 的高分,就会全力滑向那里——语言能力崩坏,分数很高。KL 惩罚等于给优化套上缰绳:可以变好,但不许变得不像原来的自己。这个"缰绳"的强度(KL 系数)是对齐实践里最敏感的旋钮之一。
⚠️ reward hacking 是对齐的核心风险:RM 只是偏好的代理,代理必然有漏洞。被发现过的高分低质模式包括:堆砌看起来专业的术语、冗长(标注员偏好"信息量大"的表象)、无脑附和用户。缓解靠迭代(定期用新数据重训 RM、人工复核高分样本),但无法根除——这是"代理目标"的宿命,也是对齐持续烧钱的原因。
四、DPO:砍掉强化学习的对齐
PPO 路线工程太重(四模型同显存、训练不稳),催生了简化路线 DPO(直接偏好优化)。它的洞察:可以从偏好数据直接推导出一个与 RLHF 目标等价的监督式损失,跳过 RM 训练与 RL 循环——把"偏好对"当分类问题直接优化策略本身。
| 维度 | RLHF(PPO) | DPO |
|---|---|---|
| 需要奖励模型 | 是 | 否 |
| 需要 RL 循环 | 是 | 否(监督式损失) |
| 工程复杂度 | 高(四模型) | 低(接近 SFT) |
| 效果 | 上限略高、可精细调 | 接近 PPO,某些场景更好 |
| 生态 | 大厂内部管线 | 开源社区主流 |
当代格局大致是:闭源大厂保留 PPO 管线(上限与可控性),开源社区与多数应用团队默认 DPO(性价比)。同族变体还有用 AI 反馈替代人类标注的 RLAIF/Constitutional AI 路线——用强模型按一套原则给回答打偏好,把最贵的人力环节也自动化。
五、为什么对齐带来了体验飞跃
回到历史现场:GPT-3.5 的基座能力在 ChatGPT 发布前就已存在,但直接续写式交互体验平平。是 SFT + RLHF 这两跳让"能力"翻译成了"体验":回答切题(SFT)、详略得当、主动澄清、承认不确定、拒答不当请求(RLHF)。用户感受到的"聪明",相当一部分实为"对齐得好"。
这带来一个对从业者重要的判断:同一个基座,后训练水平不同,产品体验可以差出一档。评估与选购模型时,除了看基座能力,更要看其对齐质量——第 8 章的评测会专门讨论怎么量化这一点。
常见问题
问题:RLHF 会不会让模型变得过于谨慎?
会,这是公认的副作用(过度拒答,拒绝无害请求)。根源是偏好数据里"安全"权重高,模型学出"不确定就拒答"的保守策略。各厂都在"安全与有用"之间做再平衡,这也是对齐持续迭代的内容之一。
问题:人类标注者的偏好就可靠吗?
不完全可靠——标注者之间有文化、专业背景差异,偏好会漂移,还有"长度偏好""格式偏好"等系统性偏差。大厂的做法是写严格的标注手册、多人交叉标注、定期校准。但"偏好数据的质量决定对齐上限"这点不变。
问题:小团队有必要自己做对齐吗?
多数场景没必要:选一个对齐良好的开源模型 + 好的 SFT 已经够用。只有当你需要塑造独特的风格或价值观(品牌人设、特定领域的行为准则)时,小规模 DPO 值得一试——几千条偏好对就能带来可感知的风格变化。
五、对齐的哲学问题:谁的偏好
技术流程之外,RLHF 引出一个绕不开的深层问题:奖励模型学的是"人类偏好"——但谁的偏好?
标注员群体的构成(文化背景、年龄、专业)决定了偏好数据的样子。同一回答,不同文化的标注员对"直接"与"委婉"的评价可以相反;对"安全"的边界理解也随地区与时代变化。模型对齐到的,是这个特定群体偏好的平均值——它未必等于你产品用户的偏好,更未必等于"正确"。
这个认识带来三个务实推论:其一,面向特定市场的产品,偏好数据应包含该市场人群,直接照搬海外模型的对齐设定,水土不服很正常;其二,偏好会漂移,几年前的"理想回答风格"今天可能显得啰嗦,对齐需要定期用新鲜偏好数据迭代——这也是各家旗舰模型频繁更新的隐性原因之一;其三,风格的偏好与价值的底线要分开处理,前者可以本地化定制,后者(不做伤害)应有跨文化的稳定内核。
把这个问题想清楚的团队,做小规模 DPO 定制风格时会更有方向感:你调的不是"更好",而是"更像你的用户想要的"。
补充:对齐对"体感"的改造清单
对齐具体改了什么用户体感?拆开看是一份可感知的清单:回答先给结论再展开(对齐前常见"绕到一半才说重点");不确定时主动声明而非硬答(第 8 章忠实性的产品化);对模糊问题先澄清再作答;对不当请求礼貌拒绝并给替代方向;篇幅自适应(简单问题不写论文)。这份清单也是自查工具——用同样的问题问不同模型,对齐质量的差距肉眼可见。选型时,这份清单比榜单更能预测日常使用体验。
常见追问:小团队能感知到对齐质量的差异吗?
能,而且有简单的办法:准备二十个固定问题(含模糊问题、不当请求、需要承认不知道的问题、格式要求),对你关注的模型逐个提问并记录表现。这个"对齐小测"一小时能跑完,对"体感质量"的预测力常常超过榜单——因为对齐改的正是这些日常交互细节。选型时用它做决赛圈的对比,是低成本高回报的做法。
再追问:为什么不做"直接让人类实时给模型打分"的训练?
成本与速度都不允许:训练需要亿万次参数更新,每次都等人类反馈在物理上不可行——所以必须先把偏好"固化"进奖励模型,让代理替人类打分。这个"固化"正是 reward hacking 风险的来源(代理必然有偏差)。换句话说,RLHF 的架构本身就是效率与保真度的交换:接受代理的不完美,换取训练的可行性。理解这个交换,比记住流程更重要。
最后一问:RLHF 会一直是对齐的主流吗?
"偏好优化"会,"RLHF 的具体形式"未必。从 PPO 到 DPO 到更简单的变体,工程形式在快速简化(去 RL 化);但从人类偏好学习的内核,目前没有替代者——因为"什么是好"的最终裁判仍只能是人。预期未来的演化方向:偏好数据更便宜(AI 辅助标注)、优化更简单(类 DPO)、覆盖更细(多维偏好而非单一排序)。内核稳定、外壳常新,是理解这条技术线的正确姿势。
补记:对齐术语速查
对齐讨论的术语对齐:RLHF 指完整的三步管线;RM 是奖励模型;PPO 是强化学习优化算法的名字;DPO 是跳过 RM 的直接偏好优化;RLAIF 指用 AI 反馈替代人类反馈;对齐税指对齐带来的能力损失。这些缩写在技术新闻里高频出现,混为一谈会导致理解错位——对齐这一页,建议截图贴在工位上一个月。
本节要点回顾
- 核心困难:"好"无法写成规则,但人类擅长比较——偏好数据因此成为可能。
- 三步:偏好收集(比较式标注)→ 奖励模型(偏好代理)→ PPO 优化(带 KL 缰绳)。
- KL 惩罚防语言能力崩坏;reward hacking 是代理目标的宿命风险,靠迭代缓解、无法根除。
- DPO 跳过 RM 与 RL,把对齐做成监督式训练,成为开源主流;RLAIF 进一步把人力也自动化。
- 体验飞跃的真相:同一基座,对齐水平决定产品档位——评估模型要评对齐质量。
行为与品质都有了,下一节解决钱包问题:LoRA 等参数高效微调怎么把成本砍掉两个数量级。