6.3 参数高效微调(PEFT)与微调评估
6.3 参数高效微调(PEFT)与微调评估
本节摘要:全参数微调一个 70 亿模型要上百 GB 显存,普通团队望而却步。PEFT(参数高效微调)冻结原模型、只训练极少量新增参数,代表方法 LoRA 用低秩矩阵逼近权重变化,把可训练参数压到千分之一量级,效果接近全参微调。本节讲 LoRA 的原理与工程用法、PEFT 各方法对比,以及微调效果评估的完整闭环。
学习目标
阅读完本节,你应当能够:
- 算清全参数微调的显存账,解释为什么贵
- 解释 LoRA 的低秩假设与计算方式
- 对比 LoRA、Prefix/Prompt Tuning、Adapter 的优劣
- 给出 LoRA 的实用参数配置(秩、作用位置、学习率)
- 搭建微调评估闭环,识别过拟合与灾难性遗忘
一、全参数微调的显存账
先算账,才能体会 PEFT 的分量。训练状态下,显存装的不只是模型权重:
以 7B 模型、混合精度 + AdamW 为例(每参数字节数粗算): 权重(bf16) 7B × 2 ≈ 14 GB 梯度(bf16) 7B × 2 ≈ 14 GB 优化器状态(fp32 动量+方差+主权重) 7B × 12 ≈ 84 GB ────────────────────────────────── 合计 ≈ 112 GB(还没算激活值)
结论:7B 模型全参微调需要一张 80GB 级专业卡的量级,70B 需要多卡并行——而推理同一个 7B 模型只要 14 GB。训练比推理贵一个数量级,贵在优化器状态。这份账也解释了第 5 章预训练为什么必须三维并行。
二、LoRA:低秩适配
LoRA(Low-Rank Adaptation)的出发点是一个经验观察:预训练权重本身是"满秩"的巨大矩阵,但微调引起的变化量是低秩的——微调只需在原有权量空间里做少量方向上的调整,不需要动全部自由度。
具体做法。设某层原权重矩阵为 W(比如 4096×4096),全参微调学的是变化量 ΔW。LoRA 把 ΔW 分解为两个小矩阵的乘积:
W' = W + B·A 其中 A:r×4096,B:4096×r,秩 r 通常取 8~64
原 W 冻结不动,只训练 A 和 B。参数量从 1600 万降到 2×4096×r(r=16 时约 13 万,千分之一量级)。初始化有讲究:A 随机初始化、B 置零,保证训练开始时 B·A=0,模型行为与原模型完全一致,从"不损害"起步。
工程上的三大红利:
- 显存骤降:优化器状态只覆盖 A、B,7B 模型的 LoRA 微调在一张消费级显卡(如 24 GB)上可跑。
- 适配器即插即用:训好的 LoRA 权重只有几十 MB,一个基座配一组 LoRA,客服版、法律版、写作版随装随换——基座放显存一次,服务多个业务。
- 无推理延迟(可合并):部署时把 B·A 直接加进 W,前向计算量与原模型相同(不像 Adapter 有额外层)。
实用配置的经验值:秩 r 取 8–16 起步(任务复杂、数据多再加大);作用位置默认打在注意力投影矩阵,进阶做法把 FFN 也覆盖(4.1 节的参数账说过 FFN 占大头,加上它效果常更好);学习率比全参大一个数量级(1e-4 量级)。变体 QLoRA 更进一步——把冻结的基座量化成 4 bit 再训 LoRA,一张卡就能微调 30B 级模型,是个人开发者的事实标准。
三、PEFT 方法谱系对比
LoRA 之外还有两族主流方案,一起放进对比矩阵:
PEFT 方法对比矩阵
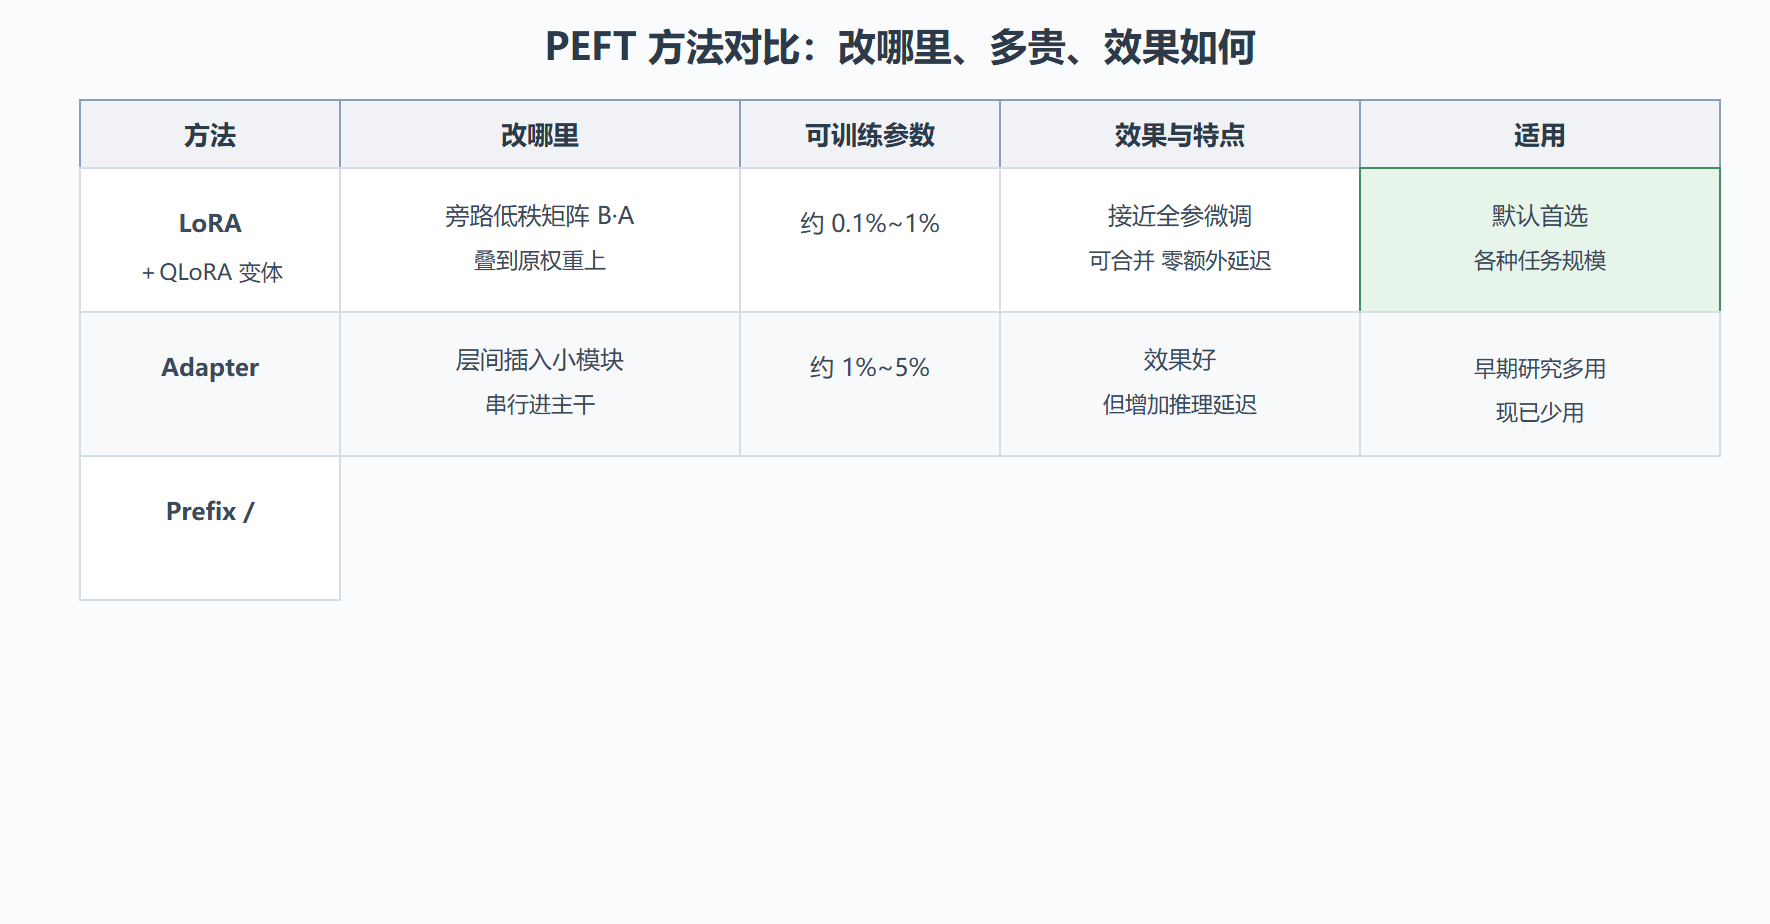
Prompt Tuning 值得单独一句:它只训输入前的一段虚拟 token 向量,参数最少,但在中小模型上效果明显弱于 LoRA,且软提示要占上下文窗口。历史上 LoRA 凭"效果接近全参 + 零部署成本"胜出,成为开源生态的通用货币——社区流通的大量"某某领域微调版"实际是"基座 + 几十 MB 的 LoRA 权重"。
四、微调评估闭环
训练跑完不等于做对了,评估闭环四步缺一不可:
第一步:对比基座,确认提升真实存在。 同一批测试问题,微调前(用零样本或few-shot 提示)与微调后各跑一遍。微调的价值 = 增量,不报告基线对比的"准确率 92%"没有意义。
第二步:任务指标 + 生成质量双轨。 可结构化判分的任务(分类、抽取、格式输出)用自动指标(准确率、F1、格式合法率);开放生成没有唯一正确答案,自动指标(BLEU 类)与人的判断相关性弱,需要抽样人工评审或用强模型当裁判(第 8 章展开的 LLM-as-judge)。
第三步:过拟合检查。 训练损失降、验证指标不升反降是典型信号。指令微调数据少,过拟合来得早,1–3 轮常已足够。保留一份不参与训练的验证集是底线纪律。
第四步:回归检查(防灾难性遗忘)。 拿一组与任务无关的通用问题(常识、写作、代码各几道)当哨兵,每轮微调后跑一遍。哨兵得分大幅下滑说明通用能力被冲掉——要么降学习率/轮数,要么在训练数据里掺通用指令,要么改用 LoRA(冻结主干天然护住底层能力)。
⚠️ 最常见的评估坑:只看训练损失就宣布成功。损失反映"拟合训练数据",不反映"产品上更好用"。还有一个隐蔽坑:测试集与训练集分布太像(同模板、同来源),指标虚高,一上线遇到真实表达的多样性就退化——留出一批"野生"的真实用户问法做测试,比什么都灵。
常见问题
问题:LoRA 的秩 r 越大越好吗?
不是。r 大容量大,但过大的 r 在小数据上过拟合更快、显存也更费,且收益递减。经验:r=8~16 覆盖多数场景,效果不够先扩作用位置(加 FFN)再考虑加 r。
问题:LoRA 微调后能学到新知识吗?
学不深。LoRA 擅长塑造行为(格式、风格、流程),注入知识需要数据量级支撑,PEFT 的小参数量与少数据量都不匹配。缺知识走 RAG(检索补充)或继续预训练——阶段错配问题在 6.1 节讲过,这里再次应验。
问题:多个 LoRA 能同时用吗?
可以,相关技术叫 LoRA 合并或多适配器服务:把不同任务的 LoRA 各自挂在同一基座上,按请求路由切换。这是"一份基座显存服务多业务"的部署模式基础,第 7 章的服务化部署会再遇到它。
五、一次 LoRA 微调的完整工作流
把本节与 6.1 节的内容组装成一份可执行的工作流,第一次做微调的团队照着走即可:
第一步,基线测量。在目标任务的评测集(两百条真实样本)上测零样本与少样本提示的成绩,记录为基线。没有基线的微调是盲飞。
第二步,数据就绪。按 6.1 节规格准备一到三千条数据,过一遍 5.1 节的五查清单(去重、分布、质量、泄漏、安全),划分训练验证集。
第三步,配置选择。LoRA 起步配置:秩十六、作用在注意力投影与 FFN、学习率万分之一量级、训练一到两个轮数、批大小按显存上限。基座选量化版可把硬件门槛再降一档。
第四步,训练与监控。每保存一个检查点,就在验证集上评一次任务指标,同时跑十个通用哨兵问题看能力保持。任何一步哨兵大幅退化即回退。
第五步,验收。最终模型与基线在完整评测集对比,报告分维度成绩;抽样二十条人工终审;确认提升幅度值回训练成本。
第六步,部署衔接。合并权重或以适配器形式挂载(第 7.3 节多适配器服务),入发版回归流程。
六步全流程在一块单卡上通常一两天内完成——这正是 PEFT 把微调"平民化"的实感:门槛不再在算力,而在数据质量与评估纪律。
补充:LoRA 与全参的鸿沟何时出现
LoRA 并非万能,三种情况建议直接上全参:一是行为改动幅度大(如让通用模型脱胎换骨成领域专家,涉及大量知识重组);二是训练数据上万条且质量极高(容量成为瓶颈);三是对齐阶段做深度偏好重塑(DPO 的 LoRA 版有时不够细腻)。反之,格式遵循、风格迁移、单任务适配这些"行为手术",LoRA 与全参的差距通常在小数点后。判断口径一句话:改动越靠近"知识",越需要全参;越靠近"行为",LoRA 越划算。
常见追问:LoRA 训练到底要多少条数据、多少时间?
给一组经验参考:千条级精洗数据、单张消费级显卡,一个 LoRA 微调通常几小时内完成(7B 级模型);数据少到两三百条也能改变格式与风格,只是稳定性下降;上万条后收益递减,且需要开始警惕过拟合。时间成本的大头永远不在训练本身,而在数据清洗与评估闭环——这再次印证第 5.1 节的结论:质量与纪律,才是微调的真正瓶颈。
再追问:不同任务的 LoRA 可以合并吗?
可以,LoRA 的线性结构(B·A 直接加到权重上)让多个适配器可以加权合并成一个,且常出现"能力组合"的正效应(代码适配器加写作适配器,代码注释质量提升)。但负效应也存在:风格冲突的两个适配器合并可能互相稀释。工程建议:合并前在两个任务的评测集上分别回归验证,正效应留下、负效应改用切换式部署。合并是免费的实验,值得常做。
最后一问:PEFT 的极限在哪里?
理论上限是"达到全参微调的效果",实践中多数任务已逼近;真正的极限出现在知识与结构的深层改动上(LoRA 补不了缺失的知识体系)。另一个正在被突破的方向是"更少的参数"——从千分之一到万分之一的研究持续出现,但参数越少对数据质量越敏感。给实践者的判断:把 PEFT 当默认,把全参当特种手段,这个原则近几年内都不会过时。
补记:参数量级速记表
PEFT 相关的数字速记:LoRA 典型可训练占比千分之一到百分之一;秩常取八到六十四;QLoRA 让七十亿模型微调的显存门槛降到二十 GB 级;单个 LoRA 适配器文件几十 MB。这四个数字记牢,讨论成本与可行性时可以即问即答——工程讨论的流畅度,很大程度上就是这类量级记忆的积累。
最后补一道动手题:访问任意开源模型社区,找到该模型下载数最高的三个 LoRA 适配器,看看它们各自微调了什么(风格、任务还是语言)——你会直观看到 PEFT 生态的真实形态:一个基座之上,社区用几十 MB 一个的适配器长出了一整片应用森林。这一眼看到的生态繁荣,比任何论文数字都更能说明"参数高效"四个字的分量。
本节要点回顾
- 显存账:训练贵在优化器状态(7B 全参约 112 GB),比推理贵一个数量级。
- LoRA:ΔW ≈ B·A 低秩分解,冻结原权重只训千分之一参数,效果接近全参;可合并零延迟、适配器即插即用;QLoRA 让单卡微调 30B 可行。
- 谱系结论:LoRA 是默认首选;Adapter 有延迟、Prefix 小模型偏弱;全参仅数据与算力都充裕时考虑。
- 评估闭环四步:对比基座 → 双轨指标 → 过拟合检查 → 通用哨兵回归;"野生"测试集防指标虚高。
- 阶段匹配再确认:行为用 PEFT、知识用 RAG/继续预训练。
模型调教完毕,第 7 章进入交付环节:怎么把它以可控的成本、足够的速度跑在生产环境里。