7.1 推理过程与加速技术
7.1 推理过程与加速技术
本节摘要:推理是大模型成本的主战场。本节先解剖自回归生成的两个阶段(预填充与解码)找到真实瓶颈,再逐层拆解加速手段:KV 缓存消灭重复计算、连续批处理榨干 GPU 并行、FlashAttention/PagedAttention 优化计算与显存管理、投机解码用小模型带大模型。理解这些技术的层次关系,是用好 vLLM 等推理框架的前提。
学习目标
阅读完本节,你应当能够:
- 区分预填充与解码两个阶段及其不同的瓶颈
- 推导 KV 缓存的收益与显存代价公式
- 解释静态批处理为何低效、连续批处理如何解决
- 说明 FlashAttention 与 PagedAttention 各自优化什么
- 描述投机解码的草拟-验证机制
瓶颈诊断:自回归生成的两阶段
大模型生成是自回归的:一次产一个 token,产出的 token 拼回输入再产下一个。把这个过程拆开,实际包含两个性质完全不同的阶段:
预填充阶段(Prefill):处理用户的整个输入(可能几千 token)。这一步所有位置可并行计算(矩阵乘法吃满 GPU),算力受限(compute-bound)——快,但一次性消耗大量计算。用户感知的"首 token 延迟"主要由它决定。
解码阶段(Decode):逐个生成输出 token。每步只算一个新 token 的向量,矩阵乘法退化成向量乘矩阵——算力吃不满,瓶颈在显存带宽(memory-bound):GPU 大部分时间在等权重从显存搬进计算单元,计算单元本身大量空转。生成 1000 个 token 就重复 1000 次这样的"搬运"。
这个诊断直接决定药方:解码阶段既然是带宽瓶颈,优化方向就是减少搬运次数(KV 缓存:别重算历史)、每次搬运干更多活(批处理:一次搬运服务多个请求)、搬更少的数据(第 7.2 节量化:低精度权重更小)。整章的优化技术都能挂到这三句话上。
二、KV 缓存:推理优化的第一块基石
朴素实现下,生成第 1000 个 token 时要把前 999 个 token 重新过一遍模型——而其中 998 个的中间结果上一步就算过。KV 缓存把这些中间结果(每层的 Key 和 Value 向量,3.3 节的老朋友)存下来,每步只算新 token 的 K/V 追加进缓存,再用新 token 的 Q 与缓存中所有 K 做注意力。
收益巨大:每步计算量从"整个序列过模型"降到"一个 token 过模型",长文本生成从平方级降到接近线性。
代价是显存。缓存量随序列长度线性增长,量级可以估出来:
KV 缓存显存 ≈ 2 × 层数 × 隐藏维度 × 序列长 × 字节数 × 批大小 例:32 层 × 4096 维 × 4096 token × 2字节 × 2(K和V) ≈ 每 4K 上下文 2 GB(单请求)
单看不大,但乘上并发请求数就可怕:一百个并发长上下文请求,KV 缓存要吃掉 200 GB——长上下文服务的显存大头不是权重,是缓存。这也解释了两个现象:其一,注意力里的 KV 头数被专门压缩(分组查询注意力 GQA,多个 Q 头共享一组 KV,缓存直接除以分组数);其二,PagedAttention(下文)这种"缓存管理技术"能成为 vLLM 的成名作——显存管理的浪费,就是吞吐的直接损失。
三、批处理:从等齐到流水
单请求解码时 GPU 大量空转(带宽瓶颈的另一面),把多个请求拼成一批同时算,一次权重搬运服务多个请求,吞吐近似线性提升。
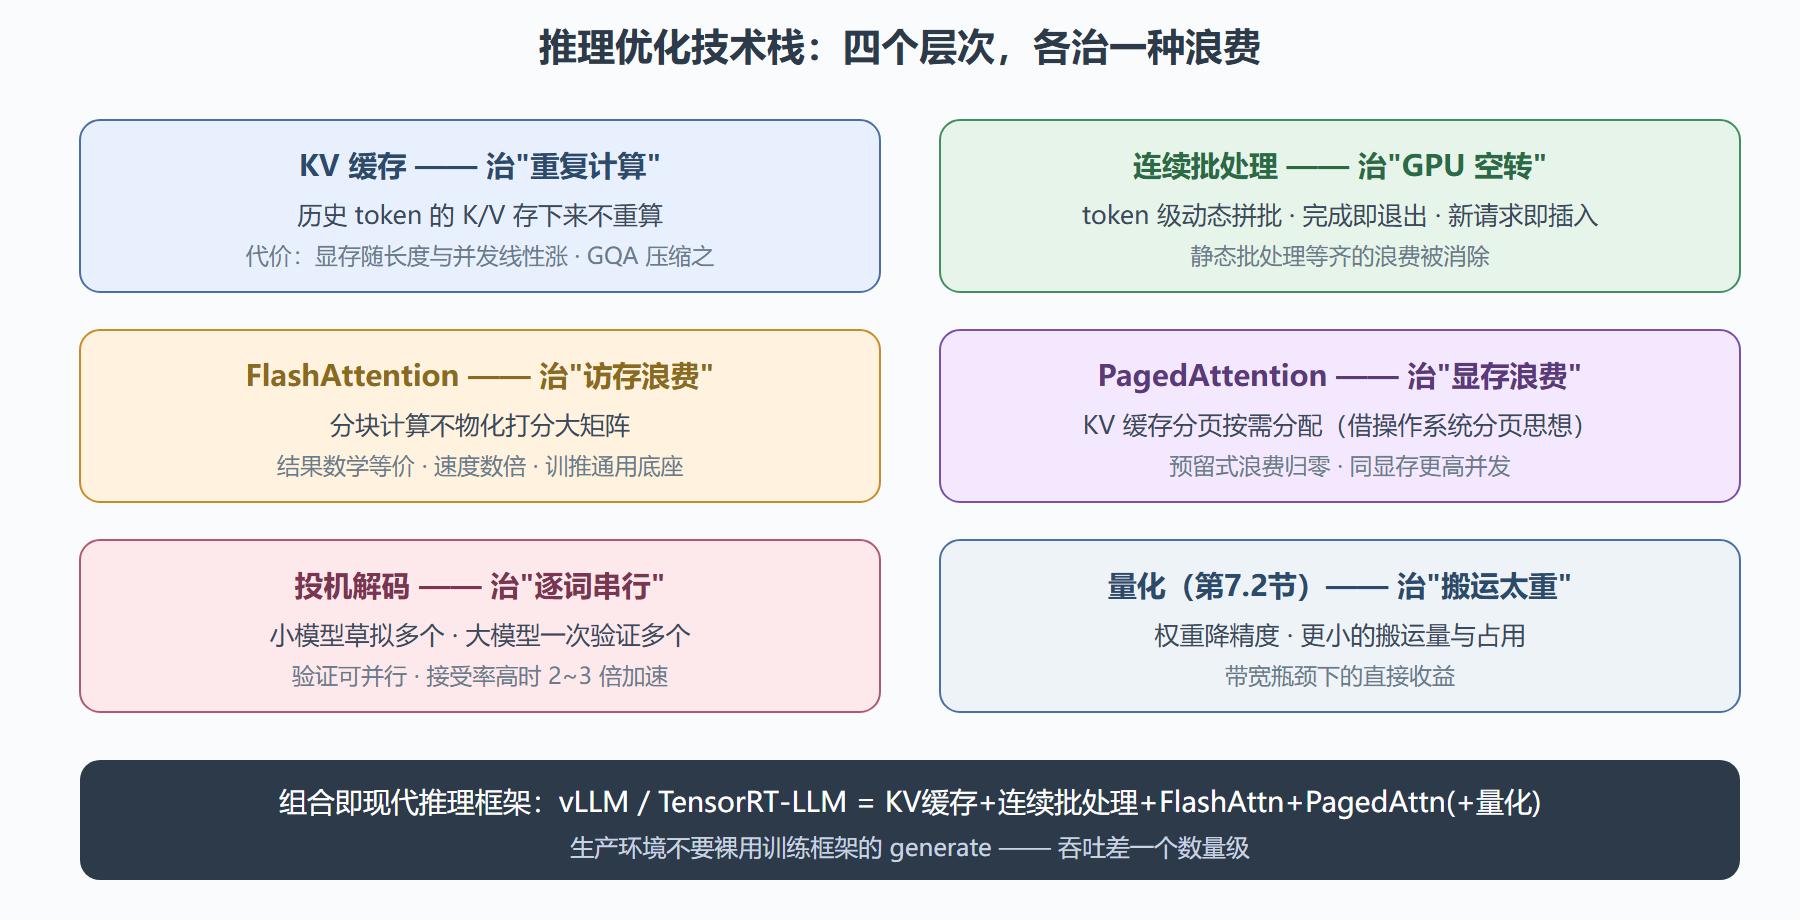
但朴素静态批处理有个致命伤:批内请求长短不一。先生成的请求要等最长的那个完成才能整批释放,短请求的算力被白白占用。连续批处理(continuous batching)解决它:调度器逐 token 级动态调度——完成的请求立刻退出、新请求立刻插入空位,GPU 始终满载。这是 vLLM、TensorRT-LLM 等现代推理框架吞吐优势的核心来源,配合 PagedAttention 的显存管理,同硬件吞吐提升可达数倍到十倍级。
四、注意力优化的两个层次
FlashAttention:算得更快。 标准 attention 要把"序列长 × 序列长"的打分矩阵完整写进显存再读回——访存开销巨大。FlashAttention 利用 GPU 显存分层的结构,把注意力计算分块搬进高速缓存(SRAM)里算完再聚合,不物化完整打分矩阵。数学结果完全一致,速度数倍提升,还顺带降低了激活显存。今天它已是训练与推理的默认底座。
PagedAttention:存得更省。 传统实现给每个请求的 KV 缓存按最大长度预留连续显存,请求实际用不满就浪费(类比操作系统早期的固定分区内存管理)。PagedAttention 借鉴操作系统的分页思想,把缓存切成小块按需分配、逻辑连续物理离散——缓存浪费从大比例降到接近零,同等显存能塞下更多并发,吞吐再上一个台阶。
推理优化技术栈
五、投机解码:用小模型打草稿
解码阶段的串行性(第 t+1 步依赖第 t 步)看似无法并行,投机解码绕了个弯:让一个小模型(或模型的草稿头)快速猜出接下来 k 个 token,再让大模型一次前向同时验证这 k 个猜想。验证是并行的(预填充式的批量计算,正中大模型下怀);猜对了,一步产出 k 个 token;猜错了,回退到第一个错位,损失一步。
加速比取决于接受率:文本可预测性强(代码、格式化输出)时小模型猜得准,两三倍加速常见;自由创作类文本收益较低。妙处在于输出分布与原模型严格一致(验证机制数学上保证),是无损加速——这与量化(有损)形成对照。
⚠️ 生产环境第一坑:直接拿训练框架的生成函数上生产。它没有连续批处理、没有 PagedAttention、并发一上来吞吐塌方。正确姿势是推理框架(vLLM、TensorRT-LLM、SGLang 等)或本地场景用 Ollama/llama.cpp。第二个坑:只测单请求延迟不看吞吐——延迟与吞吐在批处理下是跷跷板(批越大吞吐越高、单请求延迟越长),要按业务 SLA 找平衡点,7.3 节展开。
常见问题
问题:为什么解码阶段 GPU 利用率很低是正常的?
因为瓶颈在显存带宽不在算力:每步只处理一个 token,计算量很小但要搬全部权重。批处理与量化正是分别从"摊薄搬运"和"减少搬运量"下手。
问题:首 token 延迟和整体吞吐,优先优化哪个?
看产品形态:聊天类产品对首 token 延迟极敏感(用户盯着屏幕等第一字);批处理类任务(离线摘要、数据标注)只关心总吞吐。两者的优化手段部分冲突(如批大小),先定 SLA 再调参。
问题:长上下文为什么贵得离谱?
三重成本叠加:预填充计算随长度线性涨、注意力计算随长度平方涨(FlashAttention 缓解不消除)、KV 缓存显存随长度线性涨(并发能力被压缩)。所以"把整个知识库塞进上下文"在成本上通常打不过 RAG 按需检索。
六、用数字建立推理成本的体感
抽象机制配上具体数字才有决策力。以一个七千亿亿分之一量级——更正为七十亿参数、fp16 精度的模型为例,给一组量级参考(不同硬件有差异,重在相对关系):
单请求短对话(输入五百、输出两百 token):首字延迟在百毫秒级,生成速度约每秒几十个 token。用户体感流畅的底线大约是每秒二十个 token 以上——低于这个速度,打字机效果就变成煎熬。
批处理收益:单卡串行处理请求时 GPU 大量空转;连续批处理把并发数十个请求拼批后,总吞吐可提升数倍到十倍级——同等硬件服务人数的差距,就是"裸用生成函数"与"推理框架"的差距。
上下文成本:输入一万 token 相对一千 token,预填充计算约十倍、KV 缓存约十倍显存——长上下文的贵不是线性感而是结构性的(平方项在注意力部分)。这解释了为什么"把整个知识库塞进提示词"在成本上打不过检索增强。
延迟分布:批处理系统里同一请求的延迟方差很大,高峰期排队时 P99 可以是平均值的好几倍——所以服务等级承诺要看分位数,平均值在高峰期毫无意义。
记住这组相对关系(而不是绝对数),你就能在架构评审时快速判断"这个方案的成本与体验是否现实",不需要等压测报告。
补充:推理框架选型的三问
面对 vLLM、TensorRT-LLM、SGLang 等选择,与其比参数,不如回答三个问题:你的模型是否被目标框架良好支持(量化格式、架构变体)?你的负载是延迟敏感还是吞吐敏感(不同框架的调度倾向不同)?团队维护能力如何(更新频率、社区活跃度、排错资料)?三问之后往往只剩一两个候选,再用自家流量画像压测定夺。框架没有绝对优劣,只有与负载和团队的匹配度。
常见追问:为什么推理优化很少改模型结构?
因为训练与推理的责任分离:改结构要重训(成本回到第 5 章量级),而系统层优化(缓存、批处理、调度)不动权重、即插即用。只有当系统层红利吃尽(如长上下文的显存墙),架构层的改动(如 GQA、线性注意力)才被提上日程——而且通常由模型厂商在新版本里统一解决。对应用团队而言,"用好推理框架"永远是性价比最高的优化,结构创新留给上游。
再追问:首 token 延迟有没有理论下限?
有,且由三段构成:网络往返(物理限制,数十毫秒起)、预填充计算(与输入长度成正比,长输入天然慢)、排队等待(并发高时主导)。认清构成就能对症:网络段靠就近部署,预填充段靠并行与前缀缓存,排队段靠容量与调度。想把百毫秒级做到极致的团队,最终都在这三段里分别抠毫秒——延迟优化没有银弹,只有分段治理。
最后一问:推理优化有没有尽头?
短期内没有,因为两端都在动:模型端上下文持续变长、推理增强让"思考"本身变贵;硬件端算力与带宽的增速追不上需求的膨胀。这决定了推理工程是一个持续专业——今天学的具体技术五年后会换一批,但"找瓶颈、分而治之、用数字说话"的方法论会一直有效。这也是本章用大量篇幅讲机制而非罗列工具的原因。
本节要点回顾
- 两阶段诊断:预填充算力受限(决定首 token 延迟),解码带宽受限(决定生成速度)——一切优化挂在这两个诊断上。
- KV 缓存消灭重复计算,代价是显存随长度与并发线性增长;GQA 压缩、PagedAttention 分页管理。
- 连续批处理逐 token 调度消灭"等齐浪费",是推理框架吞吐优势的核心。
- FlashAttention 治访存(不物化打分矩阵),PagedAttention 治显存浪费(分页按需分配)。
- 投机解码小模型草拟大模型验证,输出无损、可预测文本上加速明显。
- 生产铁律:用推理框架,别裸用 generate;延迟与吞吐按 SLA 平衡。
单请求跑快了,下一节把模型本身变小变省:量化、剪枝、蒸馏三件套。