7.2 模型压缩:量化、剪枝与蒸馏
7.2 模型压缩:量化、剪枝与蒸馏
本节摘要:7B 模型 fp16 要 14 GB 显存,70B 要 140 GB——不压缩,大模型就锁死在数据中心。本节讲压缩三件套:量化(降数字精度,改动最小收益最大,是绝对主力)、剪枝(删冗余参数,工程收益有限)、蒸馏(大教小,得到小而强的新模型),并给出三者的选择顺序与叠加方式。
阅读目标
阅读完本节,你应当能够:
- 解释量化的原理与"精度-成本"曲线
- 说出 int8 与 int4 量化的显存收益和风险差异
- 区分训练后量化与量化感知训练
- 说明剪枝在大模型中为什么用得少
- 描述蒸馏的数据流并判断何时值得做
一、量化:把数字变小数点变少
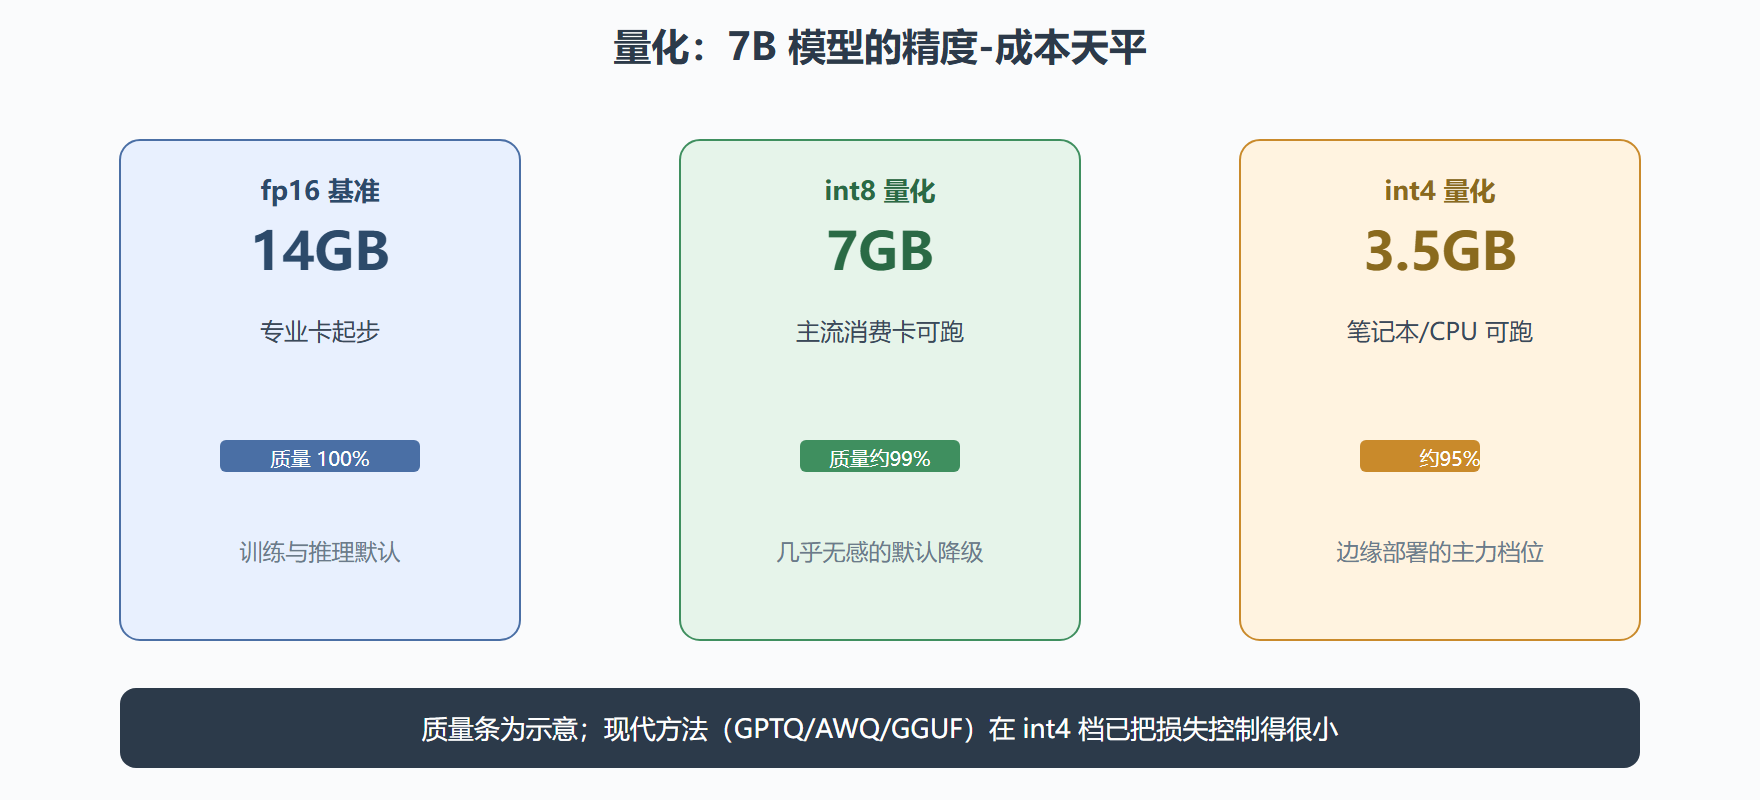
模型参数原本用 16 位浮点数(fp16)存储。量化的想法朴素:大多数参数的有效信息用不了 16 位,用 8 位甚至 4 位整数存,信息损失很小,体积与搬运成本直线下降。实现上是把一段浮点范围映射到整数刻度上(存一个缩放因子 + 整数)。
先看收益表(以 7B 模型为例):
| 精度 | 权重体积 | 硬件门槛 | 质量损失 |
|---|---|---|---|
| fp16 | 约 14 GB | 专业卡 | 基准 |
| int8 | 约 7 GB | 主流卡 | 很小 |
| int4 | 约 3.5 GB | 消费级卡甚至 CPU | 可感知但可控 |
量化精度-成本对比
量化技术的几个关键概念:
训练后量化(PTQ)与量化感知训练(QAT)。PTQ 拿现成模型直接转格式,几分钟完成、无需数据与训练——绝大多数场景用它。QAT 在训练/微调过程中模拟量化误差,让模型学会"在低精度下也好",质量更好但要训练成本。默认路线:先 PTQ,质量不达标再 QAT。
主流格式与方案:GGUF(llama.cpp 生态,CPU/消费卡本地运行的标准,支持按需分层加载)、GPTQ 与 AWQ(GPU 推理的经典后训练量化,AWQ 通过保护"重要权重"减小 int4 损失)、以及 fp8(新硬件原生支持的中间档,训练推理都在用)。选型跟着运行环境走:本地笔记本 GGUF,GPU 服务 AWQ/GPTQ。
误差来源与缓解:量化损失不是均匀的,少数离群值大的通道承担了较多信息,粗暴四舍五入伤到它们质量就掉。AWQ 的思路正是识别并高精度保护这些关键通道——现代 int4"效果还不错"的背后是这类精细设计。
💡 带宽红利:第 7.1 节说过解码是带宽瓶颈——量化把权重体积减半,等于每次搬运的数据减半,所以量化的收益不只是"装得下",还有实打实的速度提升(带宽受限场景近乎线性)。4 bit 模型又小又快的原因就在这。
二、剪枝:删掉不重要的连接
神经网络的参数有大量冗余——不少权重接近零、删掉对输出影响甚微。剪枝按粒度分两类:
- 非结构化剪枝:逐个删权重。理论上可以删掉大比例参数,但删出来的稀疏矩阵在通用 GPU 上跑不快(硬件按稠密矩阵优化),省显存但不省时间,价值有限。
- 结构化剪枝:整头、整层、整块地删(删掉后仍是规整的稠密模型,硬件友好)。但结构化删除对质量的影响更大,删多少需要精心的再训练恢复。
在大模型实践里,剪枝的存在感远不如量化与蒸馏:收益不如量化直接(量化几乎白拿一半),工程复杂度又高(需要再训练、逐层敏感度分析)。它的思想以另一种形式活着——注意力头剪除的敏感度分析、层删除(深度剪枝)研究,以及 MoE 架构"天然不用全部参数"的稀疏化思路。结论层面记住一句话:除非有极端的模型体积约束,轮不到剪枝出场。
三、蒸馏:大模型教出小模型
量化与剪枝改造"一个模型",蒸馏则是用大模型(教师)的能力训练出一个全新的小模型(学生)。
数据流:拿一批任务输入(可以是无标注的),教师模型产出输出(含每个 token 的概率分布,即"软标签"),学生模型在这些数据上训练、逼近教师。软标签比硬标签信息更丰富——教师认为"正确答案 0.7、次优答案 0.2",这个相对判断传递了教师的偏好结构,学生学得比只看标准答案更快。
蒸馏在大模型生态里的三种典型用法:
- 小模型产品化:用旗舰模型蒸馏出 1–7B 的专用小模型(客服、分类、路由),推理成本降一到两个数量级。当代"小模型能力远超其规模"的现象,很大程度是蒸馏的功劳——小模型站在大模型的输出分布上学习,比从零训高效得多。
- 推理增强的迁移:让教师先生成长推理链,学生学"怎么思考",小模型也能获得可观的推理能力。
- 数据合成(6.1 节提过的蒸馏扩数据):教师批量生成指令-回答对,供学生 SFT 使用——广义的蒸馏思想。
代价要说清:蒸馏需要一次训练投入(数据生成 + 学生训练),学生的上限受教师约束(通常还要再打折扣),且教师的错误会被学生继承。适合"高频调用、任务固定、成本敏感"的场景;低频场景直接调教师 API 更省事。
四、三件套怎么选
选择顺序几乎可以流程化:
- 先量化:改动最小(换个格式)、收益立竿见影(体积与速度)、质量损失小。90% 的降本需求到这步就解决了。
- 量化不够再蒸馏:需要更小更快的专用模型、且调用量大到值得付一次训练成本时上蒸馏。
- 剪枝殿后:仅在极端约束且有专门工程能力时考虑。
- 可叠加:蒸馏出的学生模型再量化,是边缘部署的常见组合(小模型 + int4 = 手机可跑)。
⚠️ 量化验收的正确姿势:不要只看模型能跑,要在你自己的任务测试集上对比量化前后的指标(第 6.3 节的评估闭环直接复用)。不同任务对量化的敏感度差异很大——常规对话几乎无感,精细的数学计算与长程推理可能明显退化。另外注意量化版本与原模型的输出分布差异,批量切换前做回归。
常见问题
问题:量化会影响微调吗?
顺序有讲究。常规做法是"fp16 微调 → 量化部署"(QLoRA 是反过来的特例:先量化基座再训 LoRA,训练时反量化计算)。推理期用的量化模型一般不再直接微调,需要改动时回到高精度权重重新走流程。
问题:为什么 int4 的损失能做到很小?
一方面模型确有冗余,另一方面 AWQ/GPTQ 类方法做了精细保护(关键通道高精度、逐组缩放)。但"很小"不等于零——边缘任务(数值、严格格式)务必实测。
问题:蒸馏和直接微调小模型有什么区别?
数据来源不同:微调用人工或现成数据,蒸馏用教师的输出。教师输出分布更平滑、覆盖更广,通常带出更强的小模型;代价是依赖教师的质量与许可(用别人的模型 API 蒸馏,注意服务条款)。
五、一次完整的降本改造实录
把本章工具串成一个典型项目。某团队的自部署推理服务月度账单过高,GPU 显存常年吃紧,按以下顺序完成改造:
第一步,量化。fp16 换 int4(AWQ 方案),单卡显存占用从约十四 GB 降到三点五 GB,同卡可加载的副本翻两番;解码是带宽瓶颈(第 7.1 节),权重变小后生成速度还提升了三成。质量验收:在自家两百条评测集上对比,任务指标下降在百分之一以内,可接受。
第二步,合并批处理优化。换用支持连续批处理与分页注意力的推理框架(量化模型原样兼容),高峰期吞吐再翻倍,排队延迟显著下降。
第三步,分级路由。分析日志发现七成请求是简单问题(查订单、问政策),用蒸馏出的一点五亿参数小模型(教师是大模型,第 6.1 节的蒸馏扩数据思路)承接简单类,识别不准时升级到大模型。小模型成本是大模型的百分之一量级,整体账单再降一半。
三步合计:总成本降到原来的四分之一左右,P99 延迟反而改善,质量指标基本持平。改造顺序值得注意——先量化(白拿一半)、再优化服务(工程收益)、最后蒸馏(训练换成本),与正文的推荐顺序一致:越往后投入越大、收益越依赖场景,顺序错了就会在回报最低的环节耗尽预算。
补充:量化验收的指标设计
量化验收最容易被做错成"跑几条样例看看差不多"。规范做法:在评测集上同时报告任务指标与格式合法率(量化对小数、代码缩进、JSON 边界的损伤先暴露在这两处);对比生成分布的差异(同一问题量化前后的输出相似度,骤变提示风格损伤);重点回归数值敏感任务(计算、日期、金额)。这套指标一小时内可以搭完,是量化从"敢用"到"放心用"的必要一步。
常见追问:量化对推理延迟到底提升多少?
分阶段看:预填充阶段是算力瓶颈,量化提速有限;解码阶段是带宽瓶颈,权重减半则搬运减半,提速接近线性(int4 相比 fp16 常见两到三倍)。但批处理大、GPU 算力已经打满的负载里,带宽不再是瓶颈,量化提速缩水。所以准确的说法是"量化在解码为主的负载里提速明显"——用自己的流量画像实测,仍是唯一可靠的答案。
再追问:压缩后还能再微调吗?
能,但顺序有讲究。常规链路是"高精度微调、再量化部署";若想在量化模型上继续训练,QLoRA 一类方案提供了路径(训练时对冻结权重做反量化计算,梯度只进适配器)。需要注意量化模型上训练的数值敏感性问题——学习率要更保守、精度验证要更频繁。给一个稳妥建议:把"微调"与"压缩"视为流水线的两个独立阶段,各自验收,不要图省事混在一个阶段里做。
最后一问:未来硬件会不会让压缩失去意义?
硬件进步(更大显存、原生低精度支持)会持续降低压缩的必要性,但"计算需求永远跑在硬件供给前面"的历史规律至今未破——上下文变长、推理增强、用户量增长,每一个都在制造新的紧张。可以预期的是压缩形态的迁移(从 int4 权重到更激进的方案),不能预期的是压缩需求消失。把它当成长期技能投资,是安全的判断。
本节要点回顾
- 量化降数字精度:int8 几乎无感省一半,int4 让 7B 模型进笔记本;PTQ 几分钟搞定、QAT 保质量;GGUF 对应本地、AWQ/GPTQ 对应 GPU。
- 带宽瓶颈下量化既省显存又提速——不只是"装得下"。
- 剪枝在大模型中收益不如量化直接(非结构化跑不快、结构化伤质量),仅极端约束下使用。
- 蒸馏大教小:软标签传递教师的偏好结构,专用于"高频、固定、成本敏感"场景的小模型生产;教师的错误会被继承。
- 选择顺序:量化 → 蒸馏 → 剪枝,可叠加;量化后要在自己的任务上回归验收。
模型压好了,最后一节把它交付出去:云端还是边缘、怎么封装成服务、上线后盯什么。