7.3 部署方案:云端、边缘与服务化
7.3 部署方案:云端、边缘与服务化
本节摘要:模型优化好了,要变成用户可用的服务才算交付。本节比较云端与边缘两种部署形态的取舍,讲服务化的标准形态(OpenAI 兼容 API、流式返回、多适配器服务),以及规模化时的分布式推理与负载路由,最后给出上线后的监控体系(P99 延迟、吞吐、质量、成本)与扩缩容策略。
学完你能
阅读完本节,你应当能够:
- 按六个维度(延迟、隐私、成本、算力、更新、离线)选择部署形态
- 描述一个标准推理服务的请求处理链路
- 解释流式返回为何重要、多适配器服务怎么工作
- 设计多副本的负载路由与扩缩容策略
- 搭建四类监控并设置合理的告警
一、云端还是边缘:六维护量
部署的第一道选择题。两种形态的对比按六个维度展开:
| 维度 | 云端部署(GPU 服务器 + API) | 边缘部署(手机/PC/本地服务器) |
|---|---|---|
| 首字延迟 | 网络往返加数十到数百毫秒 | 本地无网络开销 |
| 数据隐私 | 数据出域(除非私有云) | 数据不出设备 |
| 成本结构 | 按用量/按卡时,量大可控 | 硬件一次性 + 边际近零 |
| 模型规模 | 可跑最大模型 | 受限于内存(量化小模型为主) |
| 更新迭代 | 分钟级全局更新 | 需推送到端,周期长 |
| 离线能力 | 无网不可用 | 完全离线可用 |
决策经验法则:默认云端(运维简单、模型可大、迭代快);以下三种情况认真考虑边缘——隐私合规要求数据不出域(医疗、金融内部场景)、弱网或离线环境(车载、工厂、飞行模式应用)、调用频次极高且任务简单(输入法联想类,边缘小模型比云端便宜百倍)。第三种是最常被忽略的:一个 int4 的 1B 模型在端上做简单任务,成本结构碾压云端旗舰模型。
现实系统常是混合的:端侧小模型做初筛与简单任务,复杂请求升级到云端大模型——与第 1.2 节"大模型 + 传统模型混合"、第 4.3 节"API + 私有混合"一脉相承的分层思想。
二、服务化:把模型封装成服务
裸模型不能上线,服务化层负责把"一次生成"包装成可靠的接口。当代事实标准是 OpenAI 兼容的聊天补全 API 格式——请求带消息列表与采样参数,返回生成内容。坚持兼容标准格式的实际好处:上层应用(各类编排框架、SDK)即插即用,换后端模型不改业务代码。
推理服务架构总览
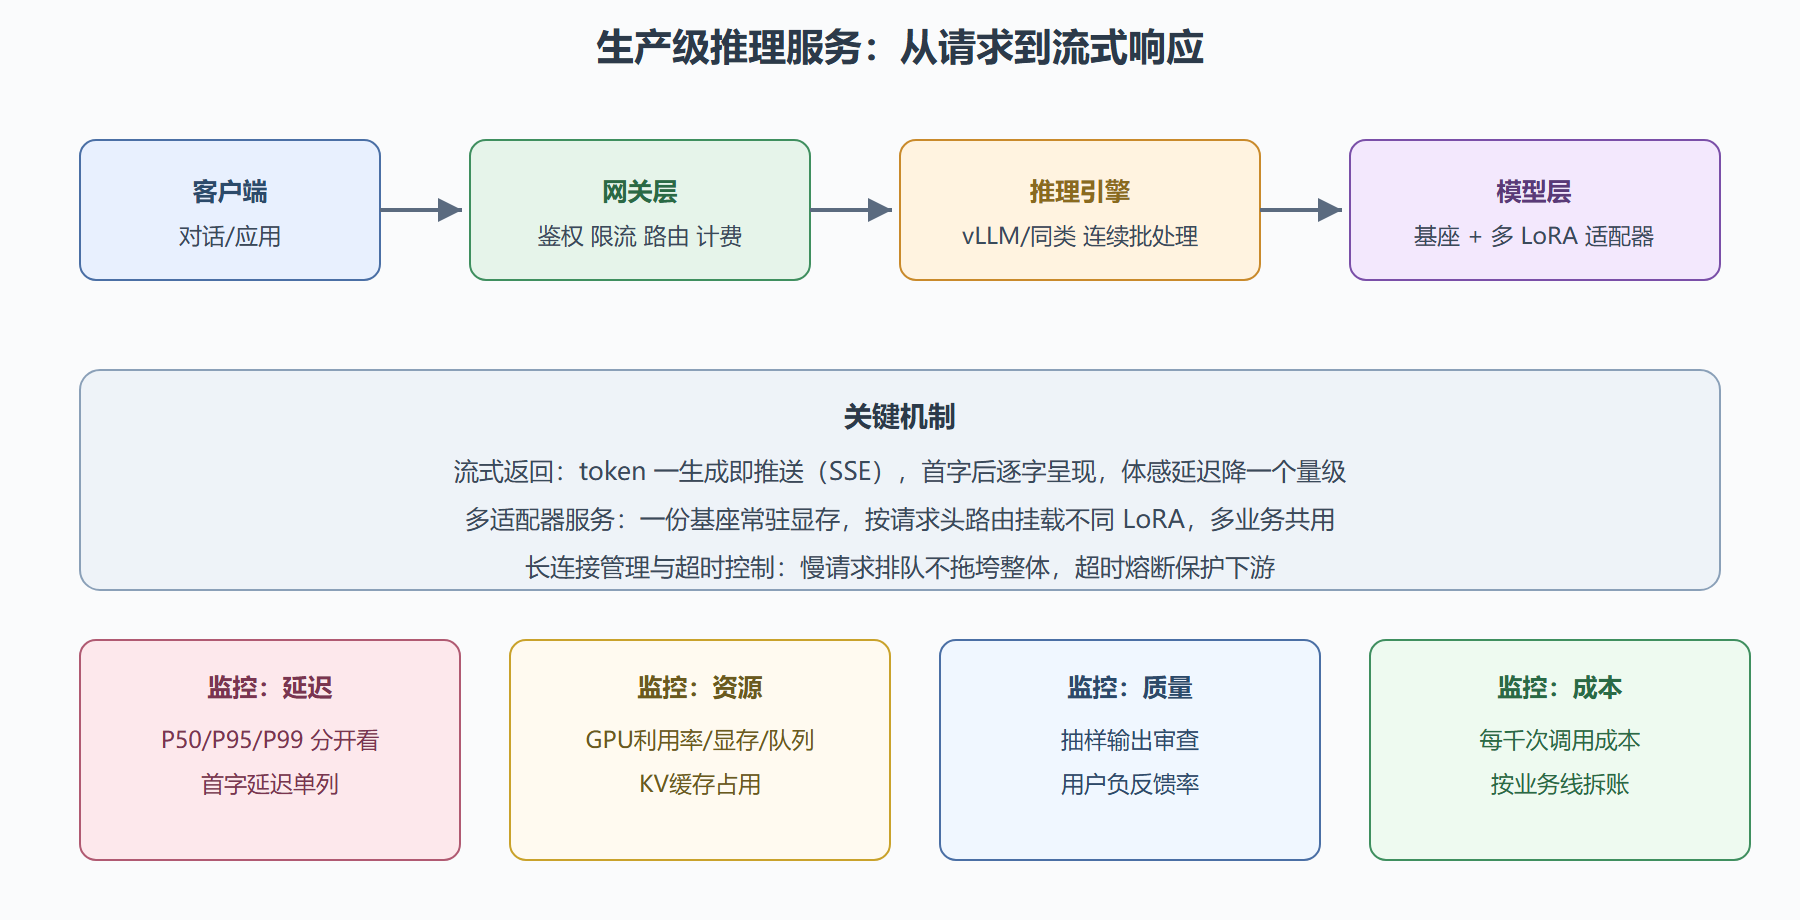
三个机制值得展开:
流式返回是体验的生命线。非流式下用户盯着空白等十几秒;流式(服务端逐 token 推送)把体感延迟从"总时长"变成"首字延迟 + 匀速出字",等待焦虑消失。推理框架普遍支持,业务端用标准的事件流接口接收即可。
多适配器服务是第 6.3 节 LoRA 红利的兑现处:一份基座权重常驻显存(占大头),各业务的 LoRA(几十 MB)按需热加载,请求路由到对应适配器。十个业务共享一份基座显存,硬件利用率成倍提升。
工具生态按场景分三档:vLLM/SGLang/TensorRT-LLM(GPU 服务器主力,高吞吐)、Ollama/llama.cpp(个人与端侧,易用优先)、云厂商托管服务(免运维、按量计费)。同一 OpenAI 格式下互换成本很低。
三、规模化:分布式推理与路由
单卡装不下大模型或单实例扛不住流量时,两条扩展路径:
模型切分:与训练时的并行同族——张量并行(大矩阵切开多卡算,注意通信开销只适合机内)、管道并行(层分段跨机)。张量并行度通常固定为单机卡数,跨机扩展靠管道与副本。
多副本与路由:多个完整实例并行,前置负载均衡按显存压力(KV 缓存占用)而非简单轮询分发——两个实例一个闲一个满是最常见的浪费。会话亲和(同一会话粘同实例可复用前缀缓存)与优先级队列(付费用户优先)是进阶手段。
扩缩容:GPU 服务冷启动慢(加载权重数分钟),激进自动缩容会伤体验;常用策略是"缩容保守 + 预热缓冲 + 按业务峰谷定时扩容"。长连接(流式)让滚动更新变复杂——优雅下线要等流式响应吐完。
四、监控:四类指标一套告警
上线只是开始,监控体系四类指标(上图底部)各有要点:
- 延迟看分位数:平均延迟会骗人——大模型延迟方差极大(受批处理排队、输入长度、生成长度影响),P99 才代表最差用户的体验。首字延迟与生成速度(token/秒)分开统计。
- 资源看 KV 缓存水位:GPU 利用率之外,KV 缓存占用率是更领先的容量信号——打满意味着排队开始、延迟即将劣化。
- 质量要主动抽样:自动监控发现不了输出质量漂移(模型没变,但上游数据变了也会影响效果)。定期抽样人工审查 + 用户负反馈按钮 + 第 8 章的自动评测集回归,三件套组成质量防线。
- 成本按业务拆账:每千次调用成本按业务线/模型档位拆分,异常上涨(prompt 变长、路由失衡)能当天发现。
告警设计的务实原则:告 P99 超阈值与错误率,不告平均值;容量类指标(队列长度、缓存水位)设提前量告警;每条告警必须对应一个明确的处置动作,否则删掉。
⚠️ 上线前必查清单:并发压测做过吗(不是单请求测)?超长输入的超时与截断策略定了吗?流式连接断开重连处理了吗?模型输出被下游当 JSON 解析时有格式校验兜底吗?配额与限流能防住一个用户打爆全站吗?——五问都过,才算真上线。
常见问题
问题:自部署和调 API 怎么选?
沿用第 4.3 节框架:流量小、验证期,用 API(免运维);流量大且稳定(每天千万级调用)、或有隐私合规要求,自部署(vLLM + 开源模型)的边际成本优势显现。中间态(白天高峰自部署、溢出走 API)也是常见架构。
问题:一台机器能服务多少用户?
取决于模型大小、量化档位、输入输出长度分布与 SLA。经验数量级:单张 80GB 级卡跑量化 7B 模型,中等长度对话可支撑每秒几十个并发请求。准确的数要用自己的流量画像压测,别人的数字没有参考价值。
问题:模型更新怎么灰度?
推理服务的灰度发布与常规服务类似但多一层:输出不确定性。做法是新版本先在影子流量上跑(镜像请求、不影响用户),对比新旧输出质量(第 8 章的评测集),达标后按百分比切流。直接全量切换大模型版本是重大事故的常见来源。
五、故障演练:三个真实场景的处置剧本
监控体系的成色要在故障里检验。三个高发场景的处置剧本,供参考:
剧本一:高峰期 P99 飙升。 症状:延迟告警,平均延迟正常。诊断顺序:查队列长度(排队导致,扩容或降批延迟)——查 KV 缓存水位(长上下文请求挤占,需限制单请求上下文或扩容)——查是否有异常超长请求(某用户粘贴整本书,加输入长度限制)。根因九成在这三处。
剧本二:输出质量突变。 症状:负反馈率上升,无任何部署变更。排查:上游数据是否变化(提示词模板被业务侧改动)——模型接口是否静默更新(供应商升级了底层版本)——检索库是否混入坏文档(RAG 场景)。启示:模型服务的质量监控必须覆盖"你不可控的上游",第 8.3 节的评测集回归在这里登场。
剧本三:某类请求全部失败。 症状:错误率告警集中在特定模式。常见根因:输出被下游当 JSON 解析而模型偶尔加了格式外文字(加结构化输出约束与解析容错)——某条路由规则把超长请求发给了小上下文实例——适配器挂载冲突(多业务共用基座时路由错配)。
三个剧本的共同主题:推理服务的故障,多数不是模型坏了,而是系统其他部分变了。因此监控要盯着整条链路,而不只是模型本身——这也是把第 7 章称为"系统工程"而非"模型工程"的原因。
补充:容量规划的经验公式
容量规划不必精确建模,用经验公式起步:先测单实例在目标延迟约束下的稳态吞吐(压测得出),再除以业务峰值每秒请求数,得所需实例数,最后乘以一点五的安全系数应对波动与故障切换。真正要小心的两个非线性因素:长上下文请求对 KV 缓存的挤占(实例数要按显存再验一遍)、流式连接对滚动更新的拖拽(更新窗口要预留)。公式加两个修正,容量规划就从玄学变成了算术。
常见追问:模型服务的灰度发布与普通服务有什么不同?
多了一层"输出不确定性":普通服务新版行为可以枚举验证,模型新版连同样的输入都可能给出不同输出。因此模型灰度的重点是"分布级对比"而非"用例级对比"——用固定评测集跑新旧版本的指标对比(第 8 章),同时监控线上负反馈率的迁移,两者都平稳才逐步放量。跳过评测集直接切流,是模型服务事故榜上排名第一的原因。
再追问:多模型共存的显存怎么规划?
按"常驻与按需"两档规划:高频主力模型常驻显存(含其 KV 缓存余量,按并发峰值估);低频模型按需加载(秒到分钟级冷启动成本,用预热与空闲回收控制)。规划的核心公式是"常驻权重大小加预计缓存峰值不超过总显存的八成"——留两成余量应对突发与碎片。多数显存事故的根因,都是把余量算到了一百 percent。
最后一问:部署自动化做到什么程度合适?
初期手动即可(脚本化部署、人工发版),但两条线值得尽早自动化:评测回归(发版闸门,第 8 章)与基础扩缩容(流量峰谷的自动应对)。更高级的全自动金丝雀发布,等团队规模与流量 justified 之后再上。自动化的正确顺序是"先自动化防事故的部分,再自动化省人力的部分"——反过来做,省下的人力会加倍还给事故处理。
本节要点回顾
- 形态选择六维护量:延迟、隐私、成本、规模、更新、离线;默认云端,隐私/离线/超高频简单任务走边缘,常见分层混合。
- 服务化三机制:OpenAI 兼容 API、流式返回(体验生命线)、多 LoRA 适配器共享基座;工具三档:服务器框架 / 端侧框架 / 托管服务。
- 规模化:张量并行限机内,跨机靠管道与副本;路由按 KV 缓存水位,GPU 服务扩容易缩容难。
- 监控四类:延迟看 P99 与首字、容量看缓存水位、质量靠抽样+回归、成本按业务拆账。
- 上线五问:压测、超时、断连、格式兜底、限流——全过才算上线。
交付链路走完,第 8 章补上质量闭环:怎么科学地知道一个模型(或一次更新)到底好不好。