8.2 生成与理解指标、基准数据集
8.2 生成与理解指标、基准数据集
本节摘要:本节配备评估弹药库:生成类指标(BLEU/ROUGE)的字面重合原理与语义盲区、理解类指标(Accuracy/F1)的适用前提、主流基准数据集的能力地图(MMLU/GSM8K/HumanEval/TruthfulQA/竞技场),以及两个致命陷阱——数据污染与基准过拟合——的识别方法。
学习目标
阅读完本节,你应当能够:
- 手算一个迷你 BLEU 的思路,说明它为何测不到语义
- 区分 Precision 与 Recall 的取向差异
- 把主流基准按能力面归类,并为给定需求选基准组合
- 识别数据污染与刷榜的可疑信号
- 设计防污染的评测实践
生成类指标:字面重合的得与失
生成任务(翻译、摘要)传统上用"模型输出与参考答案的字面相似度"打分,两大代表:
BLEU(翻译场景):数模型输出与参考答案的 n-gram(连续词组)重合比例,核心取向是精确率——模型说的有多少在参考里。重合越高分越高,并对过短的输出施加惩罚(防止靠只输出几个高置信词刷分)。
ROUGE(摘要场景):方向反过来,核心是召回率——参考答案里的内容有多少被模型覆盖了。摘要漏掉关键信息是最大罪过,所以取向与翻译相反。
用一个迷你例子感受机制:
参考摘要:会议 决定 推迟 发布 计划 至 下月 模型A: 会议 决定 推迟 发布 至 下月 (漏"计划"但意思在,ROUGE 扣分) 模型B: 发布 计划 推迟 会议 决定 (词几乎全在但语序错乱,BLEU 重合高却不可读)
这类指标的先天盲区在第三种情况:
参考:这部电影剧情拖沓 模型:影片节奏缓慢拖泥带水 (语义等价,字面几乎无重合 → 指标给低分)
字面重合测不到语义等价。对只有一个参考答案的传统任务,这个缺陷勉强可忍(大家都错得差不多,排序还算有效);对大模型是致命的——大模型完全可能生成比参考答案更好、但用词全然不同的输出,机械比对反而判它不及格。所以当代评估里 BLEU/ROUGE 的地位大幅下降,主要留在两类场景:模型间横向粗比(分布层面的信号仍有效)、以及作为回归测试的"突变探测器"(分数骤变提示输出风格出了问题)。
二、理解类指标:有标准答案时的成熟工具
理解类任务(分类、选择、抽取、数学题)有标准答案,传统指标直接可用:
- Accuracy(准确率):答对的比例。类别均衡时够用。
- Precision / Recall / F1:类别不均衡时的必需品。例如从一万条工单里抽 50 条紧急工单:模型报了 100 条其中 40 条真紧急(精确率 40%),50 条真紧急里抓到 40 条(召回 80%)——单看哪个都会误导,F1 取两者的调和平均。
- Pass@k(代码场景):每题采样 k 次至少一次通过测试的比例——承认生成有随机性,用多次采样刻画"能力分布"而非单点,这个思路正从代码评估扩散到其他领域。
选择题形式(MMLU 类)的评测还有个技术细节:判分方式(比对生成的字母、还是比对各选项的似然)会影响几个点的分数——对比不同模型的报告时,先确认判分口径一致,否则在比两把不同的尺子。
三、主流基准地图
按能力面归类主流基准:
主流基准能力地图
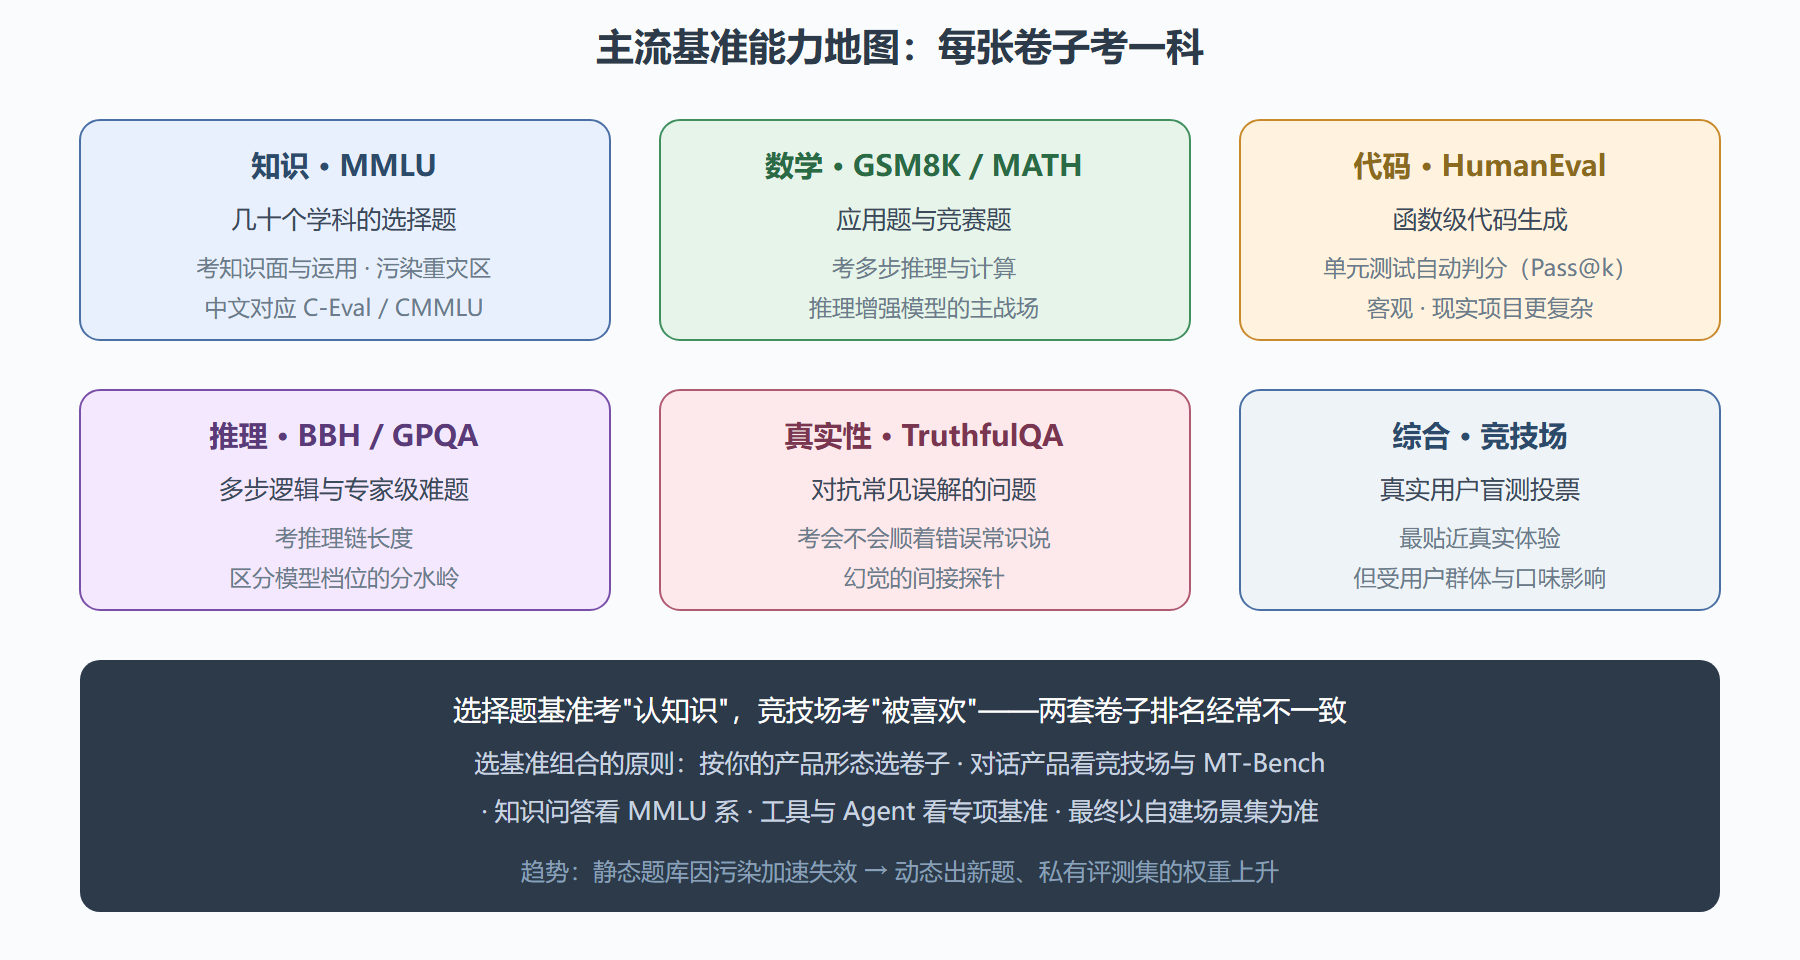
看地图要带着一个清醒认识:每张卷子只考一科。MMLU 高不代表会聊天,竞技场人气高不代表数学强。选基准组合应从产品形态倒推——这也再次印证 8.1 节"评估组合是产品设计一部分"的原则。
四、两大陷阱:数据污染与基准过拟合
数据污染:基准题目在训练前就泄露进了预训练语料(网页上到处是 MMLU 的题和讨论),模型"背过答案"而非会做。这是当前评估面临的最大系统性威胁,可疑信号包括:某模型在旧基准上异常高分但在同能力的新出题目上平庸;简单题与难题分差反常(背答案的模型在改了数字的"同款题"上骤降);输出中出现基准题目的逐字原文式复现。
防御手段是评估侧的持续军备竞赛:动态基准(定期换题)、私有评测集(不公开、无法被爬)、题目变换检验(改数字改人名重测,看分数掉不掉)。后两者普通团队完全做得到——自己的评测集不公开,这一条纪律就挡掉了大部分污染。
基准过拟合(刷榜):针对性优化某个基准(在同类数据上加训、按基准题型特调),分数涨了通用能力没涨。识别方法:看多基准联动的趋势而非单点;看该模型发布时"恰好"在自家强项基准上大书特书;最可靠的还是拿它在你自己的场景集上跑一遍。
⚠️ 消费榜单新闻的正确姿势:模型 X 在基准 Y 上提升 Z 个点——先问四个问题:Y 与我的场景相关吗?X 的训练数据是否可能见过 Y?判分口径与对比对象一致吗?同期能力面的其他基准动了吗?四问过后还站得住的提升,才值得纳入选型考虑。
常见问题
问题:中文场景该看哪些基准?
C-Eval、CMMLU(中文知识)、CMATH(中文数学)等中文基准,以及国际基准的中文表现。注意中文基准同样存在污染与题目质量参差的问题,方法论不变:榜单初筛 + 自建中文场景集决断。
问题:竞技场排名能信多少分?
它是目前最贴近真实体验的信号(真实用户、真实问题、盲测),但有偏:用户群体偏技术、投票偏好长而漂亮的回答、参与度高的模型样本更多。当作"人缘榜"参考,与能力基准交叉看。
问题:单元测试(Pass@k)是完美的代码评估吗?
比字面指标好得多,但也有缝隙:测试覆盖不足时错误代码也能通过;函数级题目远比真实工程(跨文件、需求模糊)简单。生产级代码评估要加真实仓库级任务与人工审查。
五、读论文与榜单的检查清单
本节的陷阱知识压成一份随身清单,读模型发布文案或榜单新闻时逐条过:
第一查口径:分数是零样本还是少样本?判分方式是生成比对还是似然比对?提示词格式是否对模型有利?口径不同,一分之差毫无意义。
第二查对象:对比的基线是同代旗舰还是上代旧款?是否有"专挑弱项比"的倾向?显著优势是否只集中在一两个基准?
第三查污染:基准创建时间与模型训练截止时间的关系;模型在"换个数字的同款题"上是否保持水平;发布方是否说明做过污染检测。
第四查相关性:高分的基准与我的场景有多远?数学竞赛题分数对客服系统几乎没有预测力;对话竞技场的人气对知识问答的参考也有限。
第五查独立性:数据是发布方自评还是第三方复现?自评的配置往往处在对自己最有利的位置;第三方与社区复现的分数更可信。
五查之后仍然成立的提升,才值得进入你的选型候选。这份清单与第 4.3 节"消费榜单新闻四问"同源,这里更细一层——带着它读一个月的模型新闻,你对行业宣传的免疫力会显著提高。
补充:中文评测的特别注意事项
中文场景的评估有几个英文教程不会覆盖的坑:分词口径影响 n-gram 指标(按字还是按词算 BLEU,结果差异巨大,对比时必须统一);中文基准的题源常翻译自英文题库,翻译质量本身引入噪声;繁简混排与全半角规范化没做好,自动判分会大量误判为错误。规范做法:中文评测集统一做繁简与全半角预处理、判分口径写进评测文档、对翻译来源的题目保持一分警惕。这些细节决定了中文评测结果的可信度。
常见追问:有没有"万能基准"可以只看一个?
没有,而且这个愿望本身有风险。任何单一基准都是能力面的一个切片,"只看一个"必然诱导优化方向失衡(刷榜)。业界趋势恰恰相反:基准组合越来越丰富、私有问题集占比越来越高。如果一定要精简,保留"一两个与业务同构的公开基准加一个自建评测集"的三件套——公开基准提供横向坐标,自建集提供决策依据,缺一不可。
再追问:怎么看待"模型排行榜"类产品?
它们是有用的横向参照,但要读出三层信息:分数本身(能力面参考)、投票者画像(结果偏向谁的偏好)、题目分布(覆盖你的场景多少)。竞技场类产品对"日常对话体验"预测力较好,对专业知识场景预测力弱。聪明的用法:用榜单圈出候选,再用自己的评测集做最终裁决——两步都不能省,只做第一步是偷懒,只做第二步是闭门造车。
最后一问:如何建立自己的"基准观"?
三句话:知道每张主流卷子考什么科(8.2 的地图);知道卷子可能被污染(五查清单);知道自己的场景最终要自建卷子(评测集)。在此之上,保持每月一次的基准新闻浏览,把新基准放进地图即可。基准观的成熟标志是:看到任何"XX 模型登顶"的标题,你的第一反应是"先查口径与相关性"——这个条件反射,就是专业评估素养的体征。
补记:指标符号速查
正文提到的指标符号对齐:BLEU 与 ROUGE 后面的数字(如 ROUGE-1、ROUGE-L)指按几元词组或最长公共子序列计算;Pass@k 的 k 指采样次数;困惑度(PPL)是交叉熵的指数形式,数值越低模型对文本的预测越准。这些符号在论文与产品文档里高频出现,认得出、读得懂,是从"听说过"到"用得上"的一小步,却是最常被卡住的一步。
最后留一道阅读题:找一篇最近的模型发布技术报告,只看评估部分,用五查清单逐条审视它呈现的证据——口径是否清晰、对比对象是否同代、是否说明污染处理、结论是否超出证据范围。做完你会发现:能通过全部五查的报告少之又少,而你此刻拥有的鉴别力,正是这份练习的回报。带着这双眼睛去读下一个月的技术新闻吧。
本节要点回顾
- BLEU 重精确(翻译)、ROUGE 重召回(摘要)——只测字面重合,语义等价会被误判,当代退居粗比与突变探测。
- 理解类指标照旧可用(Accuracy/F1/Pass@k);对比报告先确认判分口径一致。
- 基准地图:MMLU 知识、GSM8K 数学、HumanEval 代码、BBH 推理、TruthfulQA 真实性、竞技场综合——每张卷子只考一科,按产品形态选组合。
- 数据污染是最大系统性威胁:信号是"旧题强新题弱";防御靠动态出题与不公开的自建评测集。
- 刷榜识别看多基准联动;榜单新闻过四问再采信。
弹药备齐,下一节讲怎么把它们组织成体系:评测框架、人工评估设计与错误分析方法。