8.1 大模型评估指标体系
8.1 大模型评估指标体系
本节摘要:评估大模型比评估传统模型难得多——它是通用的、输出是开放的、"好"的标准是主观的。本节讲清这三重难点,建立六维质量指标体系(准确性、流畅性、有用性、安全性、忠实性、效率),比较自动评估、人工评估与 LLM-as-Judge 三种手段的分工与偏差,并解释为什么任何单一分数都必然失真。
学完你能
阅读完本节,你应当能够:
- 说明大模型评估的三重难点及其对方法论的约束
- 列出六维指标并各举一例
- 解释准确性与忠实性的区别
- 分析 LLM-as-Judge 的三类偏差
- 为一个具体产品设计评估维度组合
一、评估为什么难:三重困境
传统机器学习的评估是成熟的:一个任务、一个带标准答案的测试集、一个指标(准确率、F1、AUC),分数即结论。这套方法在大模型上集体失灵,原因有三层:
困境一:通用性。 大模型同时会翻译、写代码、答问题、聊天——评什么?评数学好不代表对话好,评对话好不代表代码好。任何评估都只是抽样,而"模型全貌"这个总体不可见。
困境二:开放性。 传统任务有标准答案,输出可与答案精确比对。大模型的生成任务(写摘要、方案、代码)往往有无数个可接受的输出——参考答案只是一个样本,"与参考不同"不等于"错"。字面比对指标在这里先天残废(8.2 节展开)。
困境三:主观性。 "这个回答好不好"包含有用性、语气、详略、分寸的判断,这些维度没有客观真值,不同评估者结论不同(第 6.2 节偏好标注遇到的是同一个问题)。
三重困境决定了大模型评估的方法论形态:没有单一分数,只有多维组合;没有纯自动,必须人机结合;没有通用结论,只有场景化结论。
二、六维质量指标
把"模型好不好"拆成可操作的维度:
大模型质量六维指标
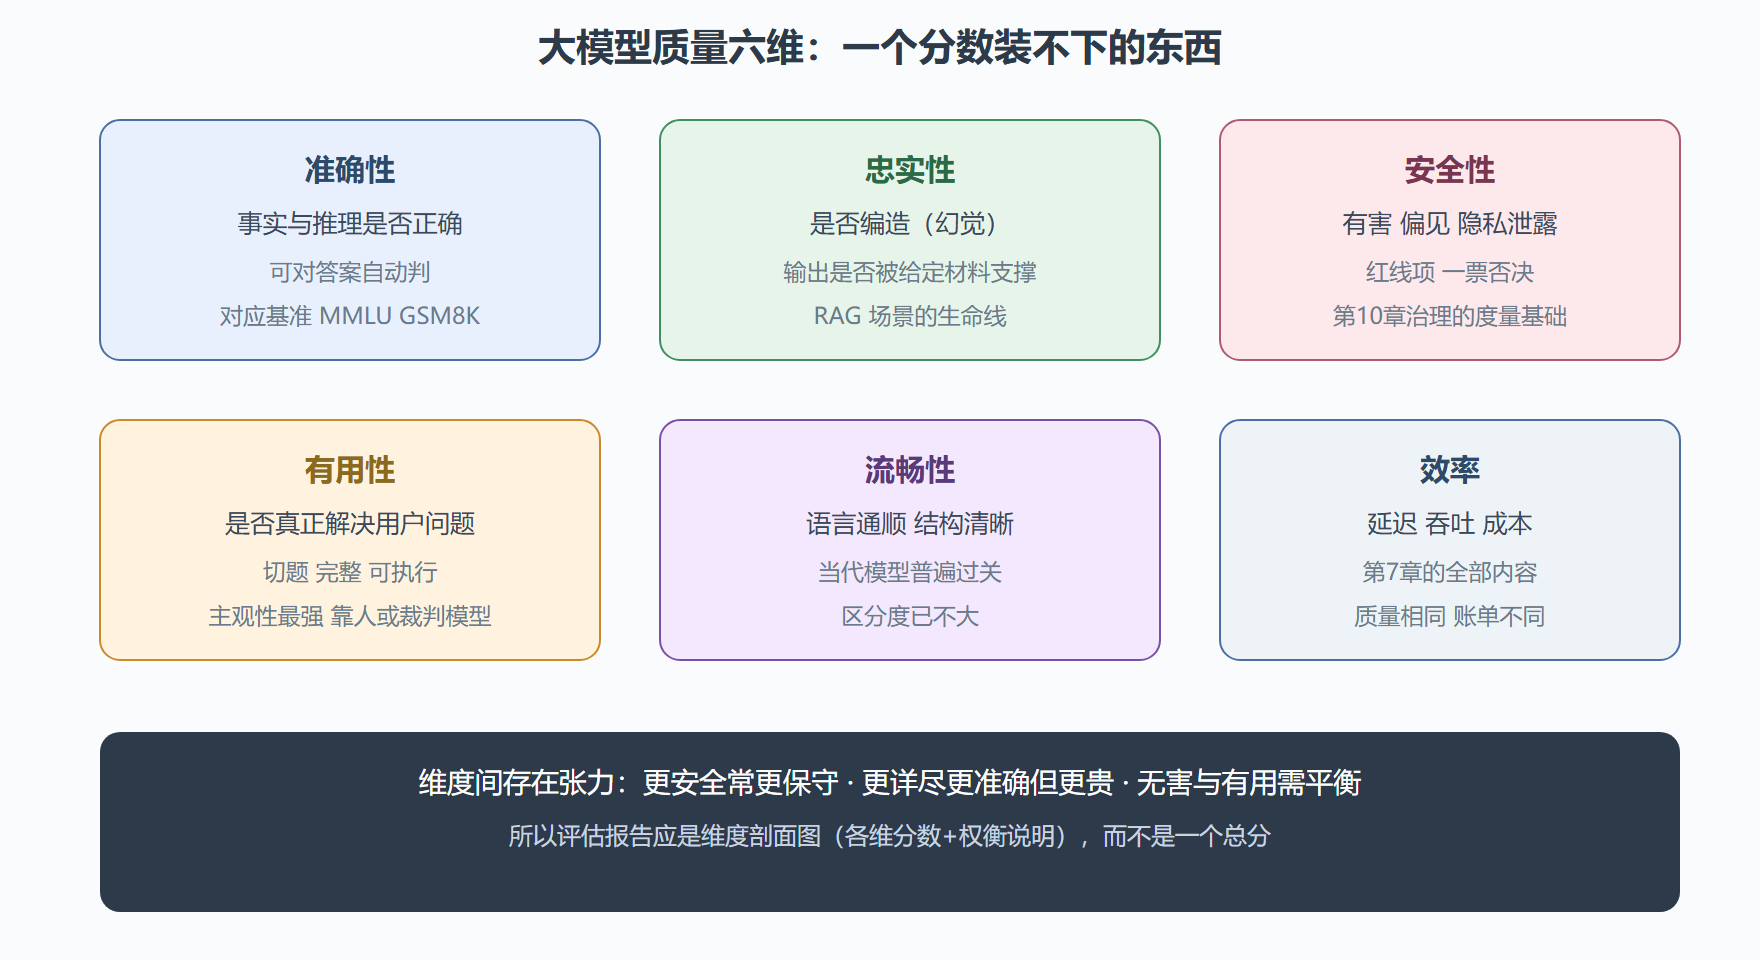
两个最易混淆的维度要区分开:准确性问"说的对不对"(对照世界事实),忠实性问"是不是编的"(对照给定材料)。一个 RAG 系统可以输出流畅又"自信"的答案,但引用关系是编的——准确性未必能立刻验证,忠实性却能对着检索材料判。企业落地场景中忠实性往往是第一硬指标:宁可答"资料中没有",不可张冠李戴。
效率入列也别意外:第 7 章说过同样质量的模型,成本可以差一个数量级——商业场景里"质量/成本比"才是真指标。
三、三种评估手段的分工
自动评估(指标与基准):快、便宜、可复现,适合回归测试与大规模筛选;但覆盖有限,测不了主观维度。它是"体检指标",不是"诊断结论"。
人工评估:人判输出质量,最贴近真实体验,但慢、贵、主观漂移。方法上讲究设计:排序优于打分(与 RLHF 标注同理,相对判断一致性好)、盲测避免品牌偏见(不告知是哪个模型)、多评估者交叉并统计一致性。
LLM-as-Judge(用强模型当裁判):让一个强模型按评分标准给被评模型的输出打分或比较。成本接近自动、覆盖接近人工,是当代性价比最高的手段,但有必须知道的三类偏差:
- 位置偏差:比较两段回答时偏向先出现的那个——对策是交换顺序评两次。
- 长度偏差:偏好更长的回答,不管是否真的更好——对策是评分标准里明确"长度不计分"并给样例。
- 自我偏好:裁判模型偏爱与自己风格相似的输出——对策是换不同家族的裁判交叉验证,关键结论人工复核。
成熟的评估管线通常三层并用:自动指标做全量回归筛异常 → LLM 裁判做批量质量评分 → 人工只复核裁判标出的边界样本与关键场景。人力的位置放在刀刃上。
四、为产品设计评估组合
把本章方法落到一个假设的产品——企业知识库问答(RAG):评估组合应该长这样:
| 维度 | 手段 | 频率 |
|---|---|---|
| 忠实性 | LLM 裁判对照检索材料判引用关系 | 每次发版全量 |
| 准确性 | 自建 100–200 条真实问题评测集,答案可核 | 每次发版 |
| 安全性 | 红线题库(诱导、越权、隐私套取) | 每次发版一票否决 |
| 有用性 | 用户负反馈率 + 抽样人工评审 | 线上持续 |
| 效率 | 首字延迟、每次问答成本 | 线上监控(第 7.3 节) |
注意这个组合的个性:RAG 把忠实性顶到第一位;对话产品会更重有用性与流畅性;代码产品核心是单元测试通过率。评估维度组合是产品设计的一部分,照抄别家的评测集,等于用别人的体检标准查自己的病。
⚠️ 最普遍的错误:被榜单分数带偏决策。榜单测的是模型在公开题库上的表现,与你的场景隔着两层折损(数据分布不同、污染程度不明)。正确顺序是:榜单做初筛(砍掉明显不行的候选)→ 自建评测集做决断。花钱的方向别搞反。
常见问题
问题:为什么不做一个"总分"方便比较?
可以做(加权平均),但会掩盖维度间的权衡——A 模型安全分高但啰嗦,B 模型简洁但偶尔越界,总分相同体验截然不同。报告维度剖面,让决策者按业务权重自行加权。
问题:评估集多久更新一次?
真实用户问题分布会漂移(新话题、新措辞),评估集要滚动补充线上真实问题(脱敏后入库),季度级更新是常见节奏;同时保留固定核心集保证跨版本可比。
问题:小团队没有标注人力怎么办?
最小可行方案:一两百条真实问题 + 明确的判分标准(可执行的检查清单),用 LLM 裁判自动评分、人工只看分歧样本。半天可以搭建,覆盖 80% 的决策需求。
五、一份评估方案模板
把本节方法论压成一份可套用的方案模板,任何新项目把空填完,就得到第一版评估设计:
场景定义:本系统服务谁、解决什么问题、失败的业务代价是什么。(决定维度的权重分配)
维度选择与权重:从六维中选三到五个,按业务重要性排序。例如知识问答:忠实性大于准确性大于安全大于有用大于效率;代码助手:准确性(测试通过率)大于安全大于效率。
评测集设计:规模(起步一两百条)、来源(真实问题六成、边界对抗三成、回归用例一成)、判分方式(可对答案的用自动判分,开放式的给检查清单由裁判评)。
流程节点:选型时跑候选模型对比;发版时跑全量回归(安全项一票否决);线上持续看负反馈与抽样。
责任与节奏:谁维护评测集(建议产品与工程共担)、多久更新(季度滚动)、分数在哪里沉淀(报告入库,半年可追溯)。
这份模板的价值不在精巧,而在"从第一天就有评估"——本教程反复强调的评估纪律,落到实处就是这样一页纸。它比任何复杂的框架更能防止"凭感觉决策"的回潮。
补充:当指标之间打架时
实践中常遇到指标冲突:换新模型后准确率升、忠实性降;加长回答提升满意度、拉高成本。处置原则有三:安全永远优先于其他维度(不可交易的底线);其余冲突回到业务权重排序,用"哪个维度的退步是业务不可承受的"做裁决;把冲突显式记录在评估报告里,而不是取加权平均抹平——冲突本身往往揭示了产品定位的真实选择。评估报告的价值不只是分数,还有这些被记录下来的取舍。
常见追问:评估应该由谁负责——算法、产品还是测试?
三者共担但分工不同:算法负责指标设计与自动评估建设,产品负责维度权重与业务标准的定义(什么算"有用"最终是产品判断),测试或质量团队负责回归流程与发版门禁的执行。常见的失败模式是"只有算法在做评估"——维度权重失去业务输入,评出来的高分与用户满意度脱节。评估是团队协作的接口,不是某个角色的私产。
再追问:评估体系会不会拖慢迭代速度?
设计得当时恰恰相反。看似评估增加了发版前的两小时,换来的是上线后少熬的夜——没有评估的团队靠线上事故发现回归,一次事故的处理与信任损失远超两百次评估的总成本。关键是把评估自动化(评测集跑批、报告自动生成、门禁自动拦截),让它成为流水线的一部分而非人工关卡。评估拖慢迭代的团队,问题出在自动化不足,不在评估本身。
最后一问:六维之外还有没有被忽略的维度?
有,且随场景出现:合规性(输出是否符合行业监管的具体格式要求)、一致性(同一问题多次回答的稳定程度,对下游系统很关键)、公平性(不同用户群体上的表现差异,第 10.1 节)、可维护性(换模型的迁移成本)。六维是通用底座,行业特有维度要自己补——这正是"评估组合是产品设计一部分"的又一体现。
补记:评估术语速查
本章高频术语对齐:评测集也称测试集或回归集(在产品语境常混用,注意与训练用验证集区分);基准指公开的标准题库;裁判指给输出打分的模型;分位数指标指 P50、P95、P99 这类按百分位切的统计量;回归测试指对既有能力的复查。术语对齐后,跨团队沟通的损耗会显著下降——评估恰恰是最容易因术语歧义而吵架的领域。
最后留一道实践题:为你当前(或假想的)项目填写 8.1 节末尾那页评估方案模板,重点推敲维度权重的排序理由——写不出理由的权重,多半是人云亦云。填完请同事挑战一次,被问倒的地方就是方案的真实弱点。这份被挑战过的模板,质量已超过多数团队的正式评估文档,而它的成本只有一小时。
本节要点回顾
- 三重困境:通用性、开放性、主观性——决定了评估必然是"多维组合 + 人机结合 + 场景化"。
- 六维指标:准确性(对不对)、忠实性(编没编)、安全性(红线)、有用性(解决没有)、流畅性、效率;准确性与忠实性是两个问题。
- 三手段分工:自动(回归)→ LLM 裁判(批量)→ 人工(边界与关键);裁判有位置、长度、自我三类偏差,各有对策。
- 评估组合是产品设计的一部分,随场景权重而变;RAG 重忠实,对话重有用,代码重测试通过率。
- 榜单只做初筛,自建评测集做决断。
维度框架有了,下一节配备具体弹药:BLEU/ROUGE 怎么算、主流基准各测什么、以及怎么识破被污染的分数。