5.3 数值模拟:在计算机里重演宇宙
5.3 数值模拟:在计算机里重演宇宙
本节摘要:解析手段在引力多体问题面前只够处理两体,而宇宙网是亿亿体的非线性实验室。N 体数值模拟是冷暗物质模型接受审讯的终极法庭:它把模型假设喂进计算机,把可观测的星系分布吐出来,与巡天数据逐点对质。本节算清模拟的三本账——粒子质量与分辨率、软化长度与人为碰撞、两体弛豫时间与"无碰撞"承诺的兑现,看模拟既如何支撑模型、又在哪里够不着。
为什么纸上算不动了
前两节的扰动增长与等级成团,都刻意停留在"线性近似"——密度 contrast δ ≪ 1 时,方程是线性的,傅里叶各模各自独立演化,一切都有解析解。可一旦 δ 趋近 1,不同尺度的扰动开始互相耦合,引力把物质拉成丝、膜、结,解析工具全线失守。结构形成的后半场是非线性的,而非线性引力多体问题没有任何严格解——除了让计算机一时刻一时刻地硬算。
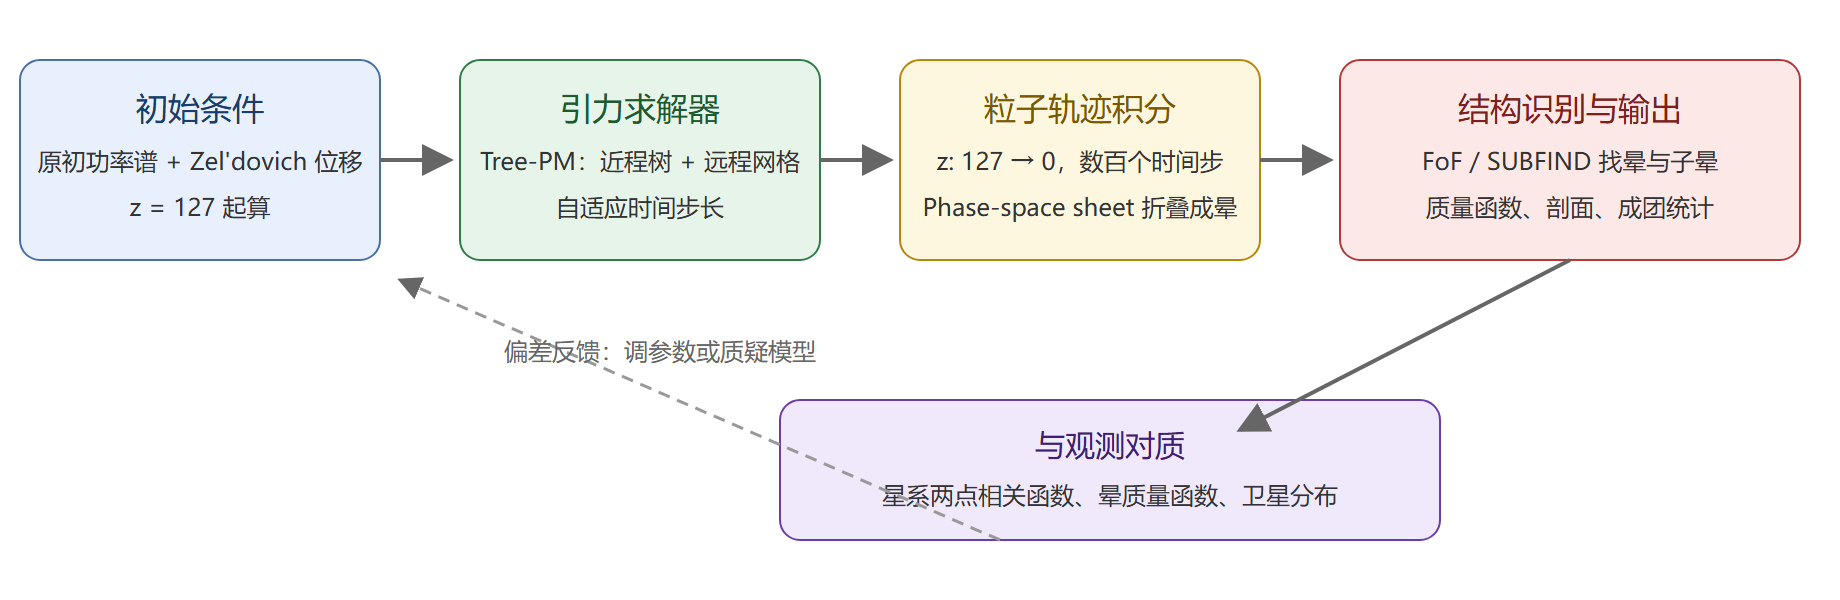
这就是 N 体模拟的地位:它不是"辅助可视化",而是模型的完整重演。给定期初条件(第3章从 CMB 读出的原初功率谱)、宇宙学参数(Ωm、σ8、n_s)和暗物质的粒子属性(冷、无碰撞、只有引力),程序从 z=127 一路积分到今天,产出一张"若模型为真则宇宙该长成什么样"的完整地图。与真实巡天对质,符合处是模型的战功,偏差处是疑点的来源(下一节的三个小尺度危机,全部诞生于模拟与观测的对质桌上)。
图:一次宇宙学 N 体模拟的完整流水线
二、分辨率的三本账
模拟的每一分分辨率都是算力买来的,三笔账必须算清楚。
第一笔:粒子质量。 把一个边长 500 Mpc/h 的盒子切成 2160³ 个格子,每个格子放一个粒子,就能算出这台"宇宙打印机"的最小零件有多重:
import math h, L, Np = 0.7, 500.0, 2160 ** 3 # 无量纲哈勃、盒边长 Mpc/h、粒子数 rho_m = 2.775e11 * 0.25 * h * h # 临界密度 2.775e11 h^2 Msun/Mpc^3 乘 Omega_m M_box = rho_m * (L / h) ** 3 # 盒内总质量(换回 Mpc) m_p = M_box / Np sep = (L / h) * 1000.0 / Np ** (1.0 / 3.0) # 平均粒子间距 kpc print("N = 2160^3 = %.4e" % Np) print("盒内总质量 = %.3e Msun" % M_box) print("粒子质量 = %.2e Msun(Millennium 基准 8.6e8/h,比值 %.2f)" % (m_p, m_p / (8.6e8 / h))) print("平均粒子间距 = %.0f kpc,软化长度 7 kpc 占其 %.3f" % (sep, 7.0 / sep))
输出:
N = 2160^3 = 1.0078e+10 盒内总质量 = 1.239e+19 Msun 粒子质量 = 1.23e+09 Msun(Millennium 基准 8.6e8/h,比值 1.00) 平均粒子间距 = 331 kpc,软化长度 7 kpc 占其 0.021
一亿个粒子,每个重约 12 亿个太阳——这就是 2005 年 Millennium 模拟的分辨率。它足以分辨星系团的内部结构,但一个 1e8 Msun 的矮星系暗晕里只有几十个粒子:矮星系层面的物理,这台机器根本演不动。想看清小尺度,要么换"缩放模拟"(zoom-in,把算力聚焦到单个银河系型晕上,如 Aquarius 系列),要么接受穷举与真实之间隔着一个数量级的差距。数字宇宙的每一寸清晰度都有标价。
第二笔:软化长度与人为碰撞。 引力在 r→0 处发散,而粒子近似下两个粒子靠得太近会产生不属于物理的巨大加速度。做法是给引力"软化":把点质量换成一团半径 ε 的软核。Millennium 的 Plummer 等效软化 5 kpc/h(约 7 kpc),恰好是平均粒子间距的 2%——比它软,密度峰被抹平;比它硬,两体散射噪声污染轨迹。软化长度的取舍,本质是在"分辨率损失"与"离散噪声"之间走钢丝。
第三笔:两体弛豫——"无碰撞"承诺的审计。 冷暗物质粒子被假设为只受引力、两两不碰撞(第4章候选粒子的共同属性)。但模拟里的"粒子"是超粗颗粒,颗粒之间会靠引力散射交换能量——这是数值假象,不是物理。检验标准是两体弛豫时间:一个系统里恒星/粒子因两两散射而"忘记"初始轨道所需的时间。经典估算给 t_relax ≈ 0.1 N/lnN 个穿越时间,N 是系统内有效粒子数:
import math for N in (1e6, 1e3): t_relax = 0.1 * N / math.log(N) # 单位:穿越时间 t_cross print("N=%.0e:t_relax = 0.1N/lnN = %.0f 个穿越时间" % (N, t_relax))
输出:
N=1e+06:t_relax = 0.1N/lnN = 7238 个穿越时间 N=1e+03:t_relax = 0.1N/lnN = 14 个穿越时间
银河系年龄约几百个穿越时间。一个晕内若有一百万个模拟粒子,弛豫时间七千多个穿越时间——远长于宇宙年龄,无碰撞承诺兑现;可一旦矮晕里只塞得下一千个粒子,弛豫时间缩到十几个穿越时间,模拟的晕会因数值两体散射自发"变热变圆"——你看到的不是冷暗物质的宇宙,是离散化的假象。Aquarius、Phoenix 这类缩放模拟动用千万至上亿粒子只为了单个晕,动机正在于此。
三、从粒子云到目录:结构识别
跑完积分,得到的是一坨位置与速度的粒子快照,离"宇宙学结论"还差一步翻译。主流做法两条路线:Friend-of-Friends(FoF)按互联距离阈值把粒子串成"团",适合定义母晕;SUBFIND 在团内再做自引力子结构搜索,剥离出子晕——卫星星系应住的那些"子单元"。识别出的晕目录(质量、自旋、浓度、子晕数量)才是与观测对质的界面:晕质量函数对质星系团计数,两点相关函数对质星系巡天,子晕速度函数对质银河系卫星分布。模拟的"预言"从来不是那张绚丽的粒子图,而是目录里的统计量。
四、易错点与边界
- 把模拟当真理:模拟输出的是"给定假设下的必然",不是"必然本身"。假设换了(温暗物质、自相互作用暗物质、不同 σ8),同一台机器产出不同的宇宙——模拟是审讯室,不是法官。
- 分辨率断言越界:低于粒子质量的暗晕不可信。看到"模拟预言上百万个卫星子晕",先问一句:每个子晕里有几个粒子?
- 重子物理缺位:纯暗物质模拟没有恒星反馈(下一节的尖点问题与此直接相关)。把"暗物质-only 模拟"的剖面直接对质观测,是文献里最常见的误读。
本节要点回顾
- 模拟的必要性:结构形成后半场非线性,无解析解;N 体模拟是模型假设的完整重演与对质界面。
- 分辨率三账:粒子质量(Millennium 1.2e9 Msun)、软化长度(间距的 2%)、两体弛豫时间(N=1e6 时 7238 个穿越时间,N=1e3 时仅 14 个)。
- 无碰撞审计:弛豫时间必须远超宇宙年龄,否则数值散射污染结论;缩放模拟为此而生。
- 输出是目录不是图:晕质量函数、相关函数、子晕统计才是可观测对质项。
模拟给了冷暗物质法庭上最强势的证词——星系团尺度全胜。可镜头一拉近到矮星系,同一批模拟被判了三张黄牌。下节把这三张黄牌摊开。