5.4 生信图表怎么读
5.4 生信图表怎么读
本节摘要:组学论文的法庭往往是几张图:PCA 看样本散开,火山图看差异,热图看模式,通路图看故事。这些图都经过过滤、归一、着色和裁剪。会读图的人先找批次、样本对调、过滤标准和多重检验,再决定是否相信图注里的生物学句子。生信基础不是学会每一个软件,是学会质问图是怎么画出来的。
本节导航
阅读完本节,你应当能够:
- 在 PCA 上区分处理效应、批次效应和离群样本
- 说明火山图的横轴纵轴、阈值线和多重检验
- 识别热图聚类如何被选基因和行标准化操纵
- 把通路富集当成假说发生器,检查背景基因集是否公平
PCA:先看谁和谁站一起
主成分分析把高维计数压成能画的轴。如果处理组分开,可能真有全局差异,也可能批次与处理重合。看图例:同一天的样本是否抱团,而不是同一处理抱团。一个样本远离所有人,先查混样、降解、测序失败,不要封它为“新亚型”。
把它当成把全班体检表压成一张座位图。座位分开,可能是男女,也可能是体检当天仪器换了。你要先问座位标签是处理还是日期。日期抱团而处理混坐,批次大于生物学,差异表该停。
读 PCA 的口头禅: 轴旁标的方差比例有多大 颜色若改成批次还清不清楚 有没有单点离群 技术重复是否叠在一起 不叠则流程不稳
归一和过滤会改变 PCA。用全部基因和只用高变基因,形状不同。作者应用哪一种要说清。你作为读者,看到完美分开却没有 QC 补充图,应提高怀疑。
| 图 | 它擅长 | 它会藏 |
|---|---|---|
| PCA / MDS | 全局结构、离群、批次 | 少数基因驱动的效应 |
| 火山图 | 统计与倍数两维 | 过滤前的噪声、阈值任意 |
| 热图 | 模式展示 | 选基因与标准化造成的假模块 |
| 通路泡泡 | 叙事压缩 | 背景偏倚与循环论证 |
| 桑基 / 网络 | 看起来像机制 | 边的证据强度 |
火山图和热图:阈值是政策不是自然
火山图横轴常是对数倍数,纵轴是负对数 p 或校正后 p。右上左上的点是“又大又显著”。线画在哪里改变名单长度。未做多重检验校正的火山图在基因组尺度上会撒满星星。看图注有没有写清楚校正方法。点的大小或颜色若编码平均表达量,低表达却极显著的点要小心。
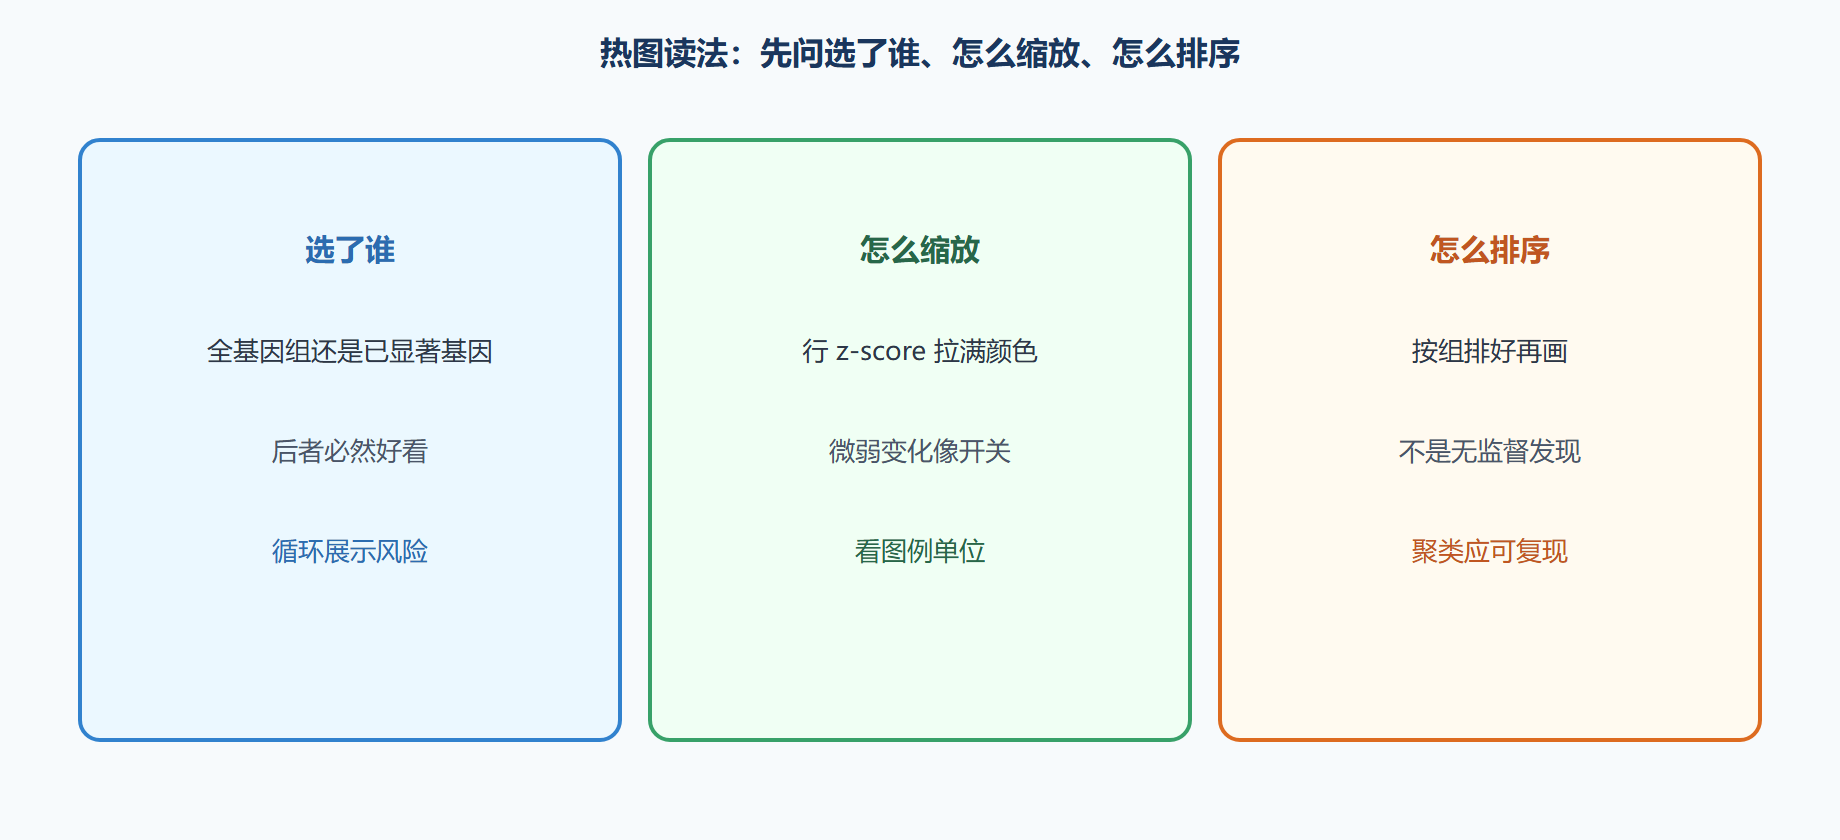
热图最容易被操纵。只用已经差异显著的基因再聚类,分组当然漂亮,这是循环展示,不是独立发现。行标准化让每条基因的动态拉满颜色,微弱变化看起来像开关。看图例是 z-score 还是原始值。列如果按组分好再画,不要称之为无监督发现。无监督应让算法自己排,再看是否与标签吻合。
⚠️ 常见坑:把通路图里的箭头当成自己数据测到的调控方向。那是数据库里的先验卡通,不是你的样本测出来的边。
💡 关键直觉:图是论点的海报。海报可以诚实,也可以只贴好看的一层。读图注和补充方法比读配色重要。
多重检验:你同时问了上万个基因,偶然显著一定发生。校正过严会漏真,过松会假。报告应同时给读者看效应大小。只有 p 没有倍数,或只有倍数没有不确定性,都不够。
图 一张热图能藏的三件事
通路、网络、可重复性
富集分析问:我的基因名单是否过度代表某条注释。背景必须是你实际检测过的基因,不能用全基因组当背景——没检测到的基因根本没有资格进名单。长度偏倚、表达量偏倚会让核糖体、大基因、高表达基因的通路反复亮起。这些通路可能是真的,也可能是检测窗口。
网络图的边若来自公共数据库,那是文献累积的可能相互作用,不是你测到的。把你的差异基因涂上去,得到的是“这些基因曾经在别的论文里被画在一起”,价值有限。要声称相互作用,需要你自己的结合或邻近证据。
可重复性:随机种子、软件版本、基因注释版本都会改名单。方法应写到能让别人跑出相近表。作为读者,对没有补充表、没有阈值、没有代码说明的漂亮图,降低权重。
与湿实验互证:图上的关键基因应能回到 qPCR、印迹、功能。全通路都验证不可能,但故事中心的两三个分子必须钉住。组学的正确用法是缩小候选,不是替代机制实验。
问题:p 值校正后什么都没了,是不是实验失败?
可能效应本来就小、重复不够、或校正过严。看效应大小分布和 PCA。若 PCA 已按处理分开而校正后空,也许该加重复而不是改用未校正 p 值硬发。空也是结果。
问题:能不能只看倍数不管统计?
倍数没有不确定性。重复差时倍数可以很大。两维都要。临床标志物还要看独立队列,不是同一张火山图里再切一刀当验证。
颜色条没有单位的图,默认不可信。发散色图把零点放中间,适合 z-score;顺序色图适合原始计数。用错色图会让无变化看起来像强调控。点图和箱线应显示原始重复,而不是只给星星。没有点的柱状差异,在组学补充图里尤其要怀疑。样本名若被改成“处理 1、2、3”,去补充表找回真实批次。
预注册分析计划在临床组学越来越必要:先写清终点和校正,再看图。探索性分析可以做,但要标记为探索。把探索当验证,是可重复性危机的分子版。审稿时你也可以用同一标准要求别人:阈值、背景、软件版本、随机种子。缺这些的漂亮图,权重下调。
把关键基因的原始计数手工抽出来画一遍,常能发现对调或命名错误。自动化流程会把样本 1 和样本 10 排错。动手优先在生信里不是拒绝软件,是保留用原始数字抽查的肌肉。图是压缩,压缩会丢异常;异常有时是发现,有时是事故。你要先能看见它。
读图时先找样本数是否等于方法里的重复数,少了的点是否被静默剔除。剔除规则要事先,事后剔除离群要报告。颜色是否色盲友好是礼貌,单位是否存在是科学。主成分的载荷若由核糖体基因或性别基因驱动,处理故事要改写。热图聚类的树要可重复,换距离度量若完全改形状,就不要把模块讲得太实。通路富集的输入若是全部差异基因,输出常是大而空的细胞过程;若是人工挑选,又是循环。两种都要在图注坦白。把图当作会撒谎的证人,用原始计数盘问。盘问过的图才能进主文。这是生信的台上纪律,和空对同一家族。
图注应使人不读正文也能知道比较的是谁、过滤了什么、校正了什么。做不到的图注是装饰。补充方法写软件版本和随机种子。主成分若第一轴是性别或批次,处理效应可能在第二轴,要如实写。火山图把低表达点画淡,避免读者被噪声星星吸引。热图若必须用已筛选基因,标题写差异基因展示而不是无监督发现。用词诚实能减少一半的争吵。把原始计数表放进补充,让反对者能重画。不能重画的发现,权重按不可审计处理。
图注写不清比较对象和过滤标准的图,按装饰处理。热图若只用已显著基因,标题必须写展示而不是发现。原始计数不提供的论文,审计权重下降。主成分先按批次着色。通路图的箭头是文献卡通,不是你测到的边。探索与验证分开标记。关键基因回到湿实验,组学只缩小名单。
图注先于配色。批次先于亚型。展示先于发现。卡通边先于机制。原始表先于星星。探索与验证分开。关键分子钉回湿实验。不能审计的漂亮,权重按装饰。剔除规则事先写。色图单位必须存在。软件版本和种子写进方法。
图注、批次、展示、卡通、原始表、探索标记、湿实验、可审计,八个先于配色。剔除事先写。单位必须有。版本和种子必须有。第一轴是性别时如实写。星星不是发现。不能重画的论文按装饰降权。生信的空对就是原始数字抽查。
读图时再补一张常被忽略的图:MA 图。横轴是平均表达量,纵轴是对数倍数。火山图把低表达噪声点也画成星星;MA 图会把这些点摊在左侧,让你看见“显著”是否集中在几乎测不到的基因上。若差异像一把扇子只在低表达端张开,优先怀疑过滤阈值和文库深度,而不是生物学开关。GSEA 一类不切硬阈值的富集,看的是整条排名的偏移,而不是差异名单长短。此时要问排序依据是统计量还是倍数、基因集版本是哪一年、置换次数是否写进方法。NES 很大但核心基因全是核糖体,故事仍可能是检测窗口,不是通路被拧开。
把每一张图当成证人:先盘问它怎么被选中、怎么缩放、怎么排序,再听它说话。选中已显著基因再聚类,证人与法官是同一人。原始计数是交叉盘问的材料。不提供材料的证人,庭上降权。交叉盘问用原始计数,不用上色后的感觉。感觉很强的模块,常常是缩放制造的。证人与法官分离:筛选名单的人不要同时担任聚类叙事的唯一讲述者。上色后的模块若经不起原始计数盘问,就把它从主文拿掉。
MA 图左侧扇开时先加过滤,不要先加故事。低表达端的星星优先当深度不足。
要点速记
- PCA 先查批次和离群:再谈亚型。
- 火山图阈值是政策:看校正与表达量。
- 热图最易循环展示:问选基因、缩放、排序。
- 通路是假说发生器:背景基因集要公平。
- 网络边默认是文献卡通:不是你的测量。
- 可重复性写进方法:版本与阈值。
- 关键分子必须湿实验钉住:组学缩小名单,不结案。
下一章把工具对准基因组本身:CRISPR 怎么设计,表达系统怎么选,诊断怎么落地,以及哪些事能做但不能做。