5.3 质谱蛋白质组与搜库
5.3 质谱蛋白质组与搜库
本节摘要:蛋白质组实验把蛋白切成肽段,电离后按质荷比打碎,用谱图对照蛋白质数据库“搜库”还原身份。它测量的不是直接的蛋白浓度计,而是可检出肽段的证据。动态范围残酷:高丰度蛋白挡住低丰度;修饰要专门富集。读鉴定表时把谱图数、肽段覆盖、假阳性率和定量方法分开,才不会把“看见了”写成“一样多”。
本节导读
阅读完本节,你应当能够:
- 说明胰蛋白酶切在哪些残基后切开,以及漏切如何影响鉴定
- 区分数据依赖采集与数据独立采集对定量的含义
- 解释标记定量与无标记定量各自的批次陷阱
- 判断磷酸化或糖基化实验为何不能用普通全蛋白流程蒙混
胶条只是入口,肽段才是旅客
你可以先跑 SDS-PAGE 切条,也可以溶液消化全蛋白组。共同点是蛋白酶把蛋白切成适合质谱的肽段,胰蛋白酶切在赖氨酸、精氨酸后,产生带电荷、长度合适的肽。漏切、太短、太疏水、太长的肽段进不了检测窗口。蛋白鉴定依赖“足够多的可检测肽”,没有肽段证据的区域等于盲区,包括某些极端序列和膜蛋白跨膜段。
把它当成把一本书切成句子,用句子碎片去图书馆对目录。目录(数据库)里没有的蛋白,你对不上,可能被错配到同源物。目录错了或消化不完全,句子对不上号。质谱很灵敏,但对目录和消化的依赖是硬的。
常见流程骨架: 提取与还原烷基化 酶切 胰酶为主 脱盐 液相分离 质谱碎裂 搜库 给 FDR 定量 若实验这样设计
电离竞争让高丰度肽压制低丰度。血浆里白蛋白一类明星会占满舞台,不耗竭就很难看见细胞因子。细胞裂解液同样有骨架蛋白霸榜。分级、耗竭、富集是在重新分配舞台灯光,不是作弊。
| 定量策略 | 优点 | 代价 |
|---|---|---|
| 谱图计数 | 简单 | 饱和、对低丰度粗糙 |
| 无标记峰面积 | 不必标记 | 跑间可比性差,要随机化 |
| 同位素标记同一混合 | 同一针比较准 | 标记试剂与通道数限制 |
| 靶向监测 | 灵敏度与可重复 | 预先要名单,不是发现型 |
搜库是带假阳性率的对赌
搜库引擎把谱图和理论肽段碎裂匹配。允许的漏切数、可变修饰、质量误差窗口,都会改变谁被叫 identifi。开太多可变修饰,搜索空间爆炸,假阳性上升。假发现率 FDR 用诱饵数据库估计,报告鉴定必须带 FDR 阈值。只有一条低分肽的“蛋白鉴定”不该进故事。
数据依赖采集爱挑最亮的肽做碎裂,每次跑到的名单不完全一样,缺值很多。数据独立采集按规定窗口碎所有离子,缺值少、更利于定量,分析更重。选型看你要发现新蛋白还是比较已知一组。
修饰蛋白质组必须富集。磷酸化肽在全消化物里太稀,不过富集柱就基本看不见。糖肽更麻烦,需要专门方法。用全蛋白组数据里偶发的一个磷酸化谱图去讲信号通路,证据太薄。
⚠️ 常见坑:把未校正的搜库结果里分子功能注释直接当样本里的活性。鉴定的是肽段序列,不是酶正在工作。
💡 关键直觉:蛋白质组的单位是可检出肽段的证据强度。换酶、换柱、换梯度,名单会变,这不是生物学自己在变。
污染蛋白:角蛋白来自皮肤和尘,胰酶自切肽,牛血清来自培养基。搜库应包含常见污染列表。实验台不戴手套,角蛋白会成为你最稳定鉴定到的“生物标志物”。
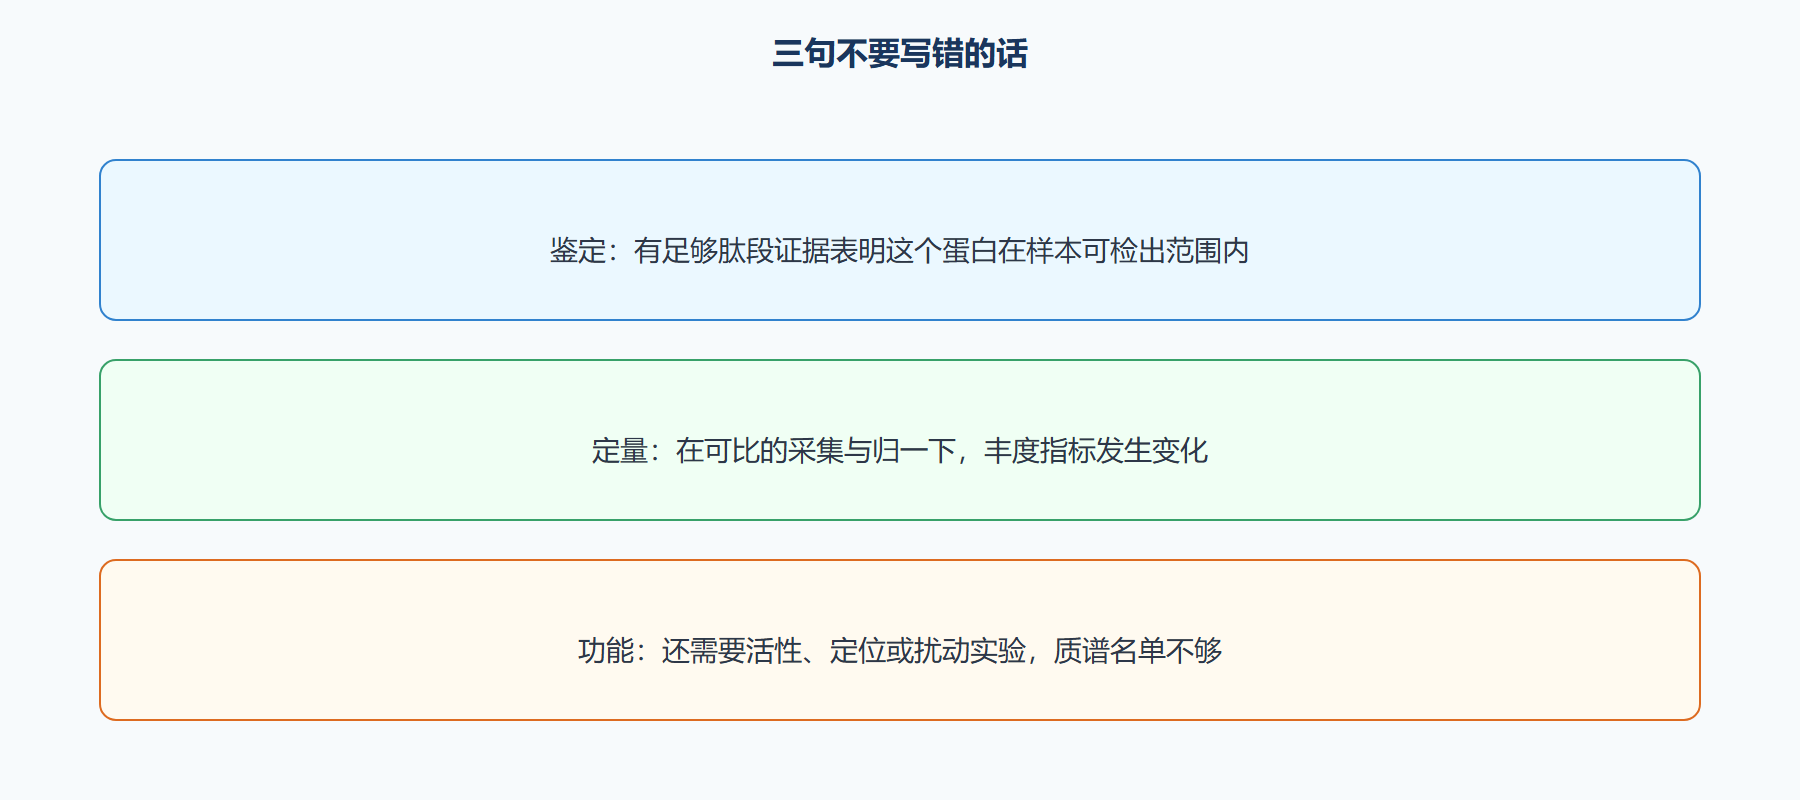
图 鉴定不等于定量
工程实践:样品到柱子之前
去垢剂必须质谱可兼容或能除掉。SDS 残留是喷雾杀手。盐要脱。消化时间与酶比要稳定,否则漏切变成批次。同一项目锁定酶批号和柱子方法。随机化进样顺序,穿插空白和质控样品,看滞留时间和鉴定数漂不漂。
动态范围:不要指望一次全蛋白组覆盖转录因子和骨架蛋白同样好。要看低丰度,做富集或更深分级,并接受名单变窄。这和基因组覆盖度逻辑相似:舞台灯光有限。
与 RNA-seq 对照很有用。mRNA 和蛋白经常不一致,这是生物学(翻译与降解)也是检测窗口不同。不一致不是自动证明哪边错,两边 QC 都过才有资格讨论调控层次。两边都脏,就先收摊。
抗体验证、靶向质谱、平行反应监测,可以把发现型名单里的关键蛋白钉死。临床标志物尤其不能停在一次无标记发现。
问题:搜不到我的标签蛋白是不是没表达?
可能分子量跑到胶外、酶切肽段不适合、修饰太重、量低于检测、数据库没包含你的标签序列。把标签序列加进数据库,看胶和免疫印迹。质谱不是否定表达的第一工具,尤其对你自己造的融合蛋白。
问题:FDR 1% 是不是足够严?
蛋白水平 FDR 和肽段水平 FDR 不是一回事。大型研究还要考虑批次间的累积假阳性。关键结论蛋白应有多肽段、好分数,并正交验证。把 1% 当免死金牌会后悔。
烷基化半胱氨酸是消化前的常规,防止二硫随机重排。漏做会让谱图变脏。酶切不完全时,大肽段电离差,覆盖下降,看起来像蛋白不在。质控肽或标准蛋白混合物应穿插进序列,看滞留时间和鉴定稳定性。柱子老化会让峰展宽,定量漂移,看起来像生物学下调。仪器维护是蛋白质组的“空对”。
磷酸化富集的重复性通常差于全蛋白组,需要更多重复和更严的验证。位点定位分数低时,不要把磷酸画在特定丝氨酸上讲机制。糖基化更复杂,同一位点多种糖型。发现型糖组学不是 Western 带糊的自动解释。脂质和代谢物会污染某些提取,正离子模式里出现一堆不是肽的峰,搜库会乱配。前处理要为质谱服务,不是为了胶好看再“顺便进质谱”。
与抗体组学或细胞因子芯片交叉时,记住亲和试剂有交叉反应,质谱有检测限。两者不一致时,两边 QC 都过才能吵机制。一边脏,先收摊。蛋白质组的动手优先,就是让柱子、消化和 FDR 比通路图更早出现在讨论里。
进样前用标准肽看灵敏度,掉了先洗柱或换针,不要硬打珍贵样品。空白进样应干净,残留峰说明携带污染,定量会串样。随机化进样顺序,穿插质控。搜库的分类学数据库要匹配,植物样本用细菌库会得到荒唐鉴定。可变修饰开磷酸化又开氧化又开脱氨,空间爆炸,FDR 失真。只开你真正关心且化学上合理的。定量软件的缺值填充策略要报告,填充会制造假精密。关键蛋白用靶向方法钉死。发现型名单是候选池。把候选池当金标准,是蛋白质组最常见的越权。角蛋白出现时检查手套和头发,而不是给皮肤蛋白写通路故事。
消化对照蛋白应出现在鉴定表前排,否则消化失败。漏切比例过高要改酶比或时间。标记定量的通道串扰要校正,不校正的高倍数可疑。无标记的滞留时间对齐失败会造假差异,看质控图。磷酸化位点定位用概率阈值,低于阈值只报肽段不报位点。抗体验证过的位点才能画进机制图。宿主污染、血清污染、酶自切写进过滤。过滤名单公开。动态范围不够时承认看不见转录因子,不要用未鉴定所以不表达的句子。看不见是窗口,不是生物学零。
消化对照蛋白不在鉴定表前排,就不要解释生物学。漏切、串扰、滞留时间对不齐,都会造假倍数。看不见转录因子时写窗口不够,不要写该因子不表达。修饰实验必须富集,全蛋白组里的偶发谱图太薄。角蛋白是手套问题。鉴定、定量、功能三句话分开写,名单不是活性。
对照蛋白不在前排就停解释。修饰必须富集。鉴定定量功能分开写。看不见写成窗口。角蛋白查手套。缺值填充要报告。通道串扰要校正。名单是候选池。可变修饰开太多会炸搜索空间。去垢剂残留杀喷雾。进样随机化,空白要干净。
对照蛋白前排、修饰富集、三句话分开、窗口不是零、手套、填充、串扰、候选池,八项构成放行。搜索空间爆炸来自乱开修饰。去垢剂杀喷雾。空白不干净就是串样。位点分数低不画机制图。名单再长也买不来活性测定。
放行八项再核:对照蛋白前排、修饰已富集、三句话分开、窗口不是零、手套、填充策略、串扰校正、名单为池。八项缺一不画通路。搜索空间不乱开。去垢剂不残留。空白要干净。活性另买实验。
把肽段证据强度当成单位,不要把蛋白名字当成单位。换酶换柱换梯度,名单会变,这是窗口在动。窗口移动时,生物学叙事必须停。等窗口稳定,再让叙事前进。稳定的定义是质控样品的鉴定数不再漂移。
质控样品鉴定数稳定,窗口才算站住。站住之前的倍数变化,优先当仪器故事。
窗口一旦被承认,看不见就不能再被翻译成不存在。
窗口站住以前,倍数优先当成仪器在说话。
质控样品的鉴定数不再漂移,叙事才被允许前进。
漏切和可变修饰会膨胀搜库空间。修饰开得太多,假谱匹配会涨。固定修饰必须与样本处理一致:烷基化开了,就不要假装半胱氨酸还是自由的。定量前先看鉴定数是否在质控样品上稳定,不稳定的倍数变化优先当仪器故事。
温故知新
- 质谱读肽段:蛋白身份是搜库推断。
- 胰酶规定窗口:有的序列天生难见。
- 动态范围残酷:高丰度挡住低丰度,要耗竭或富集。
- FDR 是门票:单低分肽不够写进故事。
- 鉴定 ≠ 定量 ≠ 功能:三句话分开写。
- 修饰要富集:全蛋白组里的偶发修饰谱图太薄。
- 角蛋白是手套问题:污染列表要开。
下一节专门读图:PCA、火山图、热图和通路泡泡,怎样把上游事故画成“发现”。