1.3 历史沿革与重要里程碑
1.3 历史沿革与重要里程碑
本节摘要:发育生物学的历史是一部"先看对问题、再找工具、再改问法"的接力赛。从预成论与渐成论之争,到实验胚胎学的显微手术,再到遗传筛选与分子克隆,最后被活体成像与基因编辑改写。本节用一条年代线把斯佩曼、沃尔珀特、尼森-福尔哈德等里程碑事件串起来,并用一个模式动物换算模型解释"效率"如何塑造了研究对象的选择。
学习目标
阅读完本节,你应当能够:
- 说出预成论与渐成论之争大致输赢在哪一步。
- 按时代排列:实验胚胎学 → 遗传筛选 → 分子时代 → 成像与基因编辑。
- 说明沃尔珀特的法国国旗模型为何被视为模式形成理论的转折。
- 用"世代时间 + 可控性"两个变量解释一个物种为何成为模式动物。
从"看整只鸡"到"盯着一个细胞":学科的第一段路
发育生物学最初谈不上实验,更接近"描述"。十七世纪就有"预成论"——认为胚胎里早已蜷着一个微型小人,只是被放大;与之对抗的是"渐成论"——相信结构是逐步从头生成的。两派在当时只能靠看,分不出胜负。真正让天平偏向渐成论的,是日益精细的观察:人们发现心脏、血管不是一开始就在那里的,而是渐次出现的。查尔斯·博内、卡斯帕·沃尔夫等人的工作让"渐成"占了上风。
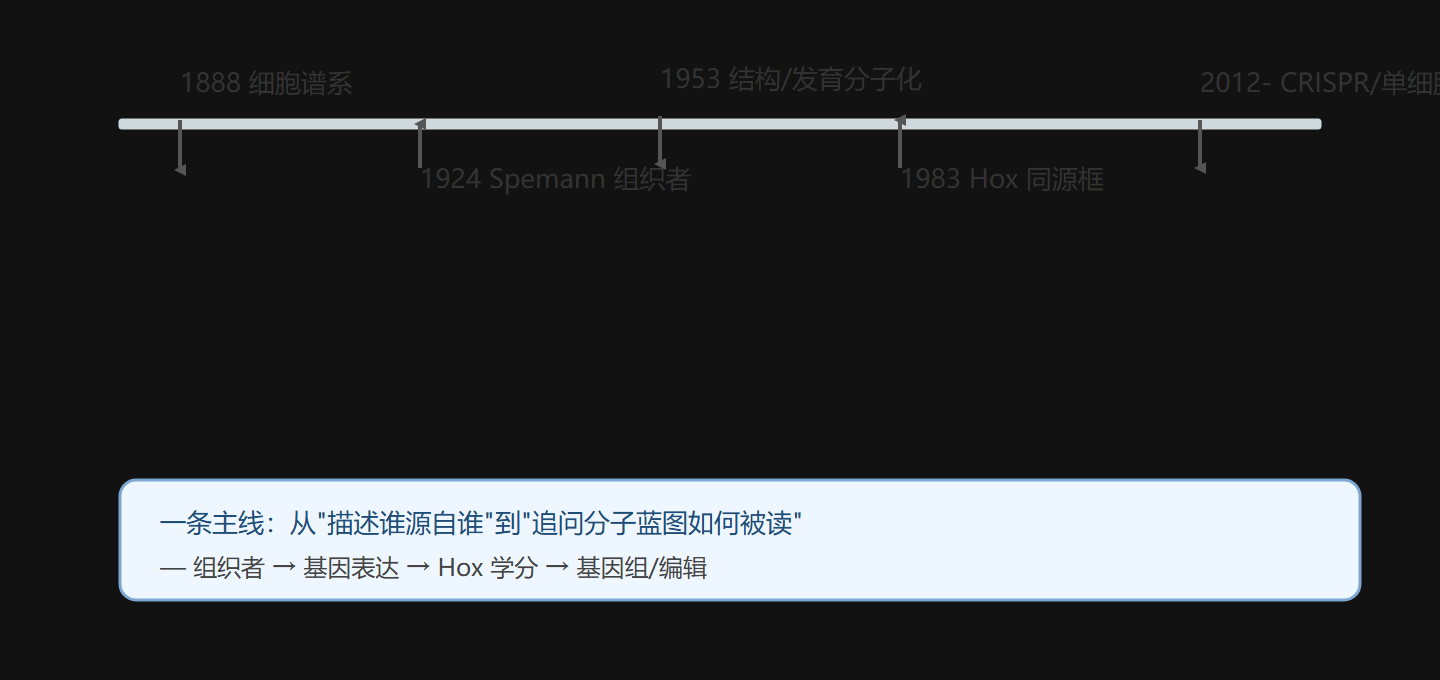
转折发生在显微手术。关键节点有两处:1888 年威廉·鲁用热针杀死蛙胚胎两个分裂球中的一个,观察剩下那个是否还能正常发育(它不能,这让他一度支持"每个细胞各管一块"的镶嵌论);短短三年后,汉斯·德瑞施把海胆胚胎的两个分裂球分开培养,却得到两个完整的幼虫——这从根本上推翻了"每个分裂球只负责自己那一块"的简单镶嵌观,证明细胞命运在早期是可调节的(调适论/regulation)。同一个问题,两个人用更干净的操作得出相反答案,这正是实验胚胎学的魅力与本真。
从这段历史我们能带走一句话:发育规律是靠"在同一问题上反复改操作条件"试出来的,不是靠一次观察定的。 这个习惯今天依然是硬核发育工作的底色。
组织者、梯度与图灵都是"图纸"问题的解
进入二十世纪,问题从"细胞各管一块还是可调节"升级成"那么位置分工是怎么定的"。这里串起三条让我特别佩服的线索:
1924 年斯佩曼与曼戈尔德证明背唇组织者能把腹侧细胞重新定向(上一节讲过的实验);1935 年斯佩曼获诺贝尔奖。这个结果暗示存在某种来自局部的"全局指令",但没人知道它是什么信号。
1940 年,一台看似与生物学无关的数学工作插了进来——图灵在 1952 年提出反应-扩散模型,证明两种相互作用的分子在扩散下能自发长成有条纹或斑点的模式。这第一次从数学上证明"模式可以自发生成,不需要外部地图"。图灵当时想解释的是诸如蛇的斑纹那样的模式。
1969 年沃尔珀特给出教科书级的概念化:法国国旗模型(梯度当尺子)。它是把"局部信息 + 全局秩序"这条线钉死的一根钉子。自此,"谁决定分工"被拆成一个可被实验定量的问题:一个梯度,几个阈值,几种命运。
我建议记住这三条线的次序:组织者(谁是指挥)→ 图灵(自发生成)→ 沃尔珀特(梯度当尺子)。它们不矛盾,而是各自回答"指挥权的来源"的侧面。
遗传筛选把研究从"看"推向"改"
直到二十世纪七十年代,发育工作主要还是"看"和"切"。让学科能系统性、可遗传地问因果的,是果蝇上的一场大筛。克里斯蒂安妮·尼森-福尔哈德和埃里克·维绍斯在 1970 年代末开始做一个今天看也极其大胆的事:大规模诱变果蝇,筛那些体节模式被破坏的单基因突变体。
她们的做法本质上是把"发育坏在哪一环"变成可数的问题:让随机突变扫过基因组上万个基因,再一只只看幼虫体节花纹有没有出纰漏。结果她们找到了决定体节分段、极性的一批基因,把"前后轴由一系列基因按序分节"从抽象概念变成一张可考的基因清单,因此共享 1995 年诺贝尔生理学或医学奖。
遗传筛选之所以是转折,是因为它把发育问题的探针从"我们的想象力"换成了"基因组里既有的字幕"。你不必先猜是哪个分子——你只要让突变替你翻回答卷。这个思路后来被 CRISPR 等工具进一步提速。
下面这个小 Python 帮我看清"为什么遗传筛选这么吃动物数"——它本质上是在数随机突变里要多久才能撞上目标基因:
import numpy as np def screen(size, target_hits, trials): rng = np.random.default_rng(0) found = 0 n = 0 while found < target_hits and n < 10_000_000: n += 1 # 随机一位上产生突变,命中目标基因的概率约 1/14000 if rng.random() < 1.0 / size: found += 1 return n size = 14000 # 果蝇蛋白编码基因数 print(f"要撞上目标基因至少一次,平均约需 {screen(size, 1, 5000):,} 只突变体")
计算结果是平均要检视上万只果蝇才能攒到一个命中——尼森-福尔哈德当年剪了几十万只,靠的正是这个量级。这解释了一个常被忽略的现象:模式动物的选择,很大程度是被"可大量繁殖 + 世代时间短"这种效率变量逼出来的。 天上不会掉下一个好模型,是效率筛出来的。
分子时代以来:从克隆基因到实时盯胚胎
进入分子时代后,三条技术分别改写了研究方式。其一,分子克隆让我们能拿到、能改某个具体发育基因,把"瀑布画成阶梯"(每个基因出的蛋白影响下一级)变成了实验对象。其二,荧光蛋白结合活体成像,让我们能长期盯着同一只活胚胎里单个细胞往哪跑、变什么,把静态切片式胚胎学升级为动态叙事。其三,组学(单细胞测序等)让我们不再只看一两个明星基因,而是一次看到整个转录组在发育中的全貌。这几条线在第六章会逐一展开。
⚠️ 常见坑:把"历史顺序"误当成"因果顺序"。图灵模型(1952)在分子时代才被大量实验证实——数学预先给出可能性,实验后来补上证据,两者之间的空白期很容易让人误以为模型是对未来的空谈,其实它只是等工具。
💡 关键直觉:这门学科的每次跃迁,多半不是"想通了新理论",而是"换了一把新探针"。组织者可以用手术证明,却要等分子生物学才点破它真正分泌的信号;遗传筛选需要海量果蝇,却让因果问法从此有了标准接口。
本节要点回顾
- 预成 vs 渐成:观察与微分找到了答案,渐成论胜出。
- 镶嵌 vs 调适:德瑞施的分裂球实验证明早期细胞命运可调,推翻了严格镶嵌观。
- 三线图纸:组织者(谁指挥)→ 图灵(模式可自发)→ 沃尔珀特(梯度当尺子)。
- 遗传筛选:让突变替研究翻问答卷,由效率决定模式动物的选择。
- 分子与成像:把静态切片升级为可定因果、可实时观察的动态科学。
我们现在有了定义、概念和历史三块基石,可以进入真正的"建造现场"了。第二章从受精开始,一步步看一个合子如何被切分、翻折、定轴。
图 1-3 发育生物学关键里程碑时间线