6.5 生物信息学与计算建模
6.5 生物信息学与计算建模
本节摘要:组学给你海量表格,生物信息学负责把它们变成可问的问题,计算建模负责把"如果这个基因多一点,那个会怎样"变成可以解的数字。本节走完"数据清洗 → 网络构建 → ODE 模拟"三步,用一个典型的基因调控网络(GRN)微分方程例子,看一个形态发生素梯度为何能在稳定态里"读出自位置"。
学习目标
阅读完本节,你应当能够:
- 区分"统计数据"与"机制模型"两类任务在发育研究里的分工。
- 说清降维聚类与"找调控网络"之间的区别。
- 用一个简单 ODE 描述"信号-靶基因"的动态,并预测稳态。
- 认识模拟的局限:参数未知、方程是近似的。
从表到问:生物信息学在干嘛
发育生物学的计算工作大体分两摊。统计侧负责"从数据里看发生了什么"——就是上一节那套降维聚类、差异表达、轨迹推断,它不预设机制,偏"让数据说话"。机制侧相反,先写下"我猜是这个回路在起作用",再用模型检查这个猜测自洽不自洽。两者一拍即合:统计发现哪些基因在某个窗口共变(候选调控关系),机制模型再去检验"若是这个关系,动态会是什么样"。
网络:把共表达变成结构
一个基因常被另一个基因的产物调控,于是成千上万基因之间织成一张网——基因调控网络(GRN)。构建的朴素办法是共表达/互信息:若两个基因在几千个单细胞或时间点里总是同增同减,就给它们连一条边。这类方法快、说明直觉,但"共变"不等于"因果调控",大量边只是相关而非驱动。进阶法子用伪时序信息判断先后:若 A 先变、随后 B 跟着变,说"可能 A 驱动 B"就更站得住。发育里著名的骨架型 GRN 案例是把"细胞要不要进入神经命运"的一小撮转录因子的互锁表达焊成图谱——那正是第 3 章命运决定背后那张回想图。
可执行的动态:ODE 模拟"梯度读出位置"
网络是静态的"线路图",真正的发育是动态的。把节点当成浓度变量,边变成"+/- 影响",直觉就走进了微分方程:多少表达被自身降解、被激活着抬升、被抑制者压下去。下面这个例子浓缩了几乎所有形态发生素模型的精髓:一个信号 S 的浓度沿胚胎某轴呈梯度分布,一个靶基因 T 被 S 浓度依赖地打开。我问的问题是:给定 S 梯度,T 的稳定态高/低能不能按位置被可靠判读?
import numpy as np # 靶基因 T 动态:dT/dt = 基础激活 + 信号依赖激活 - 降解 deg, base, hill, half, n = 0.1, 1.0, 5.0, 0.5, 3.0 grid = np.linspace(0, 1, 41) # 沿轴的41个位置 S = np.exp(-grid / 0.3) # 形态发生素:前端高、后端低(指数衰减) def dTdt(T, S): act = hill * (S ** n) / (S ** n + half ** n) # Hill 函数:浓度到打开开关的软硬化 return base + act - deg * T def steady(T0, S, steps=4000, dt=0.01): T = T0 for _ in range(steps): T += dTdt(T, S) * dt return T print("位置 | 信号S | 靶基因稳态T (看T能否随S变化而分段拉平)") for i in [0, 5, 12, 20, 30, 40]: T_ss = steady(1.0, S[i]) print(f"{grid[i]:5.2f} | {S[i]:.3f} | {T_ss:5.2f}")
跑完你会看到:信号 S 从前到后是光滑衰减的,可靶基因 T 的稳定态却被 Hill 函数的"台阶"拉成了"该的高就高、该的低就低"的两档——这就是梯度→离散身份的开关机制。它解释了为什么平滑的 morphogen 信号能在胚体里读出一格一格互斥的细胞命运(第 2 章体节、第 4 章背腹分区都是这套逻辑)。真实模型还要加时间窗、邻居抑制(Notch 那一类),但"Hill 陡化 + 降解取稳态"已经抓住最内核的形状。
模拟的边界:要诚实
模型会自动告诉你"如果……会怎样",但它给的是"在你写下的方程里会怎样"。风险在于方程本身来自假设、参数常常拿不到实测值、且只收录了主要因子。一个好的模型工作从不声称"全对",只声称"在给定机制下,观测可以得到合理解释,且某参数如果偏离某范围,行为会崩"——分析那种崩溃点,本身就是发现。发育计算里 "反事实模拟"(若是少了某抑制子会如何)尤其常用,因为它可以在不打基因的情况下,先预言敲除的表型。
⚠️ 常见坑:把"模拟吻合"当"证明"。模型吻合只说明它的机制与观测兼容,不排斥其它机制。要区分"解释力"与"排他性",得靠预测那种可被新实验唯一检验的差异。
和全书的关系
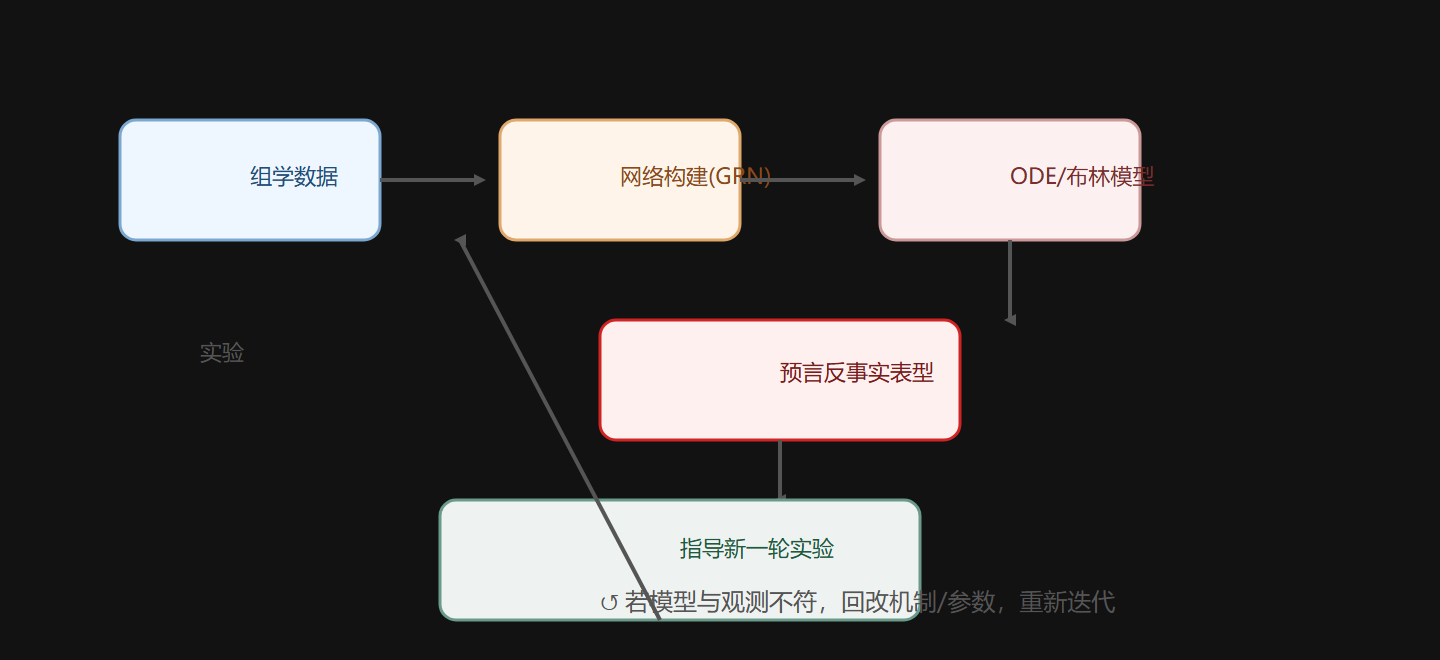
第 2 章的形态发生素梯度、第 3 章的信号互锁与 Notch 横向抑制、第 6.4 节行星尺度数据——都是计算建模的原料与考场。反过来,模型提出的可测预言,又指导下一轮组学实验抓哪些时间点、敲哪个基因。数据喂给模型、模型归还假设、假设再催实验,这是发育研究技术最现代的一条闭环。
本节小结
- 统计 vs 机制:数据侧看"有什么",模型侧看"若如此会怎样",两者互补。
- GRN 构建:共表达/互信息给边,伪时序给方向,边是相关的候选而非铁证。
- Hill + 降解 = 梯度读数:平滑梯度能被陡化成离散身份,是命运决定的开关内核。
- 诚实边界:模拟=兼容性证据,不是证明;它擅长预言"反事实"表型。
- 闭环:数据→模型→预言→实验→数据,是计算与实验互咬的最前沿。
图 6-5 计算闭环:数据 → 网络 → 模型 → 预言 → 再实验