6.4 组学技术与高通量分析
6.4 组学技术与高通量分析
本节摘要:发育生物学想"看全一幅蓝图",过去只能一块块拼,现在用组学技术一次量出成千上万个细胞各自的分子状态。单细胞测序(scRNA-seq)把"细胞异质性"摊开成一张张相册,空间转录组学给它补回空间坐标,蛋白质组学再告诉你在转录之上还有一层更靠近功能的调控。本节用一个小 PCA + 聚类模拟,展示"从几万个细胞里自动分出细胞类型"是怎么算出来的。
本节目标
阅读完本节,你应当能够:
- 说明单细胞测序把"组织的平均表达"变成了什么、又牺牲了什么。
- 解释空间转录组学如何解决"细胞在哪"的信息。
- 指出转录组与蛋白质组两把尺度的落差意味着什么。
- 在你自己的数据里,复现"降维 → 聚类 → 注释细胞类型"这条标准流水线。
甲、把"平均值"打碎:单细胞测序为什么革命性
传统分子手段送来的是一锅"平均汤":拿一整块组织提 RNA,得到的是成千上万细胞的混合信号。里面如果混着一个稀有但关键的先祖干细胞,它的信号会被稀释到几乎看不见。单细胞测序的颠覆在于——它把酶切后的单个细胞分别加条形码、分别建库,测出"每个细胞自己的一套转录组"。异质性从"误差"变成了"数据",这正是细胞命运决定研究求之不得的:原肠胚那样一块在被不断重编程的细胞群,过去只能看到平均,现在能逐格看到谁在往哪条路走。
代价同样真实:每个单细胞的测序深度都远低于整盒测序,属于"稀疏高噪"数据;很多基因在单个细胞里常常一滴也测不到(常称"掉零")。所以后续所有分析,本质都是在跟稀疏和噪声角力。
乙、自动找细胞类型:降维与聚类流水线
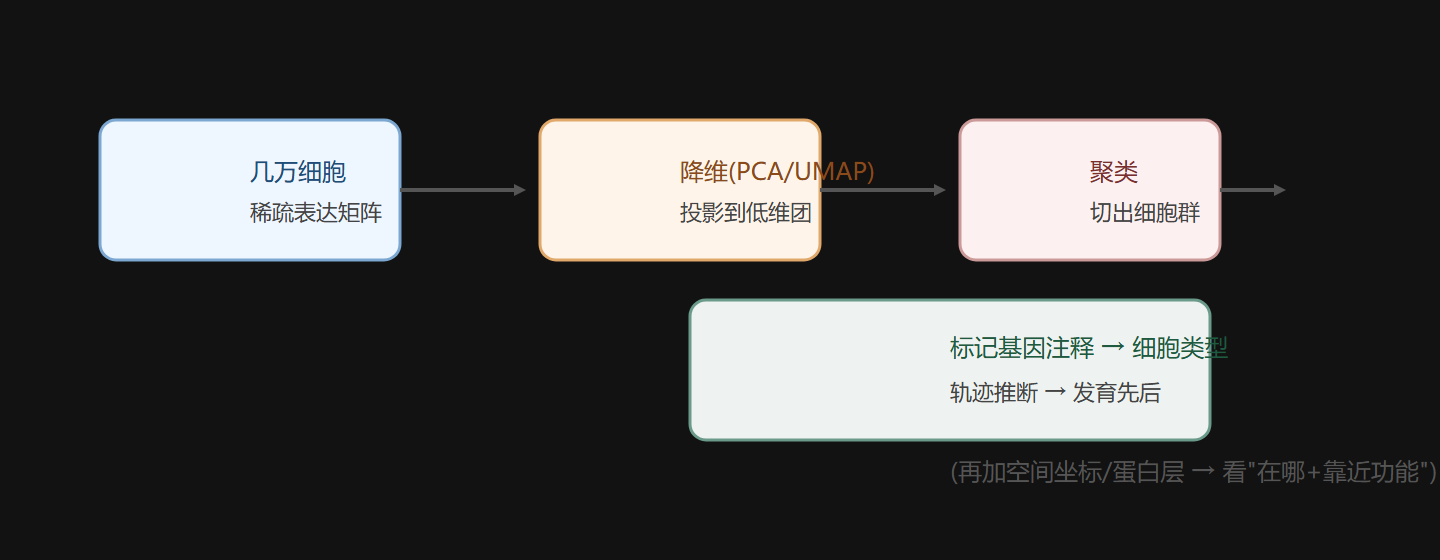
拿到几万个细胞的表达矩阵,麻烦是维度太高(上万基因)。好在高维空间里表达模式是"团"在一起的——同一命运、同一状态的细胞靠得近。于是标准套路是两步:先降维(PCA 把重复结构压缩成少数主成分,再落到 UMAP 看见平面上的"团"),再聚类(把团正式切出来),最后注释(看每个团里有哪些标记基因,给它贴上"什么细胞"的标签)。
我用一个很小的数值例子,把从"随机表达"到"长出三坨细胞"的过程演给你看——它复刻了最内核的计算(PCA 投影 + 简单聚类),只是把离群点、批次、深度差异这些真实世界的脏东西留给真实软件去处理。
import numpy as np from numpy.linalg import eigh rng = np.random.default_rng(0) n_cells, n_genes = 600, 50 types = [0]*200 + [1]*200 + [2]*200 # 想看三种细胞类型(状态) types = np.array(types) X = rng.normal(0, 1, (n_cells, n_genes)) # 每类共享部分基因的偏移 offset = np.array([[1.0]*20 + [0]*30, [0]*10 + [1.0]*20 + [0]*20, [0]*20 + [1.0]*15 + [0]*15]) X = X + offset[types] # 1) PCA:取前2主成分 Xc = X - X.mean(axis=0) cov = Xc.T @ Xc / n_cells w, V = eigh(cov) order = np.argsort(w)[::-1] V2 = V[:, order[:2]] P = Xc @ V2 # 2) 简化聚类:把所有点投到第一个主成分上,再按大小分桶——看看能否区分三类 score = P[:, 0] # 模拟"标记基因"打分:真正软件看特定基因,这里直接看类别是否可分 for k in range(3): sub = P[types == k, 0] print(f"类型 {k}: 主成分1均值 {sub.mean():.2f} ± {sub.std():.2f}")
跑出来你会看到三个类型的均值在这一根轴上已经明显分开——这意味着即使不画平面图,单靠 600 个细胞、50 个基因、一次 PCA,三类"命运"就能粗略分出来。真实数据集里,这一步的升级版(UMAP + 层次聚类)每天在成千上万个发育谱系里被重复执行,目的始终一样:用数据的几何结构,反推细胞的发育身份。
💡 关键直觉:把"找细胞类型"想象成"在人流摊开的操场里找自然聚成的小圈子"——降维是戴上广角镜把拥挤的平面摊开,聚类是给每个圈子画界线。发育研究之所以依赖它,是因为命运决定往往藏在异质性里,而 Get 平均均值恰恰抹掉异质性。
丙、补回坐标:空间转录组学
但单细胞测序抛掉了空间。发育是"谁在哪个位置读哪个信号"的事件,坐标丢了,蓝图就少了半边。空间转录组学的菜单很宽:有的(如原位测序)逐点测出局域转录组再拼回切片;有的(如生成 barcode 阵列的平台)把切片印在有序的点阵上,让每格保留"它来自胚胎的哪一块"。于是你可以看到:一个基因的梯度不是只存在于理论上,而是真真切切铺在胚胎切片上,从高到低逐渐变化。第 2 章我们讲 morphogen 梯度是"相信会有"的,空间组学让你眼睁睁看到。
丁、转录之上还有一层:蛋白质组学
转录本到蛋白还要过翻译调控、降解调控。一个基因就算 mRNA 很多,蛋白未必多;而真正干活的是蛋白。蛋白质组学(质谱为主)测出细胞里最终攒下哪些蛋白、做了哪些修饰(如发育里关键词的磷酸化与泛素化,见第 3 章信号转导)。它灵敏度与覆盖率都低于 RNA 测序,单细胞分辨率也更难做,却逼近功能的真相。最能说明问题的是"转录-蛋白不一致":很多已知基因,mRNA 波动不大,蛋白却在不同细胞命运里天差地别。
戊、组学怎么和本册其它章节咬合
- 与第 3 章(细胞命运决定):单细胞轨迹推断(把细胞按"过渡状态"排序成拟时序)几乎成了"谁先谁后分化"的标准取证手段。
- 与第 5 章(再生):在再生的断肢/损伤肝里,用单细胞谱系追踪看祖细胞往哪条路走。
- 与第 7 章(演化发育):跨物种单细胞图谱比较同源细胞类型,把"蓝图只见"落到转录水平。
组学把"一个细胞在职某时点听到、正在执行什么"变成了一张张可下载的表。下一步我们谈这些数据怎么变成会推理的模型——那是生物信息学与计算建模的地盘。
本节小结
- 单细胞测序:把组织平均打碎成每个细胞自己的转录组,异质性成为数据。
- 降维聚类:PCA/UMAP 降维 + 聚类 + 标记基因注释,是找细胞类型的标准流水线。
- 空间转录组学:给转录组补回空间坐标,让分子梯度"看得见"。
- 蛋白质组学:落在转录之上,逼近功能真相,且常与 mRNA 不一致。
- 全书咬合:轨迹推断喂给第 3 章命运决定、第 5 章再生、第 7 章跨物种比较。
图 6-4 单细胞流水线:表达矩阵 → 降维 → 聚类 → 注释