5.1 经济数据与统计推断基础
5.1 经济数据与统计推断基础
本节摘要:经济数据是计量经济学的原材料。本节从数据类型入手,区分截面数据、时间序列数据和面板数据三大类别,追溯它们各自的历史来源和典型应用场景。在此基础上,介绍描述性统计和推断性统计的分工——前者概括"数据长什么样",后者回答"我们能从中得出什么一般性结论"。核心概念包括总体与样本、抽样分布、中心极限定理、假设检验和置信区间。
一段数字引发的问题
1933年,美国大萧条最深的谷底。联邦政府的统计体系几乎是一片空白——没有一个统一的失业率指标,没有一个标准化的GDP核算方法。时任商务部长胡佛曾在私人日记中写道,"我们像盲人一样摸索。"事实上,直到1934年西蒙·库兹涅茨向国会提交了第一份国民收入报告,美国才真正拥有了衡量经济总量的系统性数据框架。而此前,决策者只能依赖零散的铁路货运量、钢铁产量等间接指标来猜测经济的脉搏。
这个故事揭示了一个常被忽视的事实:经济学的"科学化"进程,在很大程度上依赖于数据的可得性和质量。没有数据,再高明的理论也只能停留在思辨层面。计量经济学之所以能在二战后迅速崛起,恰恰是因为这一时期各国政府大规模建设了统计体系,积累了前所未有的大量经济数据。
数据的三副面孔
经济学家面对的数据,大致可以归入三种类型。理解它们的区别,是选择正确分析方法的起点。
截面数据(Cross-sectional Data)是在同一时间点上,对多个个体(个人、家庭、企业、国家)的观测。比如2010年中国人口普查收集到的各省人口、收入、教育水平数据,就是典型的截面数据。它的特点是每个观测值之间通常相互独立,适合回答"不同群体之间有什么差异"这类问题。劳动经济学中大量使用的微观数据集,如中国家庭追踪调查(CFPS),本质上都是截面数据。
时间序列数据(Time Series Data)是对同一个体在不同时间点上的连续观测。道琼斯工业指数从1896年至今的每日收盘价,中国季度GDP从1992年至今的序列,都是时间序列数据。它最显著的特征是数据点之间往往存在相关性——今天的GDP和昨天的GDP不是独立的,这种"记忆"结构使得时间序列分析需要一套专门的方法。
面板数据(Panel Data)——也称为纵向数据(Longitudinal Data)——同时具有截面和时间两个维度。对中国30个省连续20年的GDP数据,就是一个典型的面板数据集:30个截面个体,每个有20个时间观测值,共600个数据点。面板数据的核心优势在于它允许研究者同时控制个体异质性和时间效应,这是纯截面数据或纯时间序列无法做到的。
这三类数据并非彼此排斥,而是各自适合不同的问题。要研究"教育是否提高收入",截面数据就够了(不同教育水平的人收入是否不同);要研究"GDP增长是否稳定",需要时间序列;要研究"各省的教育投入对经济增长的影响",面板数据最合适。
数据从哪来
经济数据的来源大致可以分为四类。第一是政府统计,这是最传统也最重要的来源。各国的国家统计局负责收集和发布宏观经济数据(GDP、CPI、失业率等)和部分微观数据(人口普查、经济普查)。中国的国家统计局体系建立于1952年,但真正完善是在改革开放之后。
第二是调查数据,由学术机构或政府部门专门组织的抽样调查。美国的Current Population Survey(CPS)自1940年开始,是失业率数据的主要来源。中国的中国家庭收入调查(CHIP)、中国家庭追踪调查(CFPS)、中国健康与养老追踪调查(CHARLS)等,都属于这一类。调查数据的好处是可以收集微观层面的详细信息,但成本高昂,且存在抽样误差和测量误差。
第三是行政数据,政府部门在执行公务过程中自然积累的数据。税务记录、社会保障数据、医疗报销数据等,覆盖面广、成本低,但可能缺乏研究者关心的某些变量。
第四是商业数据和新数据源,包括企业的交易记录、互联网行为数据、卫星遥感数据等。这类数据正在迅速改变计量经济学的研究格局——例如,利用夜间灯光的卫星数据来估计发展中国家的经济活动,这在十年前是不可想象的。
描述性统计:让数据"开口说话"
假设你拿到了一份包含1000个家庭收入的数据,第一件事做什么?不是急着跑回归,而是先"看看数据长什么样"。这就是描述性统计的职责。
集中趋势的度量是最基本的。均值(Mean)是所有观测值的算术平均,对极端值敏感。中位数(Median)是将数据从小到大排列后处于中间位置的值,对极端值更稳健。如果你的数据是上海市居民收入,均值可能因为少数高收入者而大幅高于中位数——这时中位数更能代表"典型居民"的收入水平。
离散程度的度量告诉你数据的"散开程度"。方差和标准差是最常用的指标,但极差(最大值减最小值)和四分位距也有用。一个标准差很大的数据集,意味着个体之间差异很大。
分布形状也不能忽视。偏度(Skewness)衡量分布是否对称,峰度(Kurtosis)衡量分布尾部是否"厚重"。很多经济数据——尤其是收入数据——呈明显的右偏分布,这意味着大多数人的收入集中在较低水平,少数人拉高了均值。
以上这些指标可以通过一个表格快速呈现:
| 指标 | 含义 | 对极端值的敏感性 |
|---|---|---|
| 均值 | 算术平均 | 高 |
| 中位数 | 中间值 | 低 |
| 标准差 | 平均偏离程度 | 中 |
| 偏度 | 分布对称性 | 中 |
| 峰度 | 尾部厚度 | 低 |
描述性统计看似简单,实则是任何计量分析的第一步。跳过它直接跑模型,无异于不做体检就开药方——你可能对数据的"健康状况"一无所知。
推断性统计:从部分到整体
描述性统计回答"样本数据长什么样",但研究者真正关心的是总体。我们手头的1000个家庭只是全国数亿家庭的极小一部分。如何从样本推断总体?这就进入了推断性统计的领域。
核心思想:抽样分布
推断性统计的基石是抽样分布(Sampling Distribution)的概念。如果我们从同一个总体中反复抽取样本,每次计算样本均值,这些样本均值本身会形成一个分布——这就是样本均值的抽样分布。
中心极限定理(Central Limit Theorem, CLT)给出了这个分布的性质:当样本量足够大时(通常认为n≥30即可),无论总体的分布是什么形状,样本均值的抽样分布都近似服从正态分布。这个定理是推断性统计的灵魂——它使得我们可以在不知道总体分布的情况下,利用正态分布的性质进行推断。
假设检验:一场"无罪推定"的游戏
假设检验的逻辑,和法庭审判惊人地相似。在法庭上,被告"无罪推定",除非有足够证据证明有罪。在假设检验中,我们设立一个零假设(Null Hypothesis, H₀),假定"没有效应"或"没有差异",然后用数据来检验它是否应该被推翻。
具体步骤是:首先设定零假设(比如"某政策的实施对收入没有影响")和备择假设("有影响"),然后计算一个检验统计量(如t统计量),看它在零假设下的概率有多大。如果这个概率——即所谓的p值(p-value)——非常小(通常小于0.05),我们就"拒绝零假设",认为数据提供了足够的证据支持备择假设。
需要特别指出的是,p值小于0.05并不等于"证明了备择假设为真",更不等于"效应很大"。它只是说,如果零假设是真的,那么观测到当前或更极端数据的概率不到5%。这是一个概率陈述,不是确定性结论。但长期以来,学术界对p值的过度崇拜催生了大量的"p值操纵"行为——通过不断调整模型设定、样本范围来获得"显著"结果。这个问题在2010年代引发了统计学的"可重复性危机"(Replication Crisis),至今仍在深刻影响着经济学和整个社会科学的研究实践。
置信区间:不确定性的量化表达
与假设检验相比,置信区间(Confidence Interval)提供了更丰富的信息。一个95%的置信区间告诉你:如果我们反复抽样,95%的区间会包含真实的总体参数。它同时给出了点估计(区间的中心)和精度估计(区间的宽度),比单纯的"显著"或"不显著"要好得多。
举个例子。假设我们估计某政策对收入的影响为每月增加500元,95%置信区间为(100元,900元)。这告诉我们两件事:第一,估计的效果是正的;第二,我们的估计精度有限——实际效果可能在100到900元之间。如果这个区间太宽,说明数据量不够或模型拟合不好,即使点估计很大,结论也不太可靠。
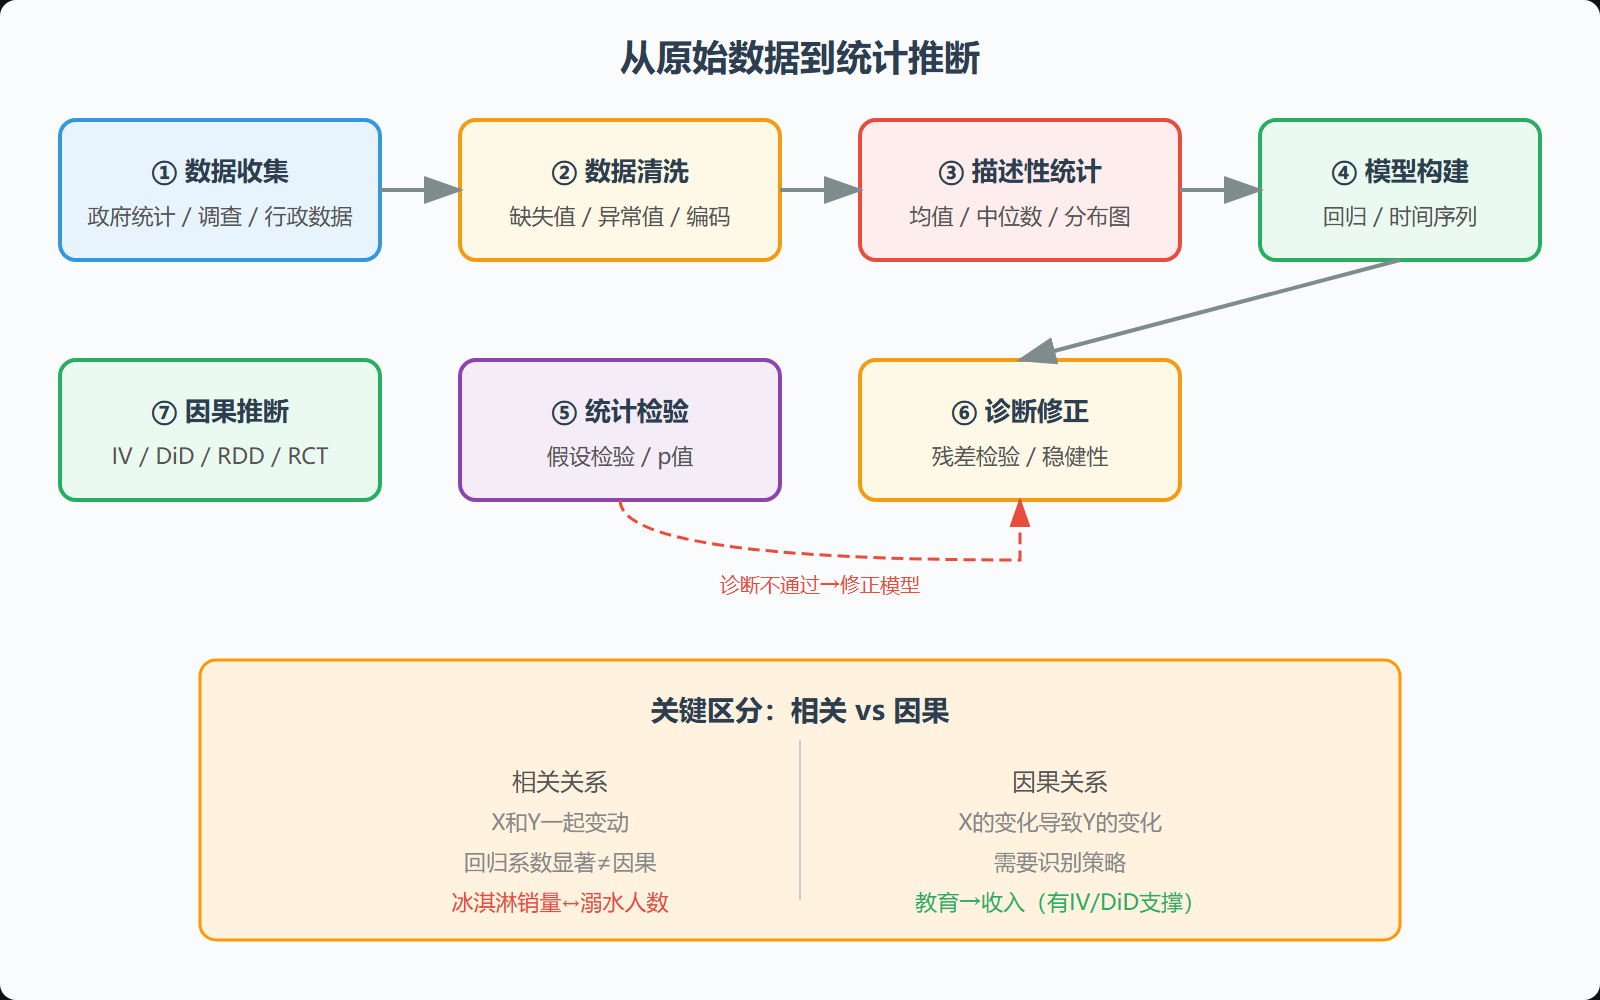
图:从数据到推断的完整流程
图1 经济数据分析的标准流程
重点提炼
- 经济数据三类型:截面数据(同一时点多个个体)、时间序列(同一个体多个时点)、面板数据(两者兼有)。选择正确的数据类型,是分析的第一步
- 数据来源多样:政府统计、抽样调查、行政记录、商业数据各有利弊。数据质量决定了分析的可靠性上限
- 描述性统计是起点:均值、中位数、标准差、分布形状——先看数据,再建模型
- 推断性统计的核心:中心极限定理使得从样本推断总体成为可能;假设检验是"无罪推定"式的概率推断;置信区间比p值包含更多信息
- p值的陷阱:p值不是因果关系的证明,更不是效应大小的度量。过度崇拜p值导致了社会科学的可重复性危机
- 相关≠因果:这是整个计量经济学最重要的一个提醒,也是下一节要深入展开的主题
下一节,我们将从统计推断的通用框架,进入计量经济学最核心的工具——回归分析,并直面那个最困难的问题:如何从数据中识别因果关系。