5.2 回归分析与因果推断
5.2 回归分析与因果推断
本节摘要:回归分析是计量经济学的核心方法,而因果推断是回归分析的终极挑战。本节从简单线性回归的原理讲起,解释普通最小二乘法(OLS)如何拟合数据、经典假设为何重要,以及假设被违反时会出现什么问题。随后重点讨论内生性——回归分析中最棘手的难题——的三大来源(遗漏变量、逆向因果、测量误差),并逐一介绍经济学家为解决内生性问题而发展出的工具变量法、双重差分法、断点回归设计和随机对照试验。
一个令初学者困惑的结果
假设你收集了100个城市的数据,发现消防站数量与火灾损失金额之间呈显著正相关:消防站越多的城市,火灾损失越大。回归分析会给你一个"显著为正"的系数。结论是消防站导致了更多火灾?
显然不是。真正的关系是:城市规模越大,火灾越多,因此也需要更多消防站。这里,"城市规模"是一个遗漏变量(Omitted Variable)——它同时影响消防站数量(解释变量)和火灾损失(被解释变量),使得你观测到的相关关系偏离了真实的因果关系。这是计量经济学中最经典的内生性问题之一,也是最容易被忽略的陷阱。
普通最小二乘法:最朴素的拟合思想
在深入因果推断的复杂世界之前,我们先理解回归分析的基本原理。
简单线性回归的模型可以写成:
Y = β₀ + β₁X + ε
其中Y是被解释变量,X是解释变量,β₀是截距,β₁是斜率系数,ε是随机误差项。我们想找到β₀和β₁的值,使得模型预测值和实际值之间的差距最小。
普通最小二乘法(Ordinary Least Squares, OLS)的选择准则是:最小化所有残差的平方和。也就是说,找到那条直线,使得所有数据点到这条线的垂直距离的平方和最小。这是一个纯粹的数学优化问题,有解析解——不需要迭代,一步就能算出来。
OLS估计量之所以被广泛使用,不仅因为计算简单,更因为高斯-马尔可夫定理(Gauss-Markov Theorem)提供了一个强有力的保证:在一系列经典假设(称为CLM假设)满足的前提下,OLS估计量是最佳线性无偏估计量(BLUE, Best Linear Unbiased Estimator)——在所有线性无偏估计量中,OLS的方差最小。
经典假设与它们的违反
CLM假设一共有五个。逐个理解它们,是理解计量经济学"什么会出问题"的关键。
假设一:线性于参数。模型设定必须是参数的线性组合。这不是说X和Y的关系必须是直线——如果真实关系是曲线,你可以加入X²作为新的解释变量。
假设二:随机抽样。样本是总体的随机代表。如果抽样存在系统性偏差(比如只用手机调查,漏掉了不用手机的老年群体),估计结果就会有偏差。
假设三:无完全多重共线性。解释变量之间不能完全线性相关。如果两个变量提供的信息完全一样,模型就无法分辨它们各自的影响。
假设四:条件零均值假设。误差项的条件期望为零,即E(ε|X) = 0。这意味着解释变量与误差项不相关。这是最核心也是最容易违反的假设——它一旦被违反,OLS估计量就是有偏的。
假设五:同方差假设。误差项的方差不随解释变量变化而变化。违反它不会导致估计量有偏,但会使得标准误的估计不准确,影响假设检验的可靠性。
这五个假设中,第四个假设的违反——也就是内生性(Endogeneity)——是最严重的问题,也是因果推断要解决的核心难题。
内生性的三大来源
内生性问题有三种主要来源,每种都值得仔细理解。
遗漏变量偏差(Omitted Variable Bias)。当你应该控制但没有控制某个变量Z,而Z同时影响X和Y时,OLS估计的β₁就混杂了X对Y的直接影响和Z通过X对Y的间接影响。回到消防站的例子,"城市规模"就是被遗漏的变量。解决思路要么是加入Z作为控制变量(如果数据里有),要么找到其他方法来消除Z的干扰。
逆向因果(Reverse Causality)。当你关心X是否影响Y,但实际上Y也可能影响X时,两者之间形成了一个反馈循环。研究"警察数量对犯罪率的影响"时,犯罪率高的城市可能也会增加警察数量——谁是因谁是果,单纯看数据根本分不清。这类问题在宏观经济学中尤其普遍,比如"投资与增长"、"货币供给与通胀"。
测量误差(Measurement Error)。当解释变量X存在测量误差时,它会"吸收"一部分误差项的方差,导致估计的系数向零偏移——这被称为衰减偏差(Attenuation Bias)。测量误差越小,问题越轻;但经济数据中测量误差几乎是不可避免的。
因果推断的四大策略
面对内生性问题,经济学家在过去半个世纪发展出了一套日益精巧的"武器库"。这些方法的核心思路都是同一个:想办法找到一种变异来源,使得X的变化确实只通过"我们关心的那个渠道"影响Y。
工具变量法(IV)
工具变量法(Instrumental Variables)是最经典的因果推断策略,由菲利普·赖特(Philip Wright)在1928年首次使用——他研究的是"需求曲线的识别"问题,用天气作为棉花价格的工具变量。
一个合格的工具变量Z必须满足两个条件:相关性——Z与内生解释变量X相关;外生性——Z不直接影响Y,也不与误差项相关。第一个条件容易验证,第二个条件往往是争议的焦点——你很难"证明"一个变量不直接影响Y。
经典的IV案例来自戴维·卡德(David Card)1993年的研究:他用个体出生地到最近大学的距离作为教育的工具变量,估计教育对收入的影响。逻辑是:住得离大学近的人更容易上大学(相关性),但上大学的机会本身并不直接影响收入(外生性依赖于"距离只通过教育影响收入"这个假设)。这个研究后来成为卡德获得诺贝尔经济学奖的重要贡献之一。
双重差分法(DiD)
双重差分法(Difference-in-Differences)是政策评估中使用最广泛的方法之一。它的思想非常直觉:比较政策实施前后,受政策影响的群体(处理组)和不受影响的群体(对照组)的变化差异。
假设某省在2015年提高了最低工资。你关心的是:提高最低工资是否减少了就业?简单比较2015年前后的就业率不够——全国经济形势的变化也会影响就业。DiD的巧妙之处在于引入一个不受政策影响的对照组省份,用它来"过滤掉"经济形势变化的影响,剩下的差异才归因于最低工资政策。
DiD方法的关键假设是平行趋势假设(Parallel Trends Assumption):在政策实施之前,处理组和对照组的就业率变化趋势应该是一致的。如果这个假设成立,那么政策实施后的趋势差异就可以被解读为政策的效果。
断点回归设计(RDD)
断点回归设计(Regression Discontinuity Design)利用的是政策的"门槛效应"。当某项政策的实施有一个明确的阈值(比如贫困线、分数线、年龄线),而阈值两侧的个体在其它方面几乎一样时,阈值附近就形成了一个"准实验"。
例如,中国的低保政策以收入作为资格门槛。年收入在贫困线以下的人享受低保,以上的人不享受。如果贫困线是每年3000元,那么年收入2999元和3001元的人在几乎所有方面都相似——唯一的区别是前者享受低保而后者不享受。比较这两类人的消费、健康等结果,就能识别出低保政策的效果。
RDD的核心优势在于它"几乎"是一个随机实验——如果你只看阈值附近的观测值,处理组和对照组是高度可比的。但它的局限在于只能估计阈值附近的"局部"效应(Local Average Treatment Effect),不能直接外推到所有人。
随机对照试验(RCT)
随机对照试验(Randomized Controlled Trials)是因果推断的"金标准"。通过随机分配处理,确保处理组和对照组在所有可观测和不可观测的方面都(在期望意义上)相同,从而精确地识别因果效应。
RCT在医学领域已经使用了数百年,但在经济学中的大规模应用是2000年以后的事。麻省理工学院的阿比吉特·班纳吉(Abhijit Banerjee)、埃丝特·迪弗洛(Esther Duflo)和哈佛大学的迈克尔·克雷默(Michael Kremer)正是因为在发展经济学中开创性地运用RCT评估扶贫政策效果而获得了2019年诺贝尔经济学奖。
RCT在经济学中的应用主要集中于微观发展领域——评估某个具体教育项目是否有效、某种化肥推广方案是否提高产量、小额信贷是否真的帮助了穷人等。它的局限在于:成本高昂、伦理约束(你不能随机让一些人失业)、实施困难(很多政策无法随机分配),以及外部有效性问题(在一个地区有效的政策,换个地方未必管用)。
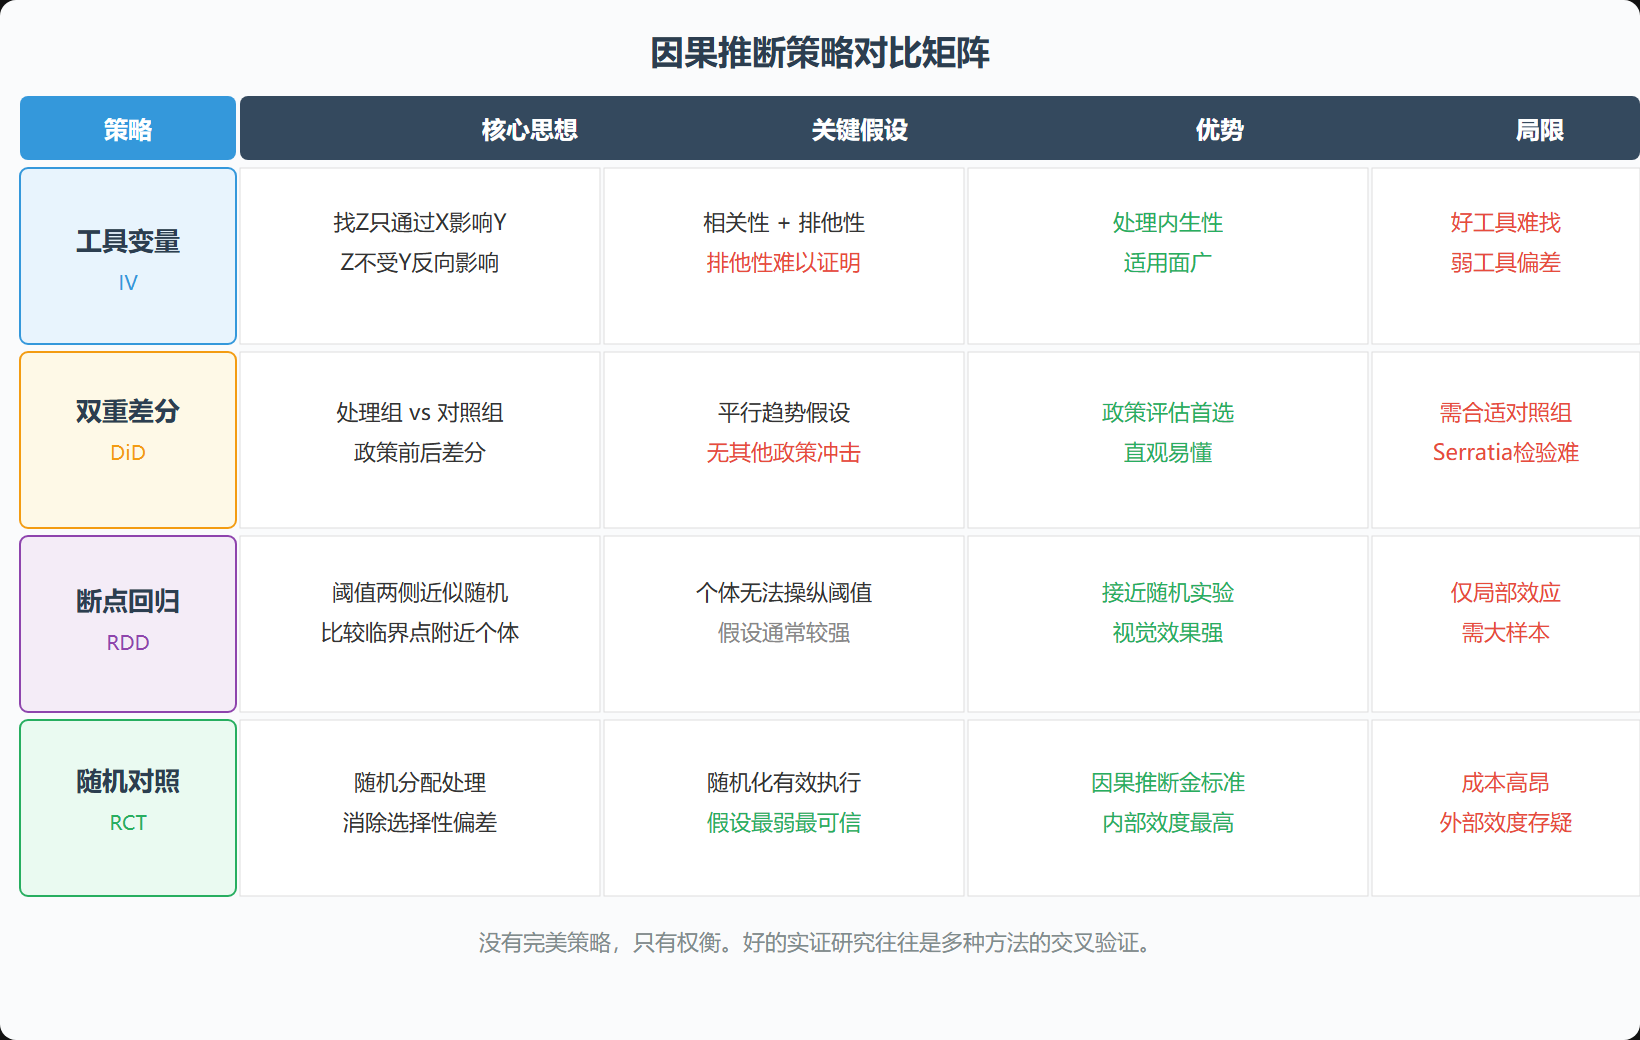
图:因果推断策略对比矩阵
图2 四大因果推断策略的比较
OLS回归结果的解读
在实证研究论文中,回归结果通常以表格形式呈现。理解表格中每一列的含义,是读懂计量经济学论文的基本功。
一个典型的回归表包含:被解释变量名称、每个解释变量的系数估计值(通常保留2-3位小数)、标准误或t值(括号内)、显著性星号(1%、5%、10%分别用***、**、*表示)、样本量(N)和拟合优度(R²)。系数的符号告诉我们影响方向,大小告诉我们影响程度,星号告诉我们这个估计在统计上是否显著。
但请注意:表格中的数字只是起点。真正重要的是表格背后的识别策略——研究者是如何确保估计出的系数反映了因果关系而非单纯的统计关联。一篇好的计量论文,花在讨论识别策略上的篇幅,往往比花在报告数字上的篇幅多得多。
本章回顾
- OLS是出发点:最小二乘法通过最小化残差平方和来估计系数,在高斯-马尔可夫假设下具有最优性质
- CLM五大假设:线性、随机抽样、无完全共线、条件零均值、同方差。其中条件零均值假设的违反(内生性)最致命
- 内生性三来源:遗漏变量、逆向因果、测量误差,每一种都会导致OLS估计有偏
- 四大因果推断策略:工具变量找"只通过X影响Y的外生冲击",双重差分比较处理组对照组的前后变化,断点回归利用政策的门槛效应,随机对照试验则直接随机化——每种方法都有其适用场景和局限
- 没有精确的策略:好的实证研究往往用多种方法交叉验证同一个结论,以提高结论的可信度
下一节,我们将把视野扩展到两类更具复杂性的数据结构——时间序列数据和面板数据,看看当数据具有时间维度时,计量分析需要应对哪些额外的挑战。