5.3 时间序列与面板数据分析
5.3 时间序列与面板数据分析
本节摘要:许多经济数据天然具有时间维度——GDP按季发布、股价按日变动、通胀按月统计。时间序列分析的核心挑战在于数据点之间的依赖结构:今天的数值和昨天不是独立的。面板数据则同时包含个体差异和时间变化,允许研究者控制不可观测的个体异质性。本节介绍时间序列的平稳性概念、ARIMA建模基本思路,以及面板数据的固定效应和随机效应模型。
那条永远向上的线,真的会继续向上吗?
1987年10月19日,星期一。道琼斯工业指数在一天之内暴跌22.6%,创下史上最大单日跌幅。此前一年,指数已经从1700点涨到了2700点。如果一位分析师只看时间序列的上升趋势,而不考虑序列的波动结构、均值回归特性以及外部冲击的可能性,他可能会做出"股市会一直涨下去"的危险判断。
这个故事指向时间序列分析的一个核心教训:时间序列数据中的"趋势"和"规律"往往是幻觉——不是数据本身在说谎,而是我们的大脑天生倾向于在随机波动中寻找模式(这是行为经济学中确认偏误的一个例证)。要避免这种幻觉,我们需要严谨的统计工具来判断:一个时间序列中的模式究竟是"真实存在的"还是"偶然产生的"。
时间序列的特殊挑战
与截面数据相比,时间序列数据有几个独特的问题需要特别处理。
自相关(Autocorrelation)是最基本的特征。今天和昨天的GDP不是独立——它们高度相关。这使得标准误差的计算需要修正,否则假设检验会严重失真。自相关并不总是问题——有时它本身就包含了有价值的信息(比如经济波动的持续性)。
非平稳性(Non-stationarity)是一个更深层的问题。如果一个时间序列的均值或方差不随时间保持恒定,它就是非平稳的。大多数宏观经济变量(GDP、物价水平、货币供给)都表现出明显的趋势,因而是非平稳的。对非平稳序列直接做回归,可能导致伪回归(Spurious Regression)——两个毫无关系的非平稳序列之间也会呈现"显著"的统计关系。格兰杰和纽博尔德在1974年的著名论文中首次系统性地揭示了这个问题:如果你对两个独立的随机游走序列做回归,t值会"显著"的概率远高于5%。
季节性(Seasonality)也值得注意。消费数据在春节前后的波动、农业产量随季节变化、用电量在冬夏两季的峰值,都是季节性效应。忽略季节性会扭曲我们对"真实趋势"的判断。
平稳性检验:ADF检验
判断一个时间序列是否平稳,最常用的方法是增广迪基-福勒检验(Augmented Dickey-Fuller Test, ADF检验)。它的零假设是"序列存在单位根"(即非平稳)。如果ADF检验拒绝了零假设,我们才有信心认为序列是平稳的。
实务中,我们经常通过差分来使非平稳序列变为平稳。一阶差分后如果变得平稳,就称原序列为"一阶单整"序列,记为I(1)。GDP通常是I(1)序列,而GDP的增长率(即差分后的序列)通常是平稳的。
ARIMA模型:时间序列的"语法"
ARIMA(Autoregressive Integrated Moving Average)模型是时间序列分析中最经典的单变量模型,由乔治·博克斯和格威利姆·詹金斯在1970年代系统化。ARIMA(p,d,q)中的三个参数分别代表:
- AR(p):自回归阶数p——当前值依赖于过去p期的值。AR(1)模型意味着今天的值主要由昨天的值决定,加上一个随机冲击
- I(d):差分阶数d——需要差分d次才能使序列平稳。I(1)意味着做一阶差分
- MA(q):移动平均阶数q——当前值依赖于过去q期的随机冲击。MA(1)模型意味着今天的值受昨天随机冲击的影响
ARIMA模型的建模过程通常遵循博克斯-詹金斯的三步法:识别(通过自相关图和偏自相关图判断p和q)、估计(用最大似然法估计参数)、诊断(检验残差是否为白噪声)。如果诊断不通过,就回到识别阶段重新选择参数。
ARIMA模型的局限在于它是单变量的——它只用序列自身的过去值来预测未来值,不考虑其他变量的影响。如果关心"货币供给变化对GDP的影响",就需要用到多变量模型,如向量自回归(VAR, Vector Autoregression)模型。VAR模型由克里斯托弗·西姆斯在1980年提出,它把多个时间序列放在一起,让每个变量都被自己和其他变量过去值的线性函数所解释。西姆斯因此获得了2011年诺贝尔经济学奖。
协整:长期关系的发现
如果两个非平稳序列之间存在一个稳定的线性组合使得该组合是平稳的,我们就说这两个序列是协整(Cointegrated)的。协整的概念由克莱夫·格兰杰和罗伯特·恩格尔在1987年系统提出。
协整的经济直觉是:虽然两个序列各自都是"随机游走"(没有明确的趋势回归),但它们之间存在某种"引力",使得二者不会永远偏离彼此。例如,消费和收入虽然各自都在增长,但消费占收入的比例通常在一个相对稳定的范围内波动——二者就是协整的。格兰杰和恩格尔因为这项工作获得了2003年诺贝尔经济学奖。
协整检验(如恩格尔-格兰杰两步法、Johansen检验)在实证研究中被广泛应用于检验经济学理论中"长期均衡关系"的存在——比如购买力平价理论(汇率与物价水平之间的关系)、货币数量论(货币供给与物价之间的关系)等。
面板数据:同时看到"谁"和"什么时候"
面板数据的核心优势在于它同时利用了截面维度和时间维度的信息。这使得研究者可以做纯截面数据或纯时间序列数据做不到的事情——控制不可观测的个体异质性。
一个直觉性的例子
假设你想研究"各省的教育投入是否促进了GDP增长"。如果你只有某一年的截面数据,你可能会发现教育投入高的省份GDP也高——但这也可能是因为沿海省份本来就经济基础好、教育投入也多。如果你只有全国的时间序列数据,你只能看"全国教育投入增加是否伴随着GDP增长"——但这可能只是同时受到经济周期的影响。
面板数据让你可以同时控制"省份特征"(比如是否沿海)和"时间效应"(比如2008年金融危机对所有省份的冲击)。在控制了这些因素之后,如果教育投入的变化仍然与GDP增长的变化显著相关,你的结论就更有说服力。
固定效应 vs 随机效应
面板数据模型有两个主要类别:固定效应模型(Fixed Effects, FE)和随机效应模型(Random Effects, RE)。
固定效应模型的思路是:为每个个体设置一个独特的截距项("固定效应"),用来捕获所有不随时间变化的个体特征。这相当于在做回归时"减去个体均值"——差分后,所有不随时间变化的因素都被消除了。这意味着,固定效应模型不能估计不随时间变化的变量(如性别、种族)的影响。
随机效应模型则假设个体效应是从一个分布中随机抽取的,作为误差项的一部分。它的参数估计更有效(标准误更小),但前提是个体效应与解释变量不相关。如果个体效应与解释变量相关(这很常见——比如能力高的人教育年限更长、收入也更高),随机效应的估计就会不一致。
豪斯曼检验(Hausman Test)用来在固定效应和随机效应之间做选择:如果检验拒绝了"随机效应模型与固定效应模型无显著差异"的原假设,就应该使用固定效应模型。在经济学实践中,固定效应模型被远比随机效应模型更广泛地使用,因为它的假设更弱、更不容易出错。
动态面板:当解释变量包含被解释变量的滞后项
有时候,我们关心的模型中被解释变量的过去值会影响当前值——比如"去年的GDP是今年GDP的重要预测因子"。这种模型叫做动态面板模型。它的一个问题是:被解释变量的滞后项作为解释变量,与固定效应误差项相关,导致标准的固定效应估计产生偏误。
阿雷拉诺-邦德估计量(Arellano-Bond Estimator)是解决这个问题的经典方法。它通过一阶差分消除固定效应,然后用滞后变量作为工具变量来处理内生性。这个方法在宏观经济学和金融学中有广泛应用。
图:面板数据分析方法决策路径
图3 面板数据分析方法的选择
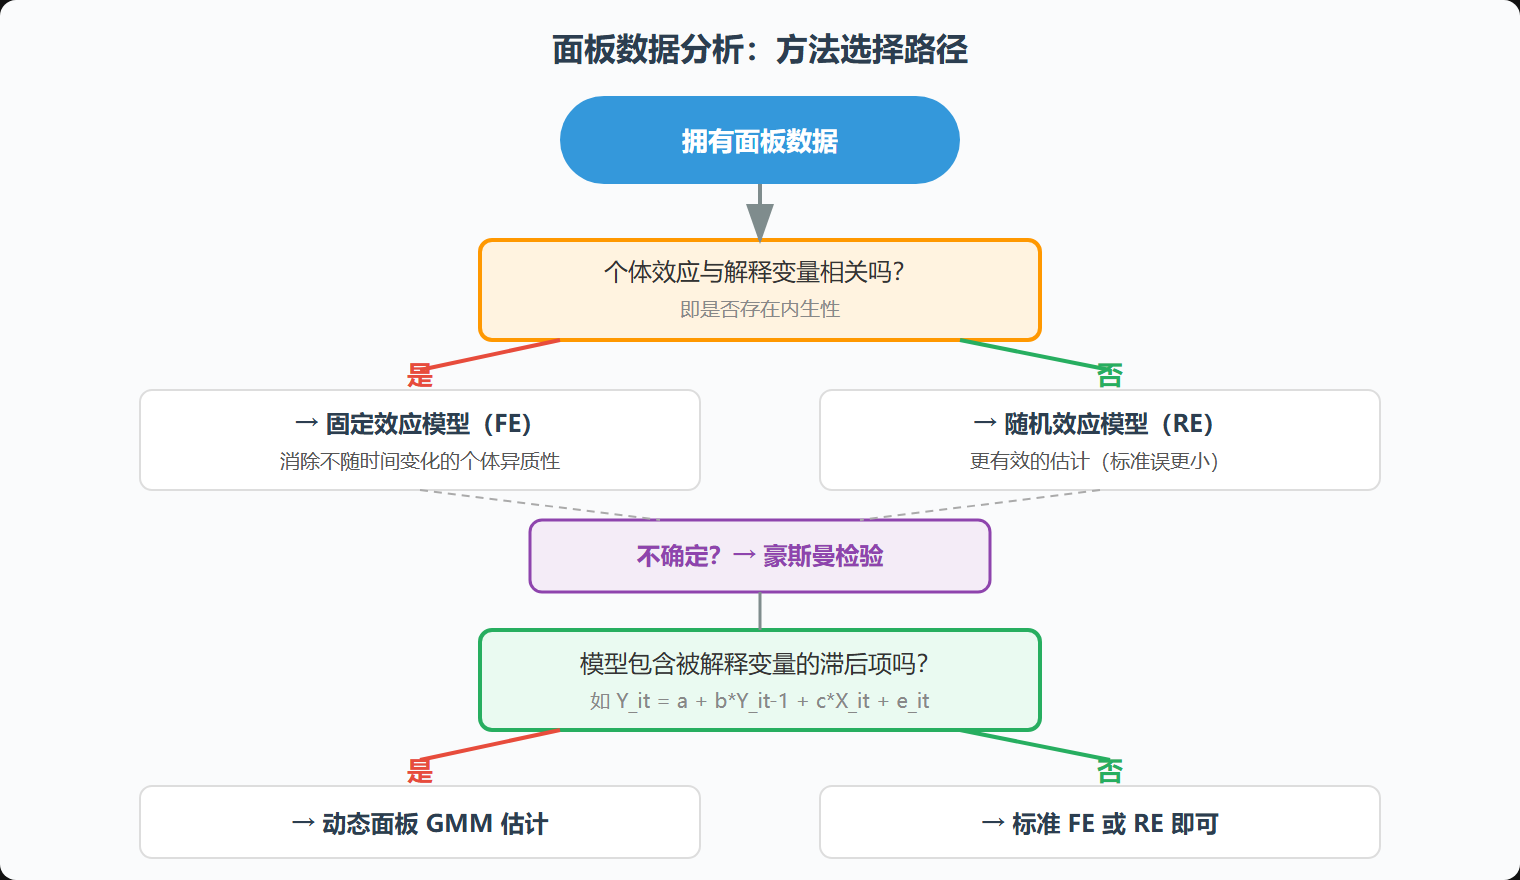
时间序列与面板数据在经济学中的应用
时间序列方法在宏观经济预测中占据着核心地位。各国央行、国际货币基金组织、经合组织等机构的短期经济预测,都大量依赖时间序列模型。VAR模型在分析货币政策传导机制时尤其重要——它可以回答"加息对通胀的影响路径是什么样的",通过脉冲响应函数(Impulse Response Function)来展示一个冲击如何随时间传播。
面板数据在发展经济学和劳动经济学中应用最为广泛。阿比吉特·班纳吉和鲁里埃尔·鲁宾尼(他们后来的诺贝尔奖研究)利用多国面板数据研究了民主与增长的关系;教育经济学中大量使用学生层面的面板数据追踪教育干预的长期效果;健康经济学则利用队列面板数据研究生活方式对健康的影响。
近年来,大数据和机器学习正在深刻改变时间序列和面板数据分析的实践。传统的ARIMA和VAR模型正在与神经网络、梯度提升等机器学习方法融合。例如,谷歌曾发表研究,利用搜索行为数据来预测流感疫情的时空传播——本质上就是对高维面板数据的一种新型分析。但这并不意味着传统方法过时了——当目标是"理解因果机制"而非"追求预测精度"时,传统方法因为其可解释性,仍然不可替代。
要点串联
- 时间序列的特殊性:自相关、非平稳性、季节性是三大核心问题。忽略自相关会扭曲标准误;忽略非平稳性可能导致伪回归;忽略季节性会混淆趋势和周期
- ADF检验与差分:检验序列是否平稳,通过差分使非平稳序列变为平稳,是时间序列建模的第一步
- ARIMA与VAR:ARIMA是单变量预测的经典框架;VAR用于多变量之间的动态关系分析,在货币政策研究中应用广泛
- 协整检验:检验非平稳序列之间是否存在长期稳定关系,是验证经济学"长期均衡"理论的实证工具
- 面板数据的优势:同时利用截面和时间维度,控制不可观测的个体异质性,这是纯截面或纯时间序列做不到的
- FE vs RE:固定效应假设个体效应与解释变量相关(假设弱但安全),随机效应假设不相关(假设强但更有效)。豪斯曼检验帮助选择
- 动态面板GMM:当模型包含被解释变量的滞后项时,标准FE产生偏误,需要使用GMM估计量
至此,第五章计量经济学的核心内容已经全部展开。从数据类型到统计推断,从回归分析到因果推断,再到时间序列和面板数据的高级方法——这套工具箱足以让你批判性地审视大多数经济学实证研究。但请记住:工具只是工具,好研究的关键不在于用了多么复杂的方法,而在于研究问题是否有价值、识别策略是否可信、数据质量是否过关。