3.2 数据准备与预处理
3.2 数据准备与预处理
本节摘要:模型吃什么决定它学会什么。本节讲清 NanoGPT 的数据流水线:数据来源选择(小文本起步)、分词(文本变 token)、切块(token 变训练样本)、二进制化(存储优化),以及"数据质量决定训练质量"的核心认知。
学习目标
阅读完本节,你应当能够:
- 选择合适的数据集起步
- 理解分词的作用
- 掌握训练样本的切块
- 理解二进制化的意义
- 判断数据是否适合训练
一、问题与直觉
"用什么数据训练?"——起步原则:小、干净、感兴趣。莎士比亚全集、某本小说、自己的文章集合,都是好起点。数据不追求大,追求"让模型学会有规律的语言"。数据流水线四步:文本 → token → 样本 → 二进制。
NanoGPT 自带一个最经典的入门数据集:莎士比亚戏剧(tinyshakespeare,约 1MB)。它的好处是体量小、风格鲜明、训练几分钟就能看出效果——几乎所有 NanoGPT 新手都从它起步。
二、核心原理
数据准备的四步主线:
2.1 数据流水线
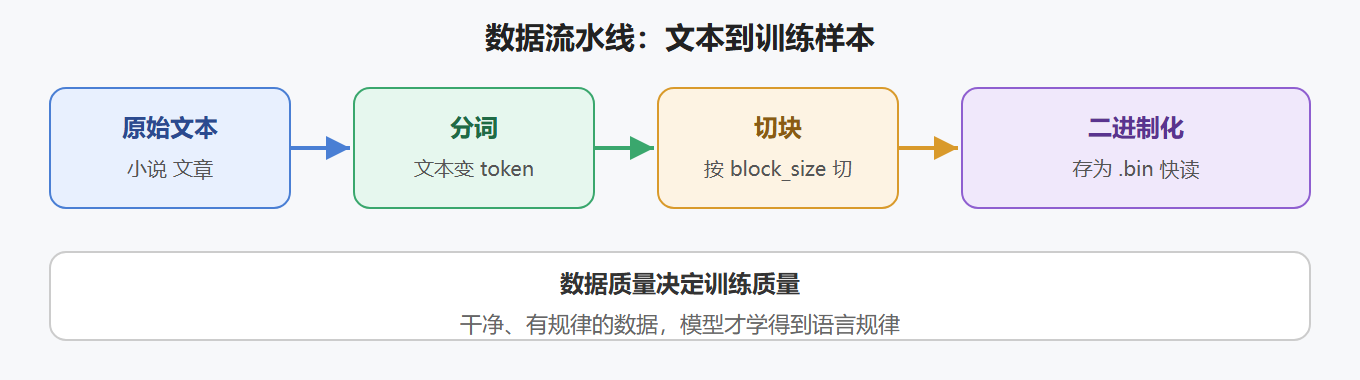
2.2 分词与切块
- 分词:把文本切成 token(词/子词),每个 token 对应一个整数 id
- 切块:把 token 序列按 block_size(如 256)切成训练样本——每个样本是一段上下文
NanoGPT 的莎士比亚示例用的是最简单的字符级分词:把 65 个不同字符(字母、标点、空格)各编一个号。虽然比 GPT-2 的 BPE 子词分词粗糙,但对 1MB 文本足够,且实现只有二十行——非常适合理解分词的本质。
💡 关键直觉:切块生成"无限"训练样本——一段文本每移动一个 token 就是一个新样本(预测下一个词)。所以少量文本也能训练不少轮次。
三、工程实践要点
3.1 准备莎士比亚数据
cd data/shakespeare python prepare.py
运行后目录里出现三个文件:
train.bin # 约 90% 文本的 token 序列(uint16 存储) val.bin # 约 10% 文本的 token 序列 meta.pkl # 词表与编码解码函数
train.bin 和 val.bin 是训练直接读的二进制数据,meta.pkl 里保存 vocab_size(65)等元信息。整个准备过程在笔记本上几秒钟完成。
3.2 字符级分词的核心代码
# prepare.py 的字符级分词思路(精简版) text = open("input.txt", encoding="utf-8").read() # 收集文本里所有不同的字符,按序编号 chars = sorted(list(set(text))) vocab_size = len(chars) # 莎士比亚数据是 65 stoi = {ch: i for i, ch in enumerate(chars)} # 字符 -> id itos = {i: ch for i, ch in enumerate(chars)} # id -> 字符 # 整段文本转成 id 序列 ids = [stoi[c] for c in text] # 划分训练/验证集(前 90% 训练,后 10% 验证) train_ids, val_ids = ids[:n], ids[n:]
理解这段代码,你就理解了所有分词器的共性:建立"文本片段 ↔ id"的映射,把文本变成整数序列。GPT-2 的 BPE 只是把"字符"换成"子词",思想完全相同。
3.3 二进制化与数据加载
# 保存为 uint16 数组,比文本小一半且读取更快 import numpy as np train_ids = np.array(train_ids, dtype=np.uint16) train_ids.tofile("train.bin") # train.py 里读取并切块 data = np.memmap("train.bin", dtype=np.uint16, mode="r") # 每次迭代随机取一个起点,切出 [block_size+1] 长度的样本 ix = torch.randint(len(data) - block_size, (batch_size,)) x = torch.stack([torch.from_numpy(data[i:i+block_size].astype(np.int64)) for i in ix]) y = torch.stack([torch.from_numpy(data[i+1:i+1+block_size].astype(np.int64)) for i in ix])
注意 x 和 y 的构造:x 是"当前位置的 token",y 是"下一个位置的 token"——两者错开一位,正好对应"预测下一个词"的任务。这是 NanoGPT 数据加载里最巧妙的几行。
3.4 数据选择标准
| 标准 | 说明 |
|---|---|
| 干净 | 无乱码、无大量重复 |
| 有规律 | 语言规范(小说、文章) |
| 规模合适 | 起步几 MB 到几十 MB |
| 感兴趣 | 便于观察生成效果 |
⚠️ 常见坑:一上来用海量数据。数据越大训练越久,调参越慢——起步用"能快速跑完"的小数据集,验证流程通了再换大数据。
3.7 数据质量的三道检查
准备数据时,花五分钟做三道检查能省下大量排错时间:
第一道:文本可读吗?乱码、HTML 标签、爬虫残留要去掉 第二道:长度合理吗?空文件、超短文件说明下载或切分有问题 第三道:分布正常吗?训练/验证比例、字符集是否和预期一致
一个典型的反面案例:从网页抓的文本带着大量 HTML 标签,模型学会了生成尖括号而不是语言。清洗数据永远是训练前最划算的投资。
3.8 中英文数据的差异
换中文数据时,有几处和英文不同的地方要注意:
| 差异点 | 说明 |
|---|---|
| 字符集更大 | 常用汉字几千个,字符级词表远大于 65 |
| 分词选择 | 字符级可用但低效,建议用 BPE 或现成分词器 |
| 编码统一 | 必须统一为 UTF-8,否则乱码 |
| 数据量需求 | 中文信息密度高,起步可更小数据量 |
NanoGPT 官方示例主要是英文,但社区有大量中文数据的 prepare 脚本可参考。核心思路不变:文本 → token → 样本 → 二进制。
3.5 验证数据正确性
打印前几行 token 与对应文本 确认长度与 block_size 匹配 确认训练/验证集比例合理
一个实用的验证方法是把 id 序列解码回文本,看是否还原:
# 用 meta.pkl 里的 itos 把 id 序列还原成字符串 print("".join([itos[i] for i in train_ids[:200]]))
输出应该是正常的莎剧台词。如果出现乱码或错位,多半是分词映射或文件读写出了问题。
3.6 自定义数据的步骤
想换自己的文本,只需三步:把文本放成 input.txt,复制一份 prepare.py 逻辑,运行生成 bin 文件。需要注意编码统一为 UTF-8,否则中文字符会变成乱码 id。
本节速览
- 要点一:数据流水线——文本、分词、切块、二进制化
- 要点二:起步用"小、干净、感兴趣"的数据
- 要点三:切块让少量文本产生大量样本
- 要点四:二进制化为了训练时快读
- 要点五:数据质量决定训练质量
- 要点六:先小数据跑通,再换大数据
数据准备好了,下一节启动引擎——模型训练与微调流程。