3.3 模型训练与微调流程
3.3 模型训练与微调流程
本节摘要:数据就绪,启动训练。本节讲清 train.py 的训练流程(数据加载 → 前向反向 → 周期评估 → 保存检查点)、训练日志怎么看、以及"微调"在 NanoGPT 里的两种含义(继续训练与领域适配)。
本节目标
阅读完本节,你应当能够:
- 说出 train.py 的核心流程
- 看懂训练日志
- 理解检查点的作用
- 掌握微调的两种方式
- 判断训练是否正常
一、问题与直觉
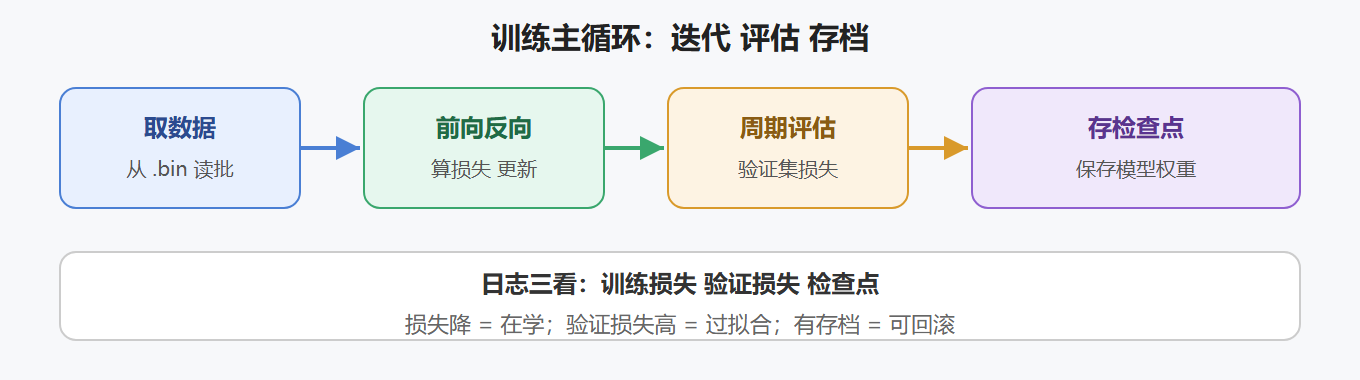
"训练跑起来了,然后呢?"——盯着日志看三样:损失在不在降、验证损失高不高、检查点存没存。训练不是"点了就跑",是"边跑边判断、及时干预"。看懂这三个信号,你就掌握了训练的控制权。
NanoGPT 的 train.py 把训练循环写得非常直白:数据迭代器、前向反向、周期评估、保存检查点。读懂它,等于读懂了所有 PyTorch 训练脚本的骨架。
二、核心原理
训练与微调是一条主线:
2.1 训练流程
2.2 训练主循环的核心代码
# train.py 主循环(精简结构) for iter_num in range(max_iters): # 取一批数据(支持梯度累积) x, y = get_batch("train") logits, loss = model(x, y) # 反向传播:梯度累积时先把损失除以累积步数 if gradient_accumulation_steps > 1: loss = loss / gradient_accumulation_steps loss.backward() if (iter_num + 1) % gradient_accumulation_steps == 0: # 梯度裁剪后更新参数 torch.nn.utils.clip_grad_norm_(model.parameters(), grad_clip) optimizer.step() optimizer.zero_grad(set_to_none=True) # 更新学习率(warmup + 余弦衰减) lr = get_lr(iter_num) for param_group in optimizer.param_groups: param_group["lr"] = lr # 周期性评估验证集损失 if iter_num % eval_interval == 0: val_loss = evaluate(model, "val") print(f"iter {iter_num}: loss {loss.item():.4f}, val loss {val_loss:.4f}") # 保存检查点 if iter_num % save_interval == 0: torch.save({"model": model.state_dict(), "config": cfg}, "ckpt.pt")
这份代码浓缩了训练的全部关键机制:梯度累积、梯度裁剪、学习率调度、周期评估、检查点保存。看懂它,任何训练脚本都大同小异。
2.3 微调的两种含义
| 含义 | 做法 | 场景 |
|---|---|---|
| 继续训练 | 加载检查点继续跑 | 没训够 |
| 领域适配 | 换数据接着训 | 换语料风格 |
三、工程实践要点
3.1 训练命令
python train.py config/train_shakespeare.py # 小数据集起步 python train.py config/train_gpt2.py # 124M 复现配置
启动后能看到类似日志:
iter 0: loss 4.1872, iter time 63.56ms iter 100: loss 3.4512, val loss 3.4821 iter 200: loss 2.7318, val loss 2.8644 iter 300: loss 2.3185, val loss 2.5033 iter 400: loss 2.1042, val loss 2.3102 iter 500: loss 1.9877, val loss 2.1988
损失从 4.17(均匀猜测的熵)一路下降,说明模型在真实学习。验证损失略高于训练损失是正常的;如果验证损失不再下降甚至回升,就要警惕过拟合。
💡 关键直觉:起步永远用小配置——莎士比亚数据集 + 小模型,几分钟跑一轮,验证流程比追求效果重要。
3.2 训练日志怎么看
iter 100: loss 4.2, val loss 4.3 iter 200: loss 3.8, val loss 3.9 ← 都在降,健康 iter 300: loss 3.5, val loss 3.8 ← 训练降验证升,过拟合信号
3.3 微调的操作
# 继续训练:指定初始权重 # python train.py config/train_shakespeare.py --init_from=resume # 领域适配:换数据集后从预训练权重继续 # python train.py config/train_shakespeare.py --init_from=resume --dataset=my_data
NanoGPT 的 --init_from 支持三种来源:scratch(从零初始化)、resume(从检查点继续)、gpt2(加载官方 GPT-2 权重)。领域适配的典型用法是加载 gpt2 权重,再换成自己的语料微调。
3.4 检查点里有什么
# 保存的 ckpt.pt 是一个字典,包含: # model: 完整模型状态字典(所有权重) # optimizer: 优化器状态(继续训练时保持动量) # model_args: 模型配置参数 # iter_num / best_val_loss: 训练进度 # config: 本次训练的全部配置
理解检查点的结构很重要:resume 能续上训练,靠的就是把 optimizer 状态和进度一起保存。只保存权重的话,动量信息丢失,续训效果会打折扣。
⚠️ 常见坑:微调用太大学习率。从已有权重继续训练,学习率要调小——不然会把已学到的知识冲掉。参照第 2 章"微调 = 小幅调整"的直觉。
3.5 训练异常排查
| 现象 | 原因 | 处理 |
|---|---|---|
| 损失 NaN | 学习率过大 | 调小学习率 |
| 损失不降 | 数据/配置问题 | 检查数据与配置 |
| 验证损失升 | 过拟合 | 早停或加正则 |
| OOM | 批次太大 | 降批次 |
3.6 训练监控的三个指标
训练日志里最有价值的是三个数字的组合:
| 指标 | 看什么 | 异常信号 |
|---|---|---|
| 训练损失 | 是否持续下降 | 平台期或反弹 |
| 验证损失 | 是否泛化 | 与训练差距拉大 |
| 每步耗时 | 效率是否正常 | 突然变慢 |
建议用一张表格记录关键节点:第 0 步、1/4 处、1/2 处、结束。四个点的损失连起来,就是这次训练的"心电图"。
3.7 检查点恢复的正确姿势
中断后恢复训练,要点是带上完整的检查点:
# 保存时:model + optimizer + 进度都在 ckpt.pt 里 # 恢复时: python train.py config/train_shakespeare.py --init_from=resume
如果只保存了模型权重,恢复后优化器动量归零,学习率也从零重新调度,训练曲线会跳变。所以正式实验务必保存完整检查点。想从官方 GPT-2 权重开始微调,则用 --init_from=gpt2,此时会自动从网上下载对应权重。
3.8 多卡训练时的日志理解
用 torchrun 跑多卡时,日志里会出现 DDP 相关输出。NanoGPT 会打印"总批次"而非单卡批次,注意分辨:
total batch size: 3840 # 8 卡 × 12 × 40 累积,这是真实有效批次
有效批次越大,学习率通常也要按比例放大——这和第 4 章的优化策略是呼应的。
重点提炼
- 要点一:训练循环——取数、前向反向、评估、存档
- 要点二:日志三看——训练损失、验证损失、检查点
- 要点三:微调 = 继续训练或领域适配
- 要点四:微调要小学习率,防冲掉已学知识
- 要点五:起步用小配置跑通流程
- 要点六:训练异常看损失定位
训练会了,下一节收获成果——文本生成与采样。